免费大模型API服务商合集
本文整理了亲测好用的免费大模型API服务商,包括Nvidia NIM、火山方舟、openrouter和Google AI Studio。文章详细介绍了各平台的注册方式、免费额度策略及支持的模型(如DeepSeek、GLM-4.7等),并提供了相关链接,为开发者寻找低成本AI模型调用方案提供了实用指南。
本文整理了亲测好用的免费大模型API服务商,包括Nvidia NIM、火山方舟、openrouter和Google AI Studio。文章详细介绍了各平台的注册方式、免费额度策略及支持的模型(如DeepSeek、GLM-4.7等),并提供了相关链接,为开发者寻找低成本AI模型调用方案提供了实用指南。
作者针对微信个人号无法直接接入开源 AI Agent 项目 OpenClaw 的痛点,耗时两天开发了一款开源工具。该项目采用 iPad 协议和消息中转架构,解决了稳定性与风控问题。接入后,用户可在微信中实现文章总结存入知识库、群聊上下文总结、日程提醒及多模型智能交互,极大提升了个人效率。
本文深入解读了 Anthropic 官方发布的 Claude Skills 构建指南。文章指出,Skills 允许用户将重复的指令、工作流和规范打包成文件夹,让 Claude 学会并长期复用。核心结构包含 SKILL.md 说明书及可选资源。文中详细介绍了三层加载机制、三大典型用法(文档生成、流程自动化、MCP 增强)以及从零创建 Skill 的实操建议,旨在通过封装经验提升 AI 交互效率。
本文记录了 xAI 全员大会的详细内容,展示了公司在成立仅两年半后,在语音、图像生成和预测能力上取得第一的成绩。马斯克披露了四大产品线(Grok、Coding、Imagine、Macro Hard)的组织架构调整,并详细阐述了从 10 万块 GPU 扩展到 100 万块的技术基础设施与 Memphis 超级计算中心的惊人建设速度。
文章分享了作者在公司内部分享中总结的七大 Claude Code 使用技巧。核心内容包括:使用 Plan 模式先规划后编码;通过 Claude.md 自定义指令与懒加载上下文;利用自分形与自描述机制优化代码搜索与理解;编写清晰提示词;利用 MCP 进行精准检索;使用 Agent 协作与 SubAgent 节省上下文;以及将常用流程沉淀为 Skill。文章旨在通过这些进阶技巧提高开发效率与代码质量。
文章记录了作者使用 OpenClaw、Vercel 和 Supabase 在两周内搭建一家由 6 个 AI 代理自主运营的“公司”的完整过程。重点探讨了如何解决从“代理对话”到“代理实际运行程序”的关键闭环问题,详细解析了在构建过程中遇到的竞态条件、触发器失效、队列积压三大陷阱及其解决方案。文章最终提炼出一套基于策略驱动、心跳机制和反应矩阵的可复用架构。
本文探讨了在 AI 时代,程序员最难被替代的核心能力并非代码编写技巧,而是做选择的'品味'和把结果做稳的'工程思维'。作者引用 ClawdBot 创始人 Peter 的观点,指出 AI 消灭了语法层面的痛苦,但保留了对架构设计的直觉和判断力。文章详细阐述了品味的定义(长期决策力)和工程思维的三个核心习惯(拆分、全局、三问),并强调 AI 是能力的乘数,只有具备扎实的基础,才能最大化 AI 的价值。
本文是作者在深入使用 OpenClaw 72 小时后的实战避坑指南。文章详细记录了 OpenClaw 在模型混用、iMessage 回环、配置文件容错及服务稳定性等方面的潜在陷阱与解决方案。作者指出 OpenClaw 虽然具备强大的自主性和灵活性,但对使用者的技术维护能力有较高要求,建议通过 Git 管理配置、构建心跳监控等方式在生产环境中保障服务稳定运行。
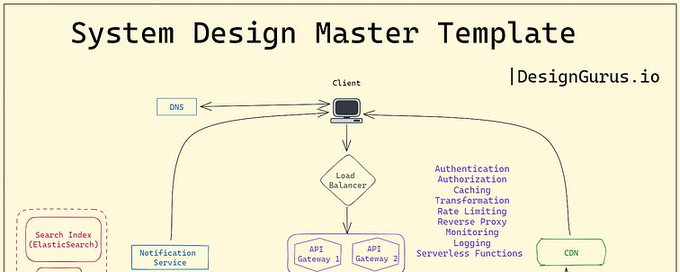
本文是作者基于对30多门课程的测试与评估,为2026年工程师精选出的5个最佳系统设计学习资源。文章涵盖了ByteByteGo、DesignGurus、Udemy及Exponent等平台,详细对比了它们在内容质量、实战案例、AI模拟面试等方面的优劣,旨在帮助开发者掌握可扩展性、微服务等核心架构技能,以应对FAANG级别的高难度面试。
本文是一份详细的机器学习(ML)工程师学习路径指南。作者首先纠正了被动观看视频的学习误区,提出“两遍学习法”以建立深刻的技术理解。文章明确了ML工程师与数据科学家及研究员的区别,强调工程实现能力。随后,作者将学习路径分为两个阶段:第一阶段利用 3Blue1Brown 的视频构建数学直觉,涵盖神经网络、梯度下降、反向传播及 Transformer 架构;第二阶段(文中截断处未完)预告将通过 Andrej Karpathy 的课程来提升代码实现能力。
文章指出2025年LLM已成为巨大的流量入口。作者通过一年的逆向工程实践,总结出8个提高AI引用率的有效方法,包括:利用榜单建立共识、保持内容新鲜度、使用表格结构化内容、发布新闻稿、多平台品牌提及、优化FAQ、避免客户端渲染以及针对YMYL领域进行EEAT优化。文章强调在AI时代,核心仍是提供有价值的内容和建立信任。
本文分享了如何利用 ChatGPT 作为“合作者”而非简单的“全文编辑器”来优化文章的六个步骤。核心方法包括:先提供“编辑意图说明书”明确目标;按“逻辑单元”而非字数拆解文本;每一轮仅执行一种修改动作以确保质量;以及最后进行全文一致性处理。文章强调方法比模型本身更重要,旨在实现与 AI 的真正共写。
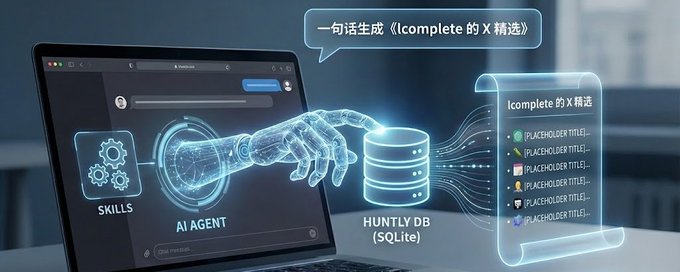
文章分享了作者为其开源项目 Huntly 实现“知识库对话”功能的巧妙思路。作者受技术帖启发,放弃了原本复杂的 Markdown 和 MCP 方案,转而让 Agent 直接通过 Skills 文档访问 SQLite 数据库。验证表明,该方案配合 glm-4.7-free 模型效果拔群,Agent 能轻松总结收藏、分析 RSS 文章并生成热门推文周刊。文章还展示了基于此逻辑生成的“lcomplete 的 X 精选”,涵盖了 AI 编程、投资哲学、工具生态及 Huntly 项目更新等内容。
本文是对 2025 年大语言模型(LLM)领域发展的深度回顾。主要趋势包括:推理模型的普及(OpenAI o 系列)、Agent 和编码 Agent 的爆发式落地(特别是 Claude Code)、中国开源模型在排行榜上占据主导地位、长任务处理能力的翻倍增长、Google Gemini 的全面崛起以及 OpenAI 领先优势的缩小。此外,文章还涵盖了图像编辑、学术竞赛表现、模型安全与“告密”现象等热点话题,指出 2025 年是 AI 实用化和工具化的一年。
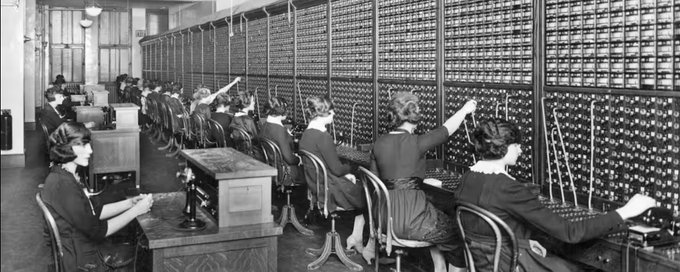
文章探讨了 AI 如何从个人智能进化到协作智能。作者指出,目前的 AI 虽然提升了个人效率,但在组织层面收效甚微,因为缺乏对上下文和社会协作的理解。通过回顾科学学会、电话交换机和 Git 等历史案例,文章认为真正的突破在于将 AI 视为具备社交能力的参与者,嵌入到人类的协作工作流(如邮件、文档、代码库)中,从而实现组织生产力的指数级跃升。
文章深入剖析了 Claude Code 背后的核心架构,指出其本质是一个“感知-行动-观察”的循环系统。作者演示了如何从简单的命令行脚本开始,逐步构建一个具备文件读写、精确编辑、代码库搜索及权限控制的 AI 代理。文章详细讲解了 Agent Loop(代理循环)、结构化工具调用、子代理上下文管理以及 CLAUDE.md 项目上下文等关键技术点,并最终提供了一个约 150 行的完整 Python 实现示例。
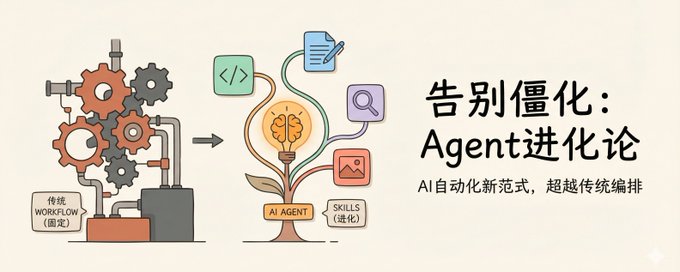
文章通过对比传统 Workflow 编排与 AI Agent + Skills 架构,提出大部分场景下后者可以取代前者。作者提出了五步框架(拆分、编排、存储、分摊、迭代),并结合自身写作工作流演示了如何利用 Claude Code 的 Skills 功能构建可进化的自动化系统。文章还回应了关于稳定性、成本和门槛的三大质疑,指出 Skills 在灵活性、可维护性和自我迭代方面的显著优势。
本文是拥有 7 年经验的 CTO 分享的 Claude Code 进阶教程。作者通过实战经验,总结出“先思考后编码”的重要性,深入讲解了如何有效利用 Plan Mode 模式、编写高质量的 CLAUDE.md 配置文件,以及如何应对 LLM 上下文窗口的限制。文章旨在帮助开发者构建更稳健的系统,避免常见的 AI 编程误区。
本文深入浅出地解析了 Claude Skills 的概念与价值,构建了从「编程函数」到「函数调用」再到「Skills」的三层认知框架。文章指出,Skills 不仅是工具的集合,更是包含指令、脚本和资源的完整解决方案,使 AI 能处理复杂工作流。通过实战案例(如自动排版发布)展示了其如何提升生产力,并介绍了如何使用和创建 Skills,强调非程序员也能通过定义工作流将专业知识转化为 AI 能力。
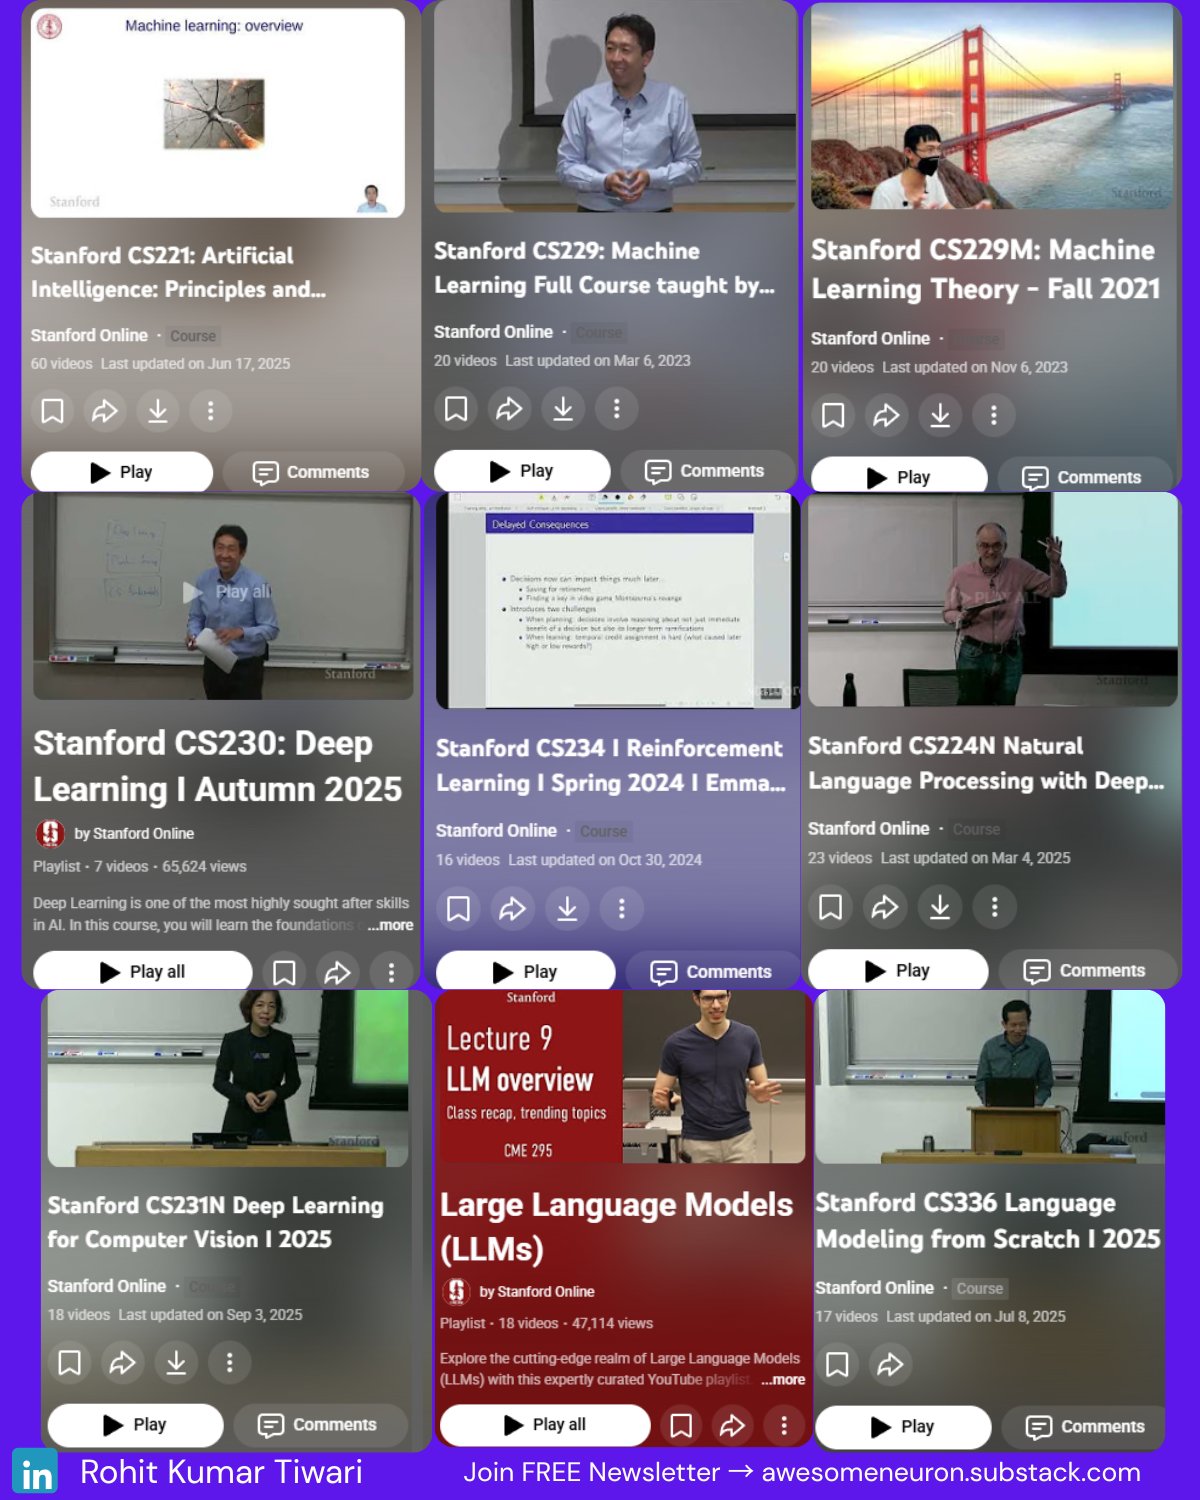
本文列举了斯坦福大学关于人工智能与机器学习的 10 门顶级课程,涵盖了人工智能基础、机器学习、深度学习、强化学习、自然语言处理(NLP)、计算机视觉(CV)、大语言模型(LLMs)及深度生成模型等核心领域,旨在帮助学习者掌握 AI 第一性原理。
文章截图展示了一场关于大型语言模型(LLM)开发工具的讨论。主要涉及开源 CLI 工具的选择、本地开发环境的重要性、模型代理设计差异,以及在不同电脑环境下进行 AI 开发的常见问题(如闲鱼二手机器、环境报错等)。参与者认为统一的训练环境对模型兼容性至关重要,并指出新手只要教程得当上手并不难。