Faceplugin 开源人脸识别 SDK:本地运行、完全免费
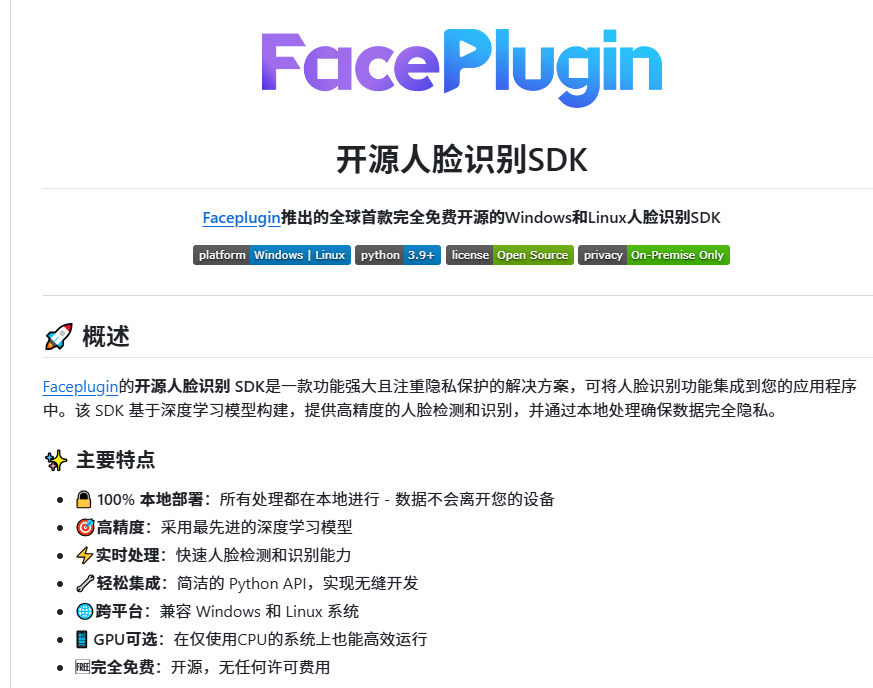
Faceplugin 宣布开源一整套人脸识别 SDK,号称全球首个彻底免费开源的人脸识别方案,支持 Windows 和 Linux。其亮点包括:全程本地运行,数据不出设备,不上传云端;无需独显,CPU 即可支撑运行;提供 Python 接口,支持人脸检测、关键点提取和特征比对。作者认为对白嫖党很有吸引力,但也提醒免费版在精度和活体检测方面可能有所缩水,若要正式投产使用还需自行权衡评估。
Faceplugin 宣布开源一整套人脸识别 SDK,号称全球首个彻底免费开源的人脸识别方案,支持 Windows 和 Linux。其亮点包括:全程本地运行,数据不出设备,不上传云端;无需独显,CPU 即可支撑运行;提供 Python 接口,支持人脸检测、关键点提取和特征比对。作者认为对白嫖党很有吸引力,但也提醒免费版在精度和活体检测方面可能有所缩水,若要正式投产使用还需自行权衡评估。
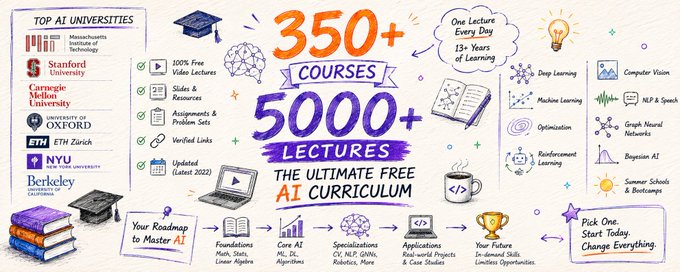
作者因厌倦在YouTube、Google和大学网站间费力搜寻AI学习资源,整理了一份完全免费的AI课程大全,涵盖350多门课程和5000多个讲座。内容按主题分类,包括深度学习、机器学习基础、优化、强化学习、概率图模型、贝叶斯深度学习、医学影像、图神经网络、NLP、语音识别、计算机视觉等14个方向。课程来源包括Geoffrey Hinton、Andrew Ng、Andrej Karpathy、Richard Socher等名师在多伦多大学、斯坦福、牛津、MIT、CMU、DeepMind等机构的经典课程,并附有课件和视频链接。
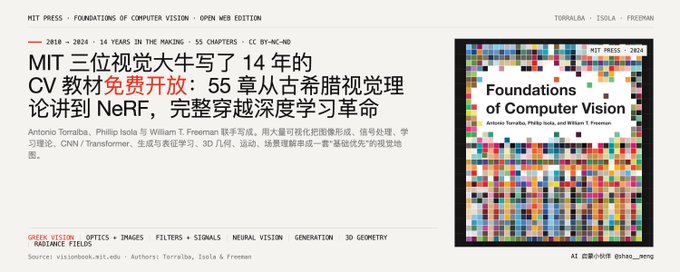
MIT 三位教授 Torralba、Isola 和 Freeman 合著的《计算机视觉基础》开放免费在线阅读,全书 55 章历时 14 年写成,完整穿越深度学习革命。本书刻意不追踪 SOTA,而是强调当代方法深植于视觉与 AI 的历史脉络,从古希腊视觉理论一直讲到 NeRF。全书按问题背景、数学与信号处理、神经架构与统计建模、几何与运动、应用与研究素养五条主线编排,统一了经典视觉方法与深度学习,还包含研究方法论与社会伦理内容。作者认为它有望成为下一代 CV 标准入门教材,但不覆盖扩散模型与多模态大模型最新进展。
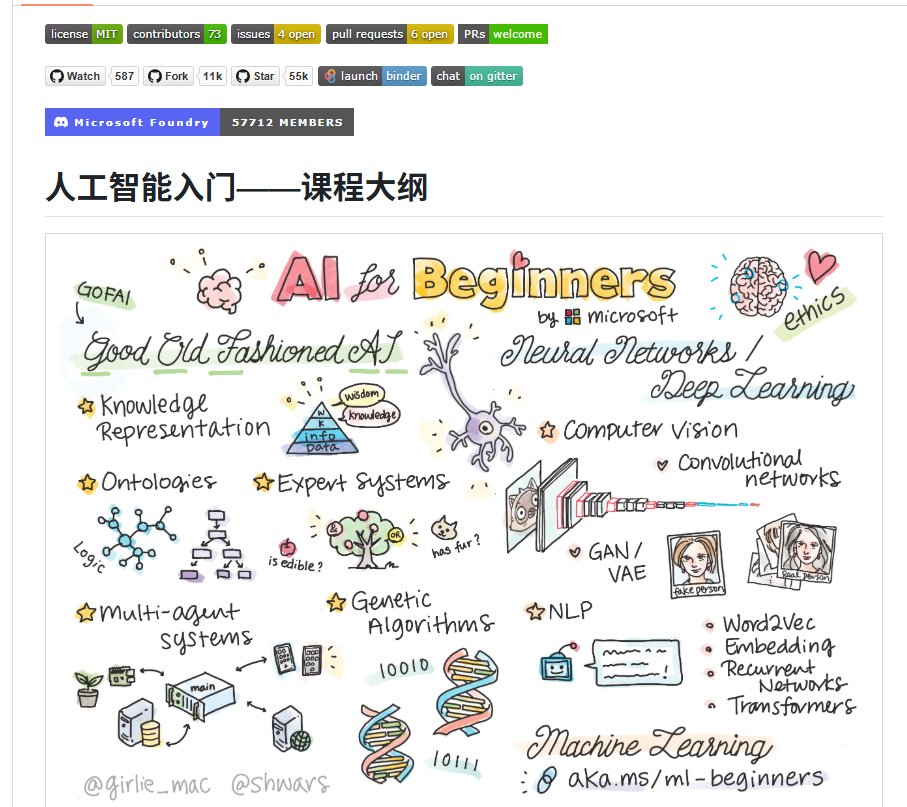
微软官方开源一套12周24节课的AI入门课程,涵盖从符号AI到深度学习、计算机视觉、多智能体系统等内容。无需TensorFlow或PyTorch基础,适合系统学习和教学使用,支持50多种语言,包括简体中文。
本文基于李飞飞的观点,深入探讨了“世界模型”这一AI术语在当前语境下的定义与功能。文章通过强化学习中的POMDP框架,将世界模型系统分为三类:输出视觉观察的“渲染器”、输出物理状态的“模拟器”以及输出行动指令的“规划器”。作者指出,尽管渲染器目前商业应用最成熟,但模拟器作为连接视觉与行动的桥梁,是实现空间智能和通用机器人的关键。文章最后预测,这三类功能的边界将逐渐坍缩,最终融合为一个统一的、能够理解并交互物理世界的基础模型。
本文由李飞飞撰写,旨在厘清当下 AI 领域中“世界模型”这一概念的混淆。文章基于强化学习中的智能体循环框架,将现有的世界模型划分为三类:侧重视觉保真度的“渲染器”、侧重物理与几何结构准确的“模拟器”,以及侧重决策输出的“规划器”。作者强调,模拟器虽然公众关注度较低,但连接了视觉与行动,是实现物理世界精准交互的关键,也是空间智能的核心所在。
DeepSeek发布新论文,提出一种名为“视觉原语”的多模态推理框架。不同于业界卷分辨率的趋势,该模型通过在思维链中嵌入边界框和坐标点,模拟人类用手指着图片思考的过程,有效解决了语言在空间指代上的局限。DeepSeek-ViT配合LLM将视觉Token压缩至竞品的十分之一,但在空间推理、计数和迷宫导航等任务上性能超越GPT-5.4等顶尖模型。
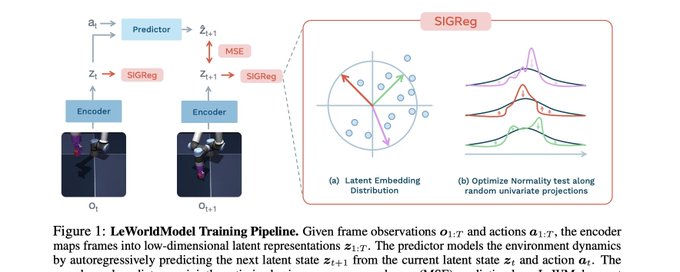
文章介绍了 LeWorldModel (LeWM),一种新的世界模型架构。它解决了当前世界模型(如 DINO-WM 和 PLDM)的局限,仅通过两个损失项(Next-embedding 预测损失和 SIGReg)实现了从原始像素开始的稳定端到端训练。实验表明,LeWM 能在潜在空间中自发涌现出时间直线性和物理约束,有效避免了表示偏差和模型崩塌问题。
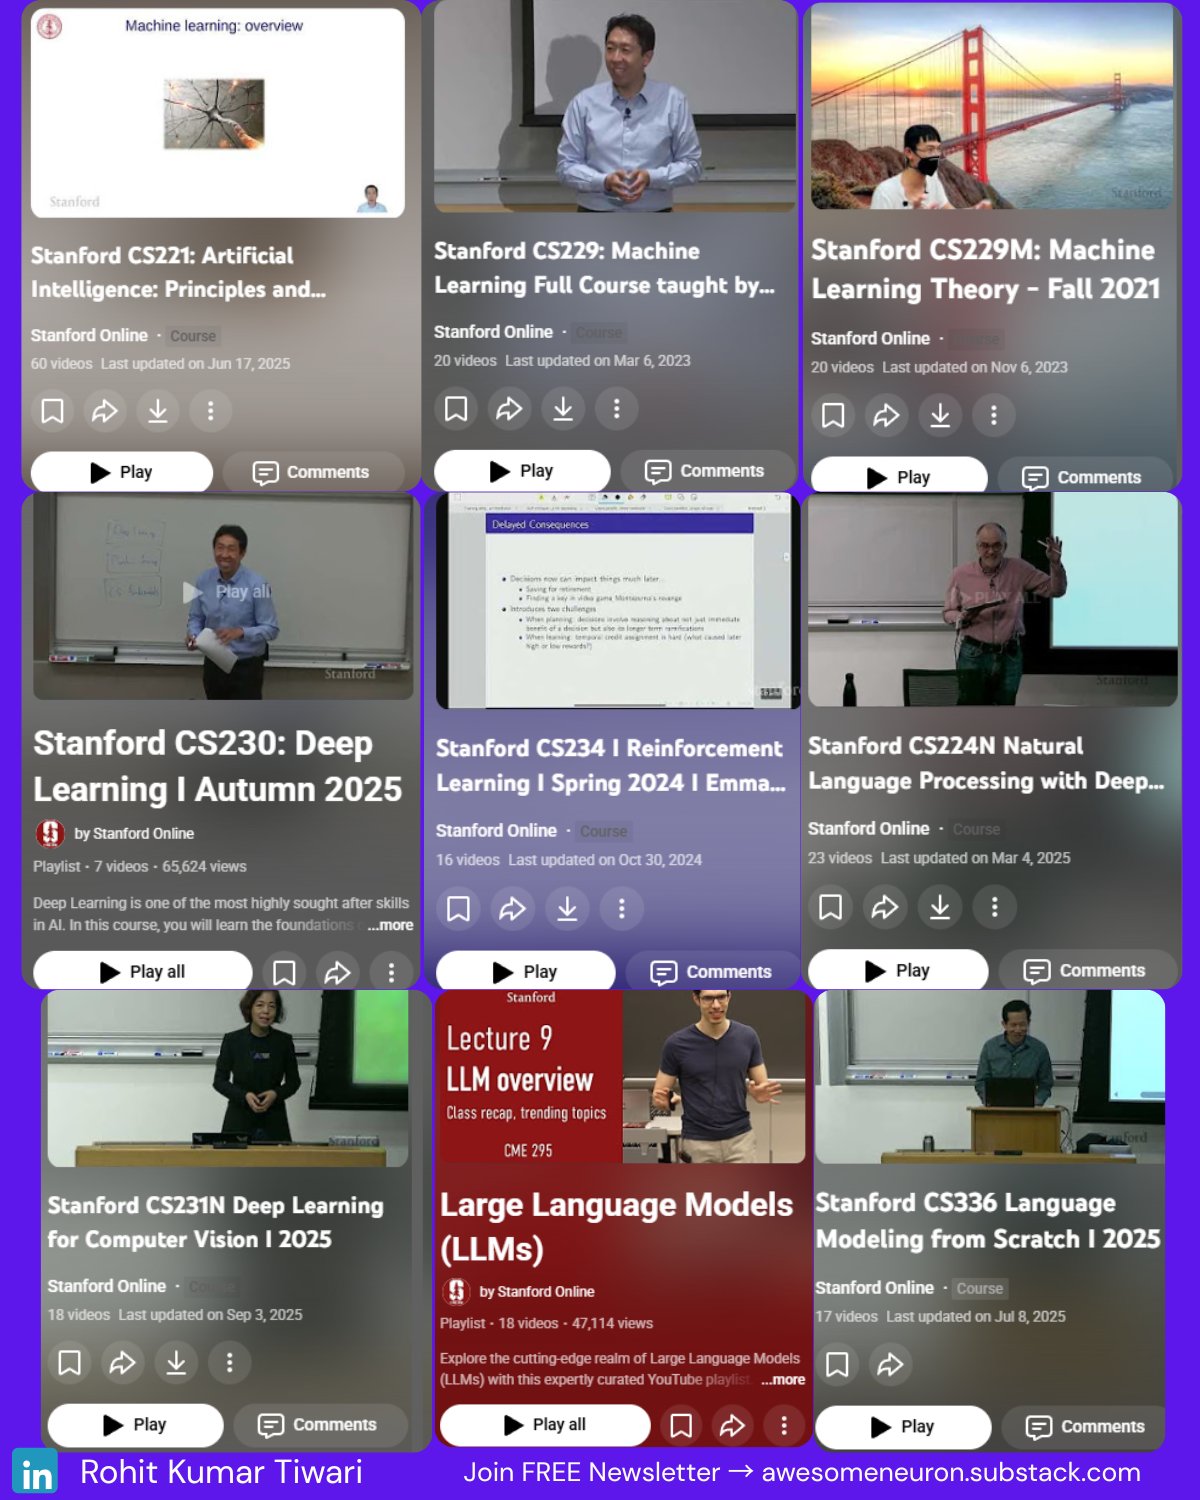
本文列举了斯坦福大学关于人工智能与机器学习的 10 门顶级课程,涵盖了人工智能基础、机器学习、深度学习、强化学习、自然语言处理(NLP)、计算机视觉(CV)、大语言模型(LLMs)及深度生成模型等核心领域,旨在帮助学习者掌握 AI 第一性原理。
本文档详细阐述了一款骨科手术导航与规划系统的开发目的、应用场景及技术栈。该系统旨在通过三维骨骼模型重建与实时导航,提高骨科手术精准度。项目采用C++、Python、C#多语言开发,涉及OpenCV、VTK、TensorFlow等技术,源代码量约40万至60万行,涵盖影像处理、AI识别及高性能可视化等核心功能。