Wiki 知识库

全部文档 / 标签: 分布式训练

4 篇
清除

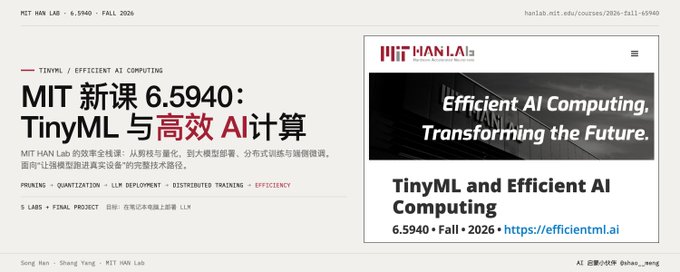
MIT 新课 6.5940 TinyML 与高效 AI 计算(MIT HAN Lab):从剪枝量化到大模型部署与分布式训练的效率全栈课

文章介绍 MIT 韩松(Song Han)实验室开设的高效机器学习旗舰课程 6.5940 TinyML and Efficient AI Computing。课程分四章递进:高效推理(剪枝、量化、蒸馏、NAS)、面向特定领域的优化(TinyML、LLM 量化部署、长上下文、扩散模型)、高效训练(分布式训练、设备端训练)及进阶专题。课程以动手为中心,无考试,由 5 个 Lab(从 GPU 编程到本地 LLM 部署)和 NeurIPS 模板期末项目构成评分。作者认为该课程知识体系完整、与研究前沿零距离、工程实践导向鲜明,是学习模型压缩、LLM 推理优化和 TinyML 的最佳公开课,所有视频和课件均已公开。

技术 › LLM meng shao 2026-09-308.1 KB 5.3K 56 79

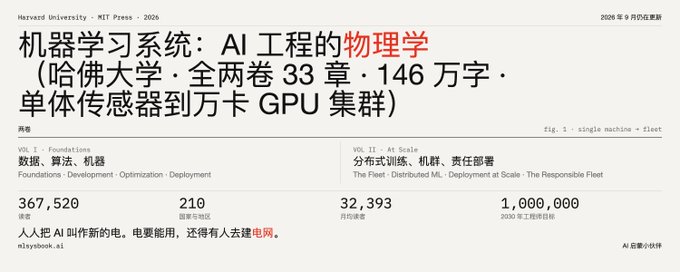
机器学习系统:AI 工程的物理学(哈佛大学开源教材解读)

文章介绍了哈佛大学 Vijay Janapa Reddi 教授的开源教材《Machine Learning Systems: The Physics of AI Engineering》,两卷 33 章,旨在像 Hennessy & Patterson 的体系结构经典一样,将 ML 系统工程变为有定量定律的学科。全书以铁律、屋顶线模型、能耗阶梯、Amdahl 定律、漂移方程等核心定律组织内容:第一卷讲单机 ML 系统栈(数据、训练、压缩、硬件、服务、MLOps),第二卷讲集群规模化(分布式训练、3D 并行、容错、推理经济学、可持续 AI)。文章总结了书中'约束驱动''一切皆有价格''静默失败是默认模式'等核心世界观,并给出不同读者群体的阅读建议。

技术 › 后端 meng shao 2026-09-2817.0 KB 13.5K 125 84

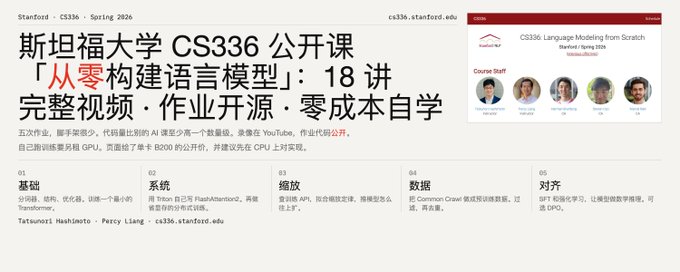
斯坦福大学 CS336 公开课「从零构建语言模型」:18 讲完整视频 · 作业开源 · 零成本自学

本文介绍斯坦福大学 2026 春季研究生课程 CS336「从零构建语言模型」。该课程由 Hashimoto 和 Liang 教授讲授,工程量极大,学生需亲手实现 tokenizer、模型、FlashAttention2 内核及分布式训练。内容覆盖 LLM 全生命周期:模型架构、系统优化(GPU/内核/并行)、Scaling Laws、数据处理、推理评估及后训练对齐(含 RLVR)。五次编程作业串起从原始数据到可对话模型的完整生产流程。目前 18 讲视频与作业已全部公开,是自学者系统补齐 LLM 工程能力的稀缺资源,但要求扎实的 PyTorch 与体系结构基础。

技术 › LLM meng shao 2026-09-247.2 KB 15.5K 194 81

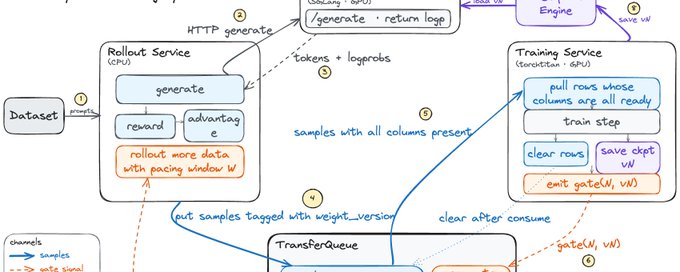
Meshy: 角色驱动下 SPMD 范式的 RL 训练框架

本文介绍了开源 RL 训练框架 Meshy,它摒弃了中央控制器和 Ray,将 Inference、Training、Rollout、Teacher 建模为独立服务。样本数据通过 TransferQueue 数据面在生产者与消费者之间直达传输,流程由数据列的就绪状态驱动,拓扑由各进程在启动时本地确定性推导,使 RL 训练回归预训练式的 SPMD 设计。文章分析了传统 RLHF 流水线与 Single-Controller 架构在异步生成、多轮 Agent 等场景下的局限,阐述了 Meshy 通过声明式 ServiceGroup、基于令牌环的多角色共置等机制,支持同步 RL、异步 RL 及在线蒸馏等多种训练方式。框架基于 TorchTitan 与 SGLang 实现,代码已开源。

技术 › LLM Guitar Cat + LLM 2026-09-0931.4 KB 8.2K 67 84