Wiki 知识库

全部文档 / 标签: 模型压缩

3 篇
清除

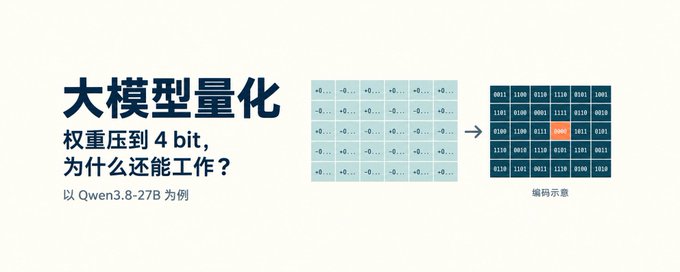
权重压到 4 bit,大模型为什么还能工作?

文章以 Qwen3.8-27B 为例,系统讲解大模型权重量化的原理。从参数如何参与矩阵乘法运算入手,说明 bit 数与编码格式(FP16、BF16、INT4)的关系,演示 0.73 如何被 4 bit 编码为 0.8 并引入误差。深入分析了刻度选择中范围、分辨率与截断误差的取舍,权重误差如何随输入放大为输出误差,以及 GPTQ、AWQ、PTQ、QAT 等量化方法如何利用校准数据控制误差。最后估算 4 bit 模型的存储大小(约 13.5-19 GB),讲解 KV 缓存、混合注意力结构对显存的影响,并给出选择和评估本地量化模型的实用建议。

技术 › LLM gKev1n 2026-10-0511.9 KB 4.9K 36 84

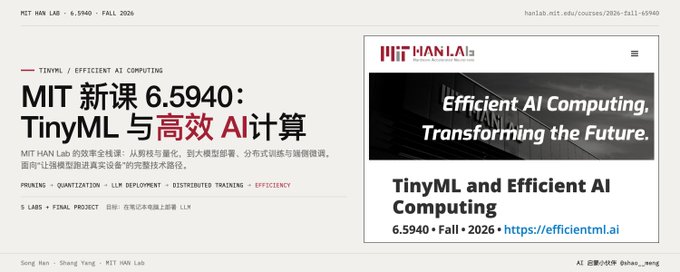
MIT 新课 6.5940 TinyML 与高效 AI 计算(MIT HAN Lab):从剪枝量化到大模型部署与分布式训练的效率全栈课

文章介绍 MIT 韩松(Song Han)实验室开设的高效机器学习旗舰课程 6.5940 TinyML and Efficient AI Computing。课程分四章递进:高效推理(剪枝、量化、蒸馏、NAS)、面向特定领域的优化(TinyML、LLM 量化部署、长上下文、扩散模型)、高效训练(分布式训练、设备端训练)及进阶专题。课程以动手为中心,无考试,由 5 个 Lab(从 GPU 编程到本地 LLM 部署)和 NeurIPS 模板期末项目构成评分。作者认为该课程知识体系完整、与研究前沿零距离、工程实践导向鲜明,是学习模型压缩、LLM 推理优化和 TinyML 的最佳公开课,所有视频和课件均已公开。

技术 › LLM meng shao 2026-09-308.1 KB 5.3K 56 79

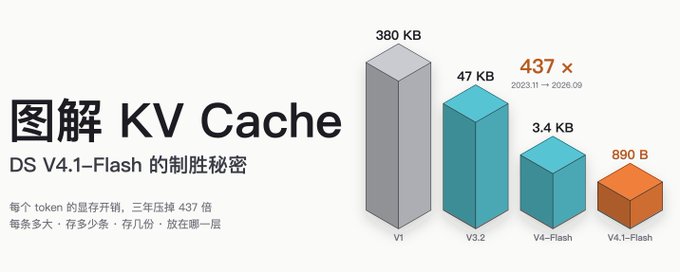
图解 KV Cache——DS V4.1-Flash的制胜秘密

本文图解 DeepSeek V4.1-Flash 如何将单 token 全局 KV Cache 从 V1 的 389KB 压缩至 890 字节。文章先介绍 KV Cache 原理与显存瓶颈,再梳理 GQA、MLA、量化、稀疏注意力、跨层复用等六次关键突破,最后详解 V4.1 在架构、精度、部署三层的联合优化,包括 CED、CSA2 三模式、层级稀疏索引器与 FP4 量化,并给出 890 字节的推导过程。

技术 › LLM WquGuru 2026-09-1423.6 KB 68.6K 376 83