Wiki 知识库

全部文档 / 标签: 数据处理

8 篇
清除

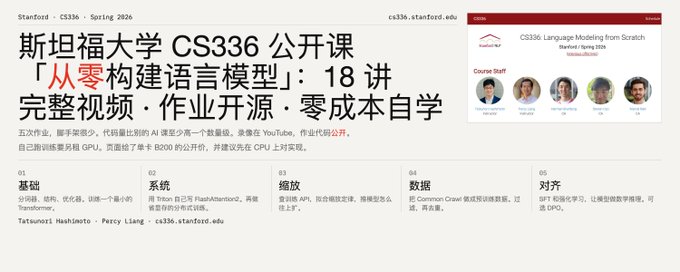
斯坦福大学 CS336 公开课「从零构建语言模型」:18 讲完整视频 · 作业开源 · 零成本自学

本文介绍斯坦福大学 2026 春季研究生课程 CS336「从零构建语言模型」。该课程由 Hashimoto 和 Liang 教授讲授,工程量极大,学生需亲手实现 tokenizer、模型、FlashAttention2 内核及分布式训练。内容覆盖 LLM 全生命周期:模型架构、系统优化(GPU/内核/并行)、Scaling Laws、数据处理、推理评估及后训练对齐(含 RLVR)。五次编程作业串起从原始数据到可对话模型的完整生产流程。目前 18 讲视频与作业已全部公开,是自学者系统补齐 LLM 工程能力的稀缺资源,但要求扎实的 PyTorch 与体系结构基础。

技术 › LLM meng shao 2026-09-247.2 KB 15.5K 194 81

闲鱼 Excel 代做实操:全程AI,几分钟变现200

文章介绍如何利用 AI 在闲鱼、猪八戒等平台承接单价约200元的 Excel 数据处理服务实现副业变现。作者将接单流程拆解为四步:先让 AI 盘点数据并制定处理方案,再补充关键业务规则,然后生成带格式和图表的 Excel 成品,最后进行数据对账与交付。文中提供了各环节可复用的提示词模板,涵盖数据清洗、多表合并、自动化统计三类常见业务,并强调备份源文件和抽检数据的重要性,是一种朴素实用的 AI 变现方式。

技术 › 工具与效率 刘屿之外 2026-09-188.2 KB 38.7K 116 77

你需要的不再是一个云笔记,而是一个会自己生长的AI知识库

文章指出传统云笔记因需人工维护而难以坚持,提出构建AI知识库的解决方案。通过AI自动整理会议录音、关联历史笔记并追踪人物主题,实现知识的自我生长。这不仅能大幅降低维护成本,还能辅助内容创作和长期关系管理,让普通人更专注于思考与表达。

技术 › 工具与效率 金尘马 2026-07-299.9 KB 28.7K 72

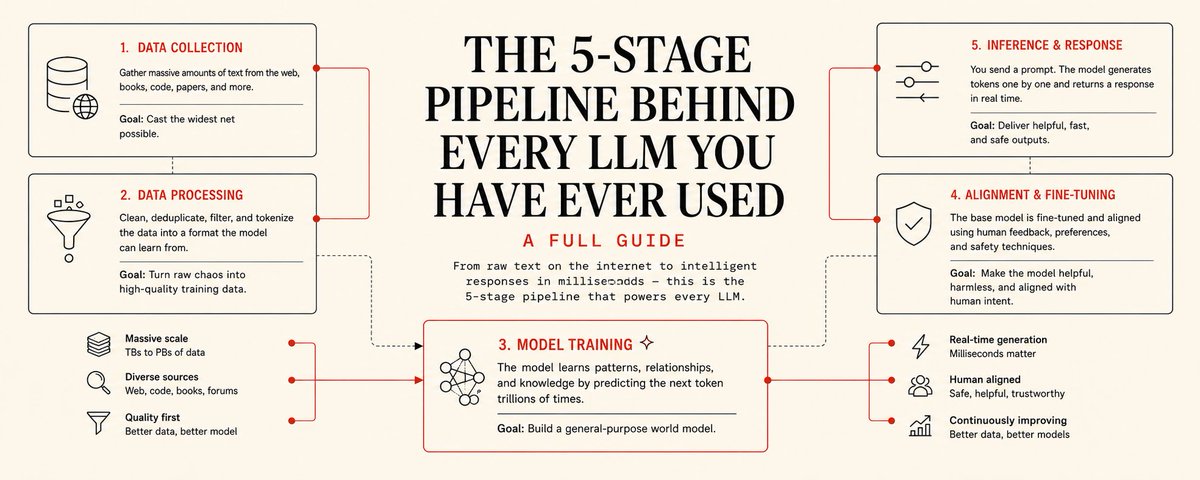
每个 LLM 背后的五阶段流程指南

文章详细解析了构建大型语言模型的五个关键阶段:数据收集与预处理、预训练、及后续阶段。作者指出,大多数误解源于将“训练”视为单一步骤,实际上每个阶段解决不同问题。理解这一流程有助于识别模型行为根源及局限性,如幻觉或拒绝回答,并指导优化策略。

技术 › LLM CyrilXBT 2026-07-1751.7 KB 459.2K 226

Crawl4AI:7万星开源神器把网页秒变LLM能吃的干净Markdown

文章介绍了一款名为 Crawl4AI 的开源爬虫工具,GitHub 星标超 7 万。该工具专为 RAG 和 Agent 设计,能将网页快速转换为干净的结构化 Markdown 数据。其特点包括零 API Key、异步浏览器池、智能去噪、支持 CLI/Docker 部署以及强大的反爬策略,被视为构建 LLM 数据管道的利器。

技术 › LLM 开发者Hailey 2026-07-101.9 KB

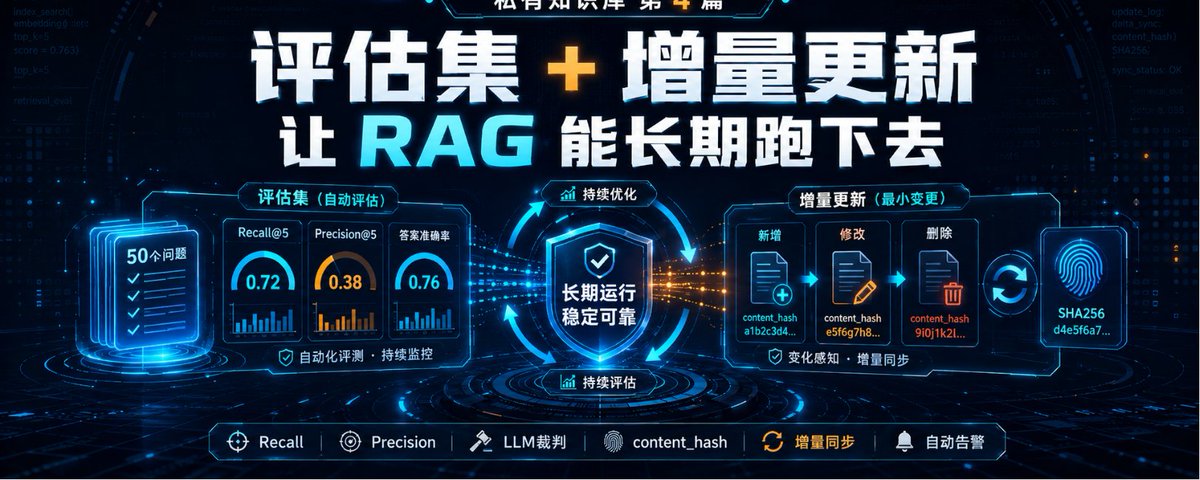
私有知识库第4篇:评估集 + 增量更新,让 RAG 能长期跑下去

文章探讨了 RAG(检索增强生成)系统长期运行的两大难题:评估与更新。作者提出建立包含50个问题的“评估集”,通过 Recall、Precision 和 LLM 辅助的答案准确率来量化系统效果,避免盲目调参。同时,针对文档更新导致的全量重建成本问题,介绍了基于内容 Hash 的增量更新策略,仅处理变动文档,大幅降低资源消耗与停机时间。

技术 › LLM A Ando 2026-07-0817.6 KB

如何把聊天记录变成可检索知识库(2026版)

文章探讨了如何将微信、Telegram等平台的聊天记录转化为可用的个人知识库。作者从数据获取、清洗降噪(语义分块、去重、上下文修复)到存储检索(Embedding选型、GraphRAG)提供了全流程的技术指导,并提出了数字分身、知识传承等多种应用场景。

技术 › LLM AI最严厉的父亲 2026-05-1226.8 KB 59K 158 91