Wiki 知识库

全部文档 / 标签: 模型蒸馏

5 篇
清除

当作恶也能自动化:中国用户需要重新学习什么

基于 Anthropic 2026 年 9 月发布的威胁情报报告,作者分析了 AI 降低作恶成本带来的多维风险:AI 混入真人视频的约会应用诈骗、低价 AI 代理窃取凭据、网络攻击自动化、影响力行动、人物画像监控以及武器与生物领域的双重用途问题。文章强调对涉及中国公司的蒸馏指控应区分训练方法、服务授权与用户数据处理三个问题。作者建议中国用户与开发者主动核验 AI 服务的数据路径与经营者身份,管理权限与密钥,验证信息来源,从知情权、选择权和数据权益出发保护自己。
技术 › 网络安全 卡夫卡 2026-09-1224.6 KB 4.2K 3 79

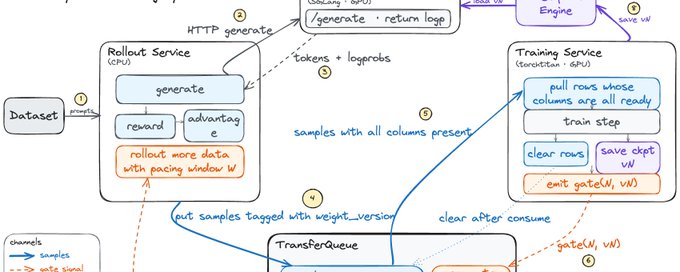
Meshy: 角色驱动下 SPMD 范式的 RL 训练框架

本文介绍了开源 RL 训练框架 Meshy,它摒弃了中央控制器和 Ray,将 Inference、Training、Rollout、Teacher 建模为独立服务。样本数据通过 TransferQueue 数据面在生产者与消费者之间直达传输,流程由数据列的就绪状态驱动,拓扑由各进程在启动时本地确定性推导,使 RL 训练回归预训练式的 SPMD 设计。文章分析了传统 RLHF 流水线与 Single-Controller 架构在异步生成、多轮 Agent 等场景下的局限,阐述了 Meshy 通过声明式 ServiceGroup、基于令牌环的多角色共置等机制,支持同步 RL、异步 RL 及在线蒸馏等多种训练方式。框架基于 TorchTitan 与 SGLang 实现,代码已开源。

技术 › LLM Guitar Cat + LLM 2026-09-0931.4 KB 8.2K 67 84

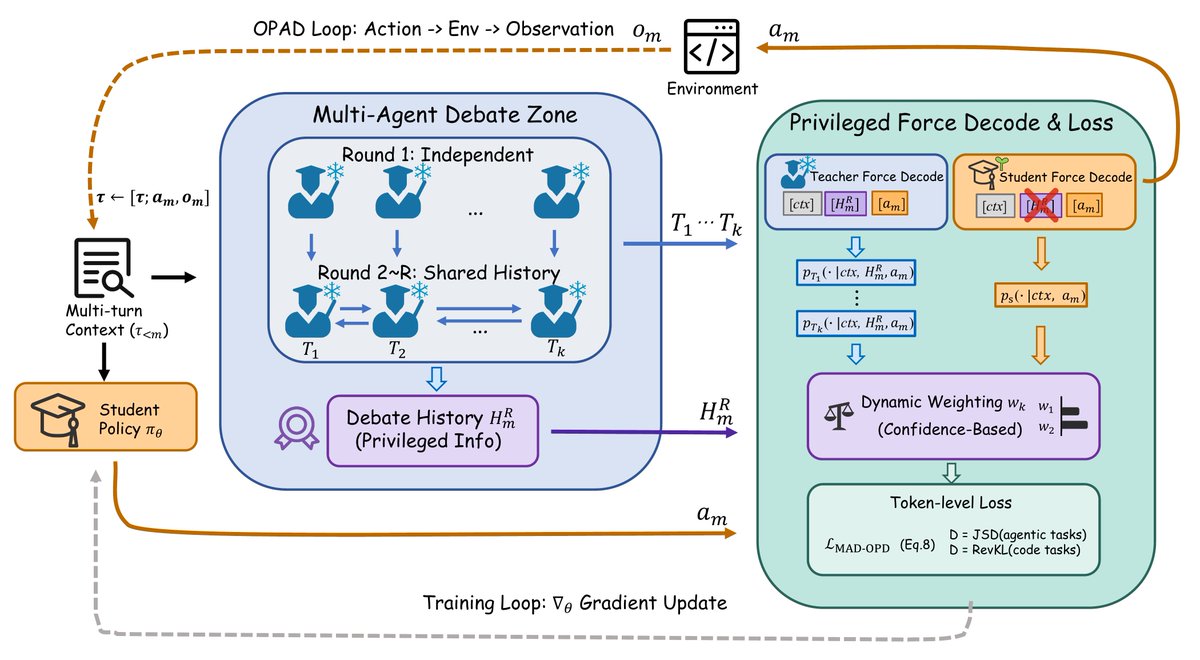
突破OPD天花板:MAD-OPD让小模型通过多教师辩论反超大模型

文章介绍了一种名为 MAD-OPD 的新算法,旨在解决 OPD(On-Policy Distillation)中单教师模型存在盲点导致学生模型学习受限的问题。通过引入多智能体辩论机制,让多个教师围绕学生状态互相纠错并达成共识,再进行蒸馏。实验表明,该方法在 14B+8B 到 4B 的蒸馏任务中,不仅提升了代码生成能力,还在 Agentic 任务中实现了小模型反超大教师的突破。

技术 › LLM 青稞社区 2026-07-136.6 KB 3.7K 22

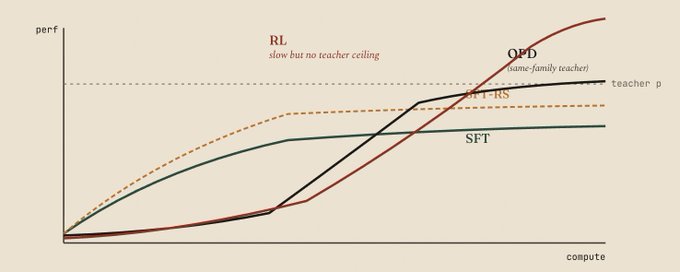
SFT、RL 与 On-Policy 蒸馏:原理与差异

本文深入探讨了模型后训练中的 SFT 与 RL 流程,重点分析了基于同族模型(Same-family)的 On-Policy 蒸馏(OPD)技术。文章解释了 SFT 存在性能天花板的原因,以及 RL 如何通过复利效应突破这一限制。作者指出 OPD 结合了 SFT 的低成本和 RL 的复合优势,能高效利用教师模型的反向 KL 散度信号,是实现高性能模型微调的关键手段。

技术 › LLM will brown 2026-05-0150.2 KB 72

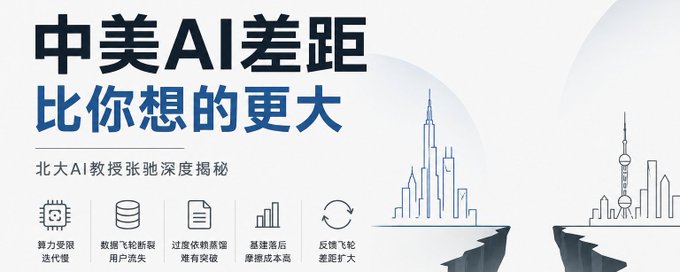
离职字节后,北大教授泼了盆冷水:中国AI的真实差距,可能正在拉大

北大教授、前字节跳动算法专家张驰分析中美AI现状。他指出国内大模型存在“应试刷榜”、基础算力设施薄弱、高质量数据飞轮断裂等问题。因国产模型体验差距,顶尖开发者纷纷流失至美国产品,导致数据反馈闭环恶化;过度依赖模型“蒸馏”也限制了原创能力。尽管在硬件和具身智能领域尚存优势,但在纯软件领域的整体差距恐将持续扩大。

技术 › LLM Gorden Sun 2026-04-267.3 KB 220.6K 453 60