Wiki 知识库

全部文档 / 标签: LLM训练

4 篇
清除

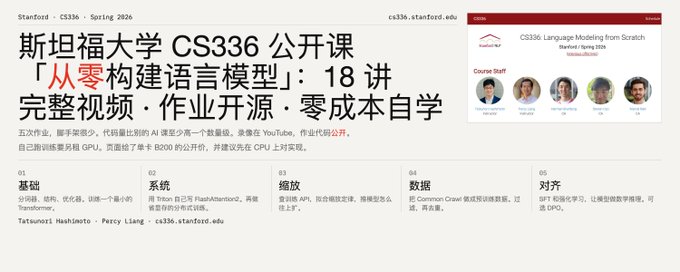
斯坦福大学 CS336 公开课「从零构建语言模型」:18 讲完整视频 · 作业开源 · 零成本自学

本文介绍斯坦福大学 2026 春季研究生课程 CS336「从零构建语言模型」。该课程由 Hashimoto 和 Liang 教授讲授,工程量极大,学生需亲手实现 tokenizer、模型、FlashAttention2 内核及分布式训练。内容覆盖 LLM 全生命周期:模型架构、系统优化(GPU/内核/并行)、Scaling Laws、数据处理、推理评估及后训练对齐(含 RLVR)。五次编程作业串起从原始数据到可对话模型的完整生产流程。目前 18 讲视频与作业已全部公开,是自学者系统补齐 LLM 工程能力的稀缺资源,但要求扎实的 PyTorch 与体系结构基础。

技术 › LLM meng shao 2026-09-247.2 KB 15.5K 194 81

The Math of RL: From Policy Gradients to PPO and GRPO

本文深入讲解强化学习的数学原理,重点推导策略梯度、REINFORCE、PPO 和 GRPO 等算法。作者首先介绍 RL 的基本流程(Agent、环境、奖励、策略),并通过数学推导得到策略梯度估计器。随后指出原始策略梯度存在的高方差和偏置问题,引入 REINFORCE 算法进行改进。文章还结合 RLHF 和 RLVR 在大语言模型训练中的应用背景,说明 RL 在 LLM 对齐及数学、编程能力提升中的重要作用,帮助读者理解现代 LLM 强化学习训练的底层机制。

技术 › LLM Harsh Bhatt 2026-08-3117.7 KB 56K 567 56

Prime Intellect 持续学习系统构建指南

本文介绍了如何利用开源生态系统构建一个持续学习的编码代理系统。作者基于 Prime Intellect 平台和 OpenCode 环境,创建了一套批量增量式在线强化学习流程,通过 Git 快照收集真实交互数据(约 21.8 亿条记录),并在沙箱环境中进行模型训练与部署,旨在实现代码生成的个性化与自我进化。

技术 › Agent Sriraam 2026-04-076.4 KB 46.5K 695 75