Parallelism strategies for LLM inference, clearly explained Avi Chawla 2026-10-06 29.4 KB 29.4K 178 ☆ 收藏 𝕏 文章列表 本文系统讲解了 LLM 推理的多 GPU 并行策略。首先介绍推理的两个阶段(Prefill 影响 TTFT,Decode 影响 TPOT)以及部署中的四大资源限制(参数内存、KV-cache、计算、通信),然后通过五个关键问题框架分析各类并行策略:数据并行(复制完整模型、分区请求)、张量并行、流水线并行、上下文并行和专家并行。文章强调选择布局需权衡内存容量、请求延迟和吞吐量,避免通信开销超过硬件承受能力,并给出部署检查规则,帮助读者根据模型、硬件拓扑和工作负载选出合适的布局。 LLM推理并行策略数据并行张量并行流水线并行GPU分布式推理优化KV缓存TTFT吞吐量 82 强烈推荐 ▶ 系统性地讲解了LLM推理五种并行策略,框架清晰、含工程检查清单,深度与可读性俱佳,但主题为经典内容的综合阐述,新颖性一般。 # Parallelism strategies for LLM inference, clearly explained **作者**: Avi Chawla **日期**: 2026-06-28T11:58:41.000Z **来源**: [https://x.com/_avichawla/status/2107427400779026843](https://x.com/_avichawla/status/2107427400779026843) --- 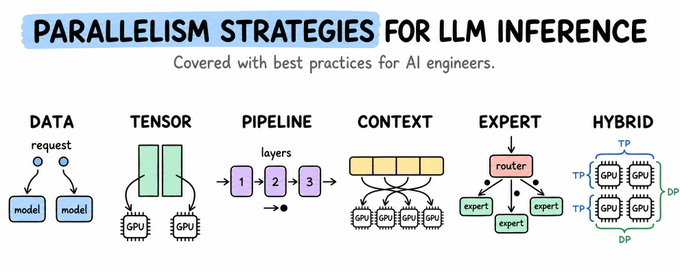 Everything you need to understand how to split LLM inference across GPUs without losing performance to communication. It covers data, tensor, pipeline, context, and expert parallelism, how to combine them, and the deployment checks that determine which layout fits your model, hardware, and workload. Four GPUs provide four separate memory spaces and four processors. They do not behave like one GPU with four times the capacity. A kernel running on one GPU cannot use weights or KV-cache blocks stored on another GPU without transferring that data. 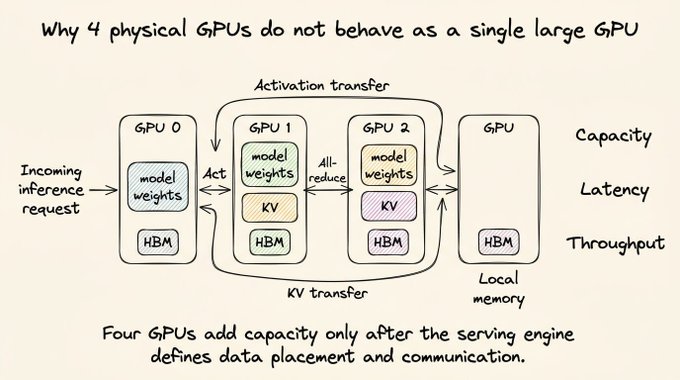 Distributed inference therefore starts with data placement. The serving engine assigns weights, activations, requests, and cached keys and values to specific devices. Any dependency that crosses devices adds a transfer or collective operation to the request path. The engineering problem is choosing a placement that removes the current limit without adding more communication than the hardware can absorb. That is what we will solve here. By the end, you should be able to inspect a model, workload, GPU topology, and latency target, then select a defensible first layout. We will compare each strategy with five questions: - What state is partitioned? - What remains replicated? - What crosses the interconnect? - How often does that transfer occur? - Does the layout improve memory capacity, request latency, or throughput? Throughout the article, we will assume the same four-GPU server. The model needs at least two of those GPUs, and the server receives both short chats and long-context requests. We will keep that model, workload, and hardware fixed while changing only how inference work is divided across the GPUs. > We will use the word "collective" throughout this article. A collective is an operation in which several GPUs exchange or combine data as a group. For example, two GPUs may calculate separate parts of a layer output. An all-reduce adds those parts together and gives the complete result to both GPUs. Other collectives move different pieces of data between the participating GPUs. Every participating GPU must complete its part before the collective finishes. One slow GPU or connection can therefore delay the entire group. This differs from a direct transfer, where one GPU sends data to another GPU. # How LLM inference works Before we can understand how LLM inference can be optimized, we need to see how LLM inference works in the first place. LLM inference has two phases. 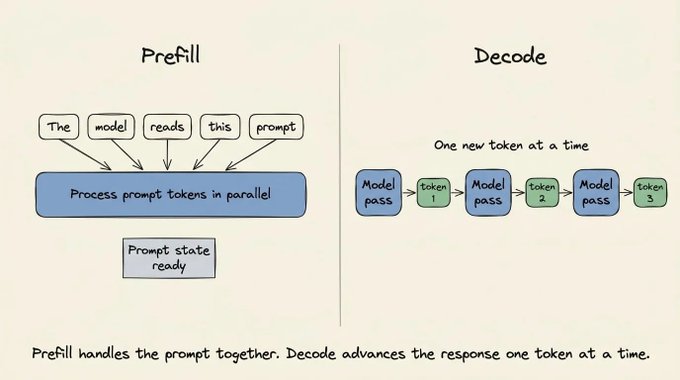 - Prefill processes the prompt and builds its key-value cache. It handles many prompt tokens together and often uses large matrix multiplications. Prefill strongly affects time to first token, usually called TTFT. - Decode generates later tokens one step at a time. Each step reads model weights and the growing cache. Decode strongly affects time per output token, usually called TPOT. Some systems report inter-token latency instead. 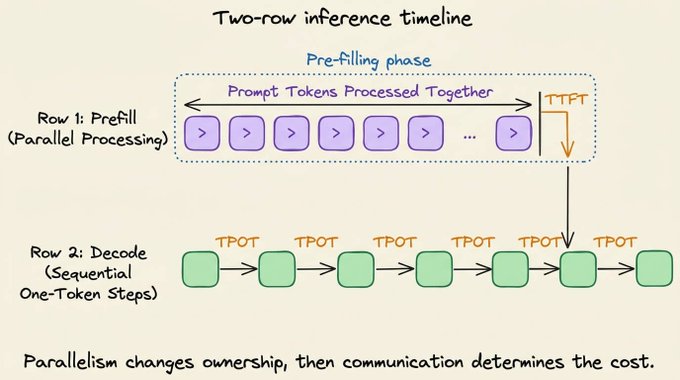 These phases use hardware differently. - Prefill usually executes large matrix multiplications across many prompt tokens. - Decode executes smaller operations and repeatedly reads weights and KV-cache data. A layout that shortens prefill can still slow decode by adding synchronization to every generated token. I have covered this in detail here if you want to dive deeper: > **Avi Chawla@_avichawla**: [原文链接](https://x.com/_avichawla/status/2071201619530956863) > Four resources usually limit the deployment. 1. Parameter memory determines whether the model fits. 2. KV-cache memory limits resident tokens and concurrent requests. 3. GPU compute time covers local matrix operations. 4. Communication time covers transfers and collectives between devices. The service metrics must match the underlying product target. - TTFT measures initial responsiveness. - TPOT measures streaming pace. - Request throughput counts completed requests. - Token throughput separates input and output work. - Goodput counts only requests meeting a service-level objective. Considering averages across any metric will inherently hide tail latency. That is why one must report the median and upper percentiles. 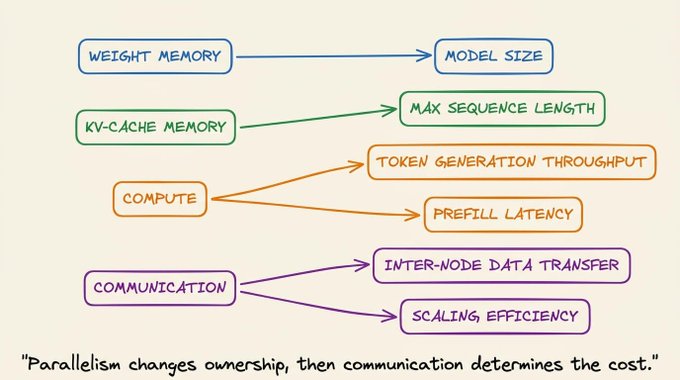 In addition to this, the p95 TTFT is the threshold that 95 percent of requests meet. Compare it with a service objective under the same request distribution. > Note. Tokens per second without a latency limit can be misleading. A saturated server may report high throughput while violating its tail-latency objective. These metrics tell us which service objective is failing. And the resource measurements tell us whether memory, compute, or communication caused it. The next decision is how to divide inference work across the GPUs to address that specific limit. That is the role of parallelism. Each method partitions a different part of the workload and introduces a different communication workload to be handled. The comparison below provides a map of the techniques we will examine next. 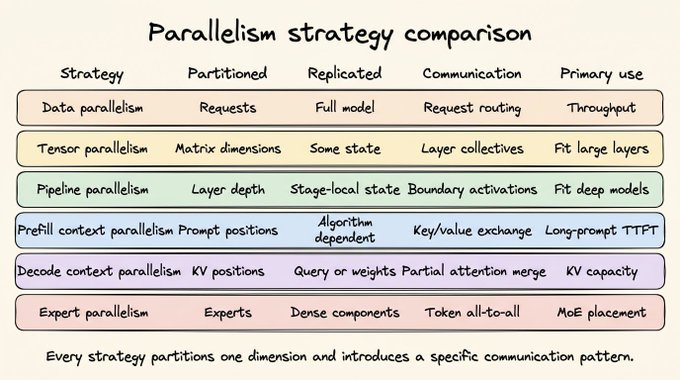 The communication column above is very important. While the transfer size itself is important, the frequency of transfer does too. For instance, a small collective repeated in every decoder layer can cost more than one larger activation transfer between pipeline stages. We will begin with data parallelism because it keeps each forward pass inside one replica. The other methods split a single forward pass across GPUs and therefore place communication directly on its execution path. # 1) Data parallelism Data parallel inference partitions requests. Each replica stores the complete model. It also owns an independent scheduler and KV cache. A router sends each request to one replica. 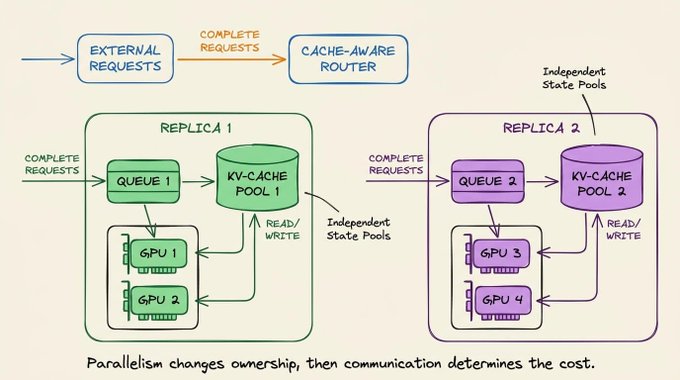 This differs from the training-time data parallelism. Since the inference phase has no requirement for gradient synchronization after each forward pass, one request remains local to its chosen replica. Suppose one two-GPU replica meets the latency target but cannot handle the incoming request rate. On our four-GPU server, data parallelism lets us run a second two-GPU replica. The replicas process different requests concurrently, so this configuration targets throughput rather than single-request latency. 1) The first deployment check is memory. Each replica must contain the complete two-GPU model layout, which means the four-GPU server stores the model twice. Data parallelism is therefore available only after one complete replica already fits. It cannot solve a model-placement problem by itself. 2) The second check is request routing. Once two replicas are active, the router decides which queue and KV-cache pool receives each request. Round-robin routing treats both replicas as equally available, even when one has a longer queue, less free KV capacity, or a reusable prefix already cached. 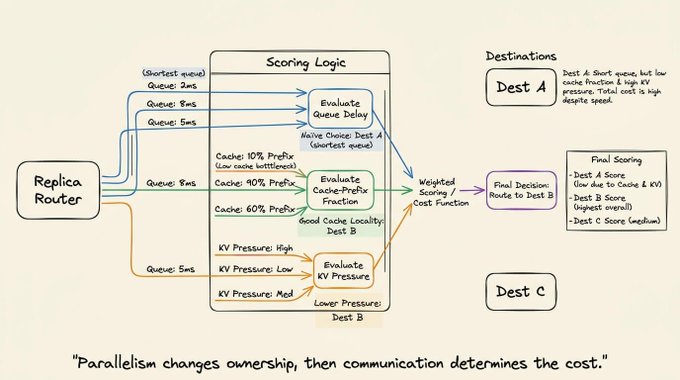 3) The third check is admission capacity. A request consumes little KV memory when it arrives, then consumes more as decode adds tokens. The router must reserve capacity for that growth. Otherwise, a replica can accept a request that fits during prefill but runs out of KV space during generation. Here's an engineering rule for this. After adding replicas, route with queue delay, available KV capacity, and prefix-cache hits. Reserve KV space for the expected decode length before admitting the request. This also explains when data parallelism does not help. At low traffic, the second replica remains idle and cannot reduce the latency of one request. Use it when a complete replica fits, and request concurrency is high enough to keep multiple replicas busy. # 2) Tensor parallelism Suppose the model does not fit on one GPU, but does fit when its largest weight matrices are divided across two. Data parallelism cannot solve this problem because every replica still needs a complete model layout. Tensor parallelism can because it makes several GPUs cooperate on the same transformer layer and the same request. This makes tensor parallelism a model-placement tool first. It can also reduce the compute time of a large operation, but only when the saved compute exceeds the cost of communicating between GPUs. The original Megatron-LM paper explains the common two-projection construction. We can see the dependency through one feed-forward block. The first projection creates an intermediate activation. The second projection returns it to the hidden width. The following diagram labels the input, both weight matrices, the activation function, the intermediate tensor, and the output. 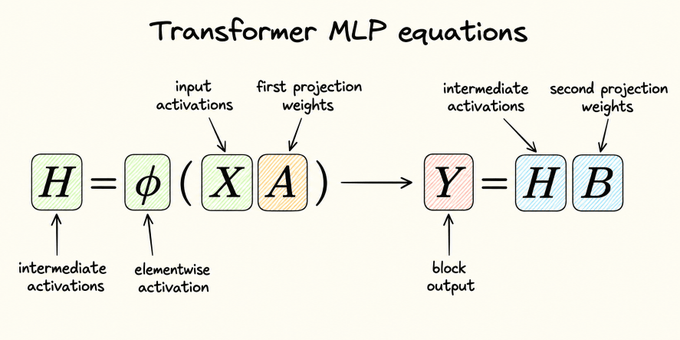 With two ranks, we split the first weight matrix by columns. Each rank computes different intermediate features. We split the second matrix by rows, so each rank consumes its matching feature slice. Both ranks then produce partial output tensors. 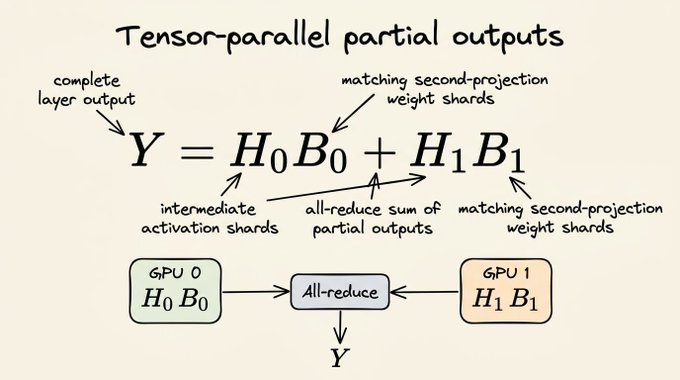 Each GPU computes one matrix product with local weight shards. The all-reduce sums those partial tensors. Neither GPU has the correct layer output before that collective completes. ``` import numpy as np def tensor_parallel_output(x, a_shards, b_shards, activation=np.tanh): partials = [] for a_shard, b_shard in zip(a_shards, b_shards, strict=True): hidden_shard = activation(x @ a_shard) partials.append(hidden_shard @ b_shard) return np.sum(partials, axis=0) ``` The function follows the two-rank data dependency. Each rank uses matching matrix shards. The reduction is required because every local result contains only part of the output. Running the tested example produces this output: ``` tensor_parallel_output = [[-3.294438, 1.406896]] ``` The unsharded MLP produces the same two values. The test checks every output element within NumPy's floating-point tolerance. 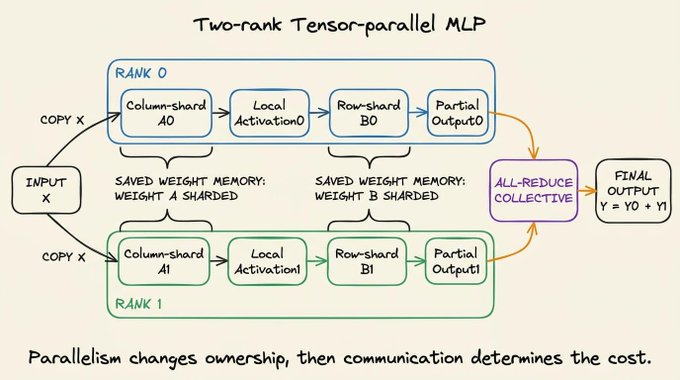 Attention uses the same broad idea. - Query, key, and value projections can split across heads. - The output projection then combines partial results. - Exact layouts depend on multi-head attention, grouped-query attention, and model-specific kernels. Before choosing a tensor-parallel size, two terms need to be clear. - A tensor-parallel group is the set of GPUs serving one request together. - A rank is one GPU process inside that group. TP2 has two ranks, while TP4 has four. 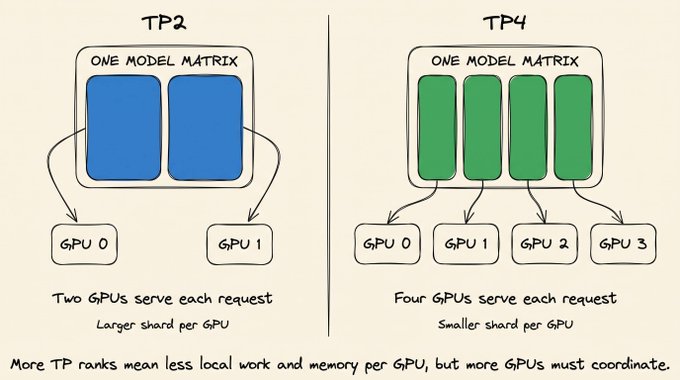 Increasing the TP degree divides each sharded matrix into more pieces. Consider a matrix with 8,192 output columns. - TP2 gives 4,096 columns to each rank. - TP4 assigns 2,048 columns to each rank. So each GPU stores fewer weights and performs a smaller matrix multiplication. That sounds like a direct improvement, but the layer cannot continue with separate partial results. The ranks must exchange or combine them. TP4 therefore performs less local work per rank while involving twice as many ranks as TP2. Whether TP4 is faster depends on the balance between saved computation and added communication. This gives us three deployment checks. 1) The first check is whether the model actually fits. Sharding reduces memory for the divided weight matrices. Other allocations may remain replicated on every rank. These include some parameters, temporary buffers, CUDA graphs, and KV-cache allocations. Measure peak memory on each GPU. Do not assume TP2 halves every allocation. 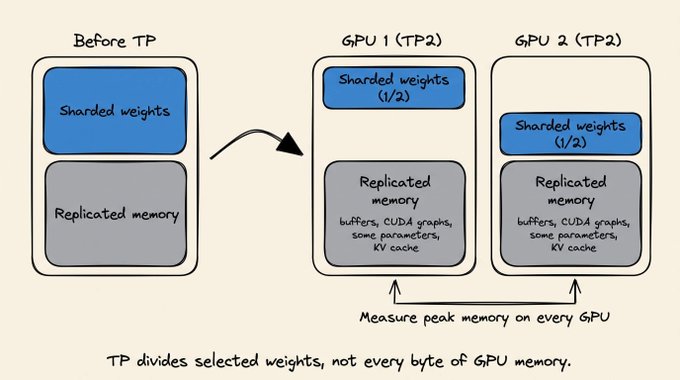 2) The second check is how long ranks spend communicating. Tensor-parallel collectives combine partial results inside many transformer layers. Slow links can leave GPUs waiting after each local calculation. This wait occurs during prefill and every decode step. 3) The third check is whether each rank still receives enough work. GPUs run large matrix multiplications efficiently because they inherently expose substantial parallel work. Raising the TP degree makes each local matrix smaller. At some point, the smaller calculation uses the GPU less efficiently, while the collective still occurs. Attention heads and quantization layouts impose additional constraints. For example, a head or quantization group may need to remain intact on one rank. The model shape and serving engine therefore determine which TP degrees are valid. TP2 can outperform one GPU on a large prefill because both ranks receive substantial work. TP4 may help further when compute still dominates. It may also be slower when smaller local operations no longer cover the added communication. Decode reaches this point sooner because one token provides less matrix work than a long prompt. 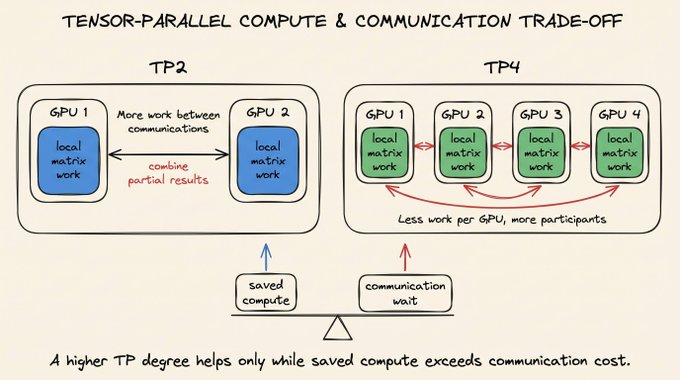 One common engineering rule is to use the smallest tensor-parallel degree that meets memory and latency requirements. Measure again after every increase. The links between ranks determine the communication cost. NVLink and NVSwitch differ from an inter-node network in latency and bandwidth. For our four-GPU server, start with TP2 because the model needs two GPUs. If that layout meets the latency target, the remaining two GPUs can form a second TP2 replica for throughput. Move to TP4 only if TP2 still fails a memory or single-request latency requirement. TP4 spends all four GPUs on each request and removes the option of running a second replica. Use tensor parallelism to solve a per-replica fit problem or a measured single-request compute limit. Do not increase the degree merely because more GPUs are available. # 3) Pipeline parallelism Tensor parallelism is expensive when its per-layer collectives cross a slow link. If the model must span GPUs with weaker connectivity, pipeline parallelism offers another placement, i.e., divide the model by depth, keep a contiguous group of layers on each stage, and transfer activations only when execution moves between stages. So stage zero runs the first layer group and sends its hidden states to stage one. The final stage runs the last group and produces logits. The request still visits every stage in order, but the weights for any one stage remain local to its GPU or tensor-parallel group. 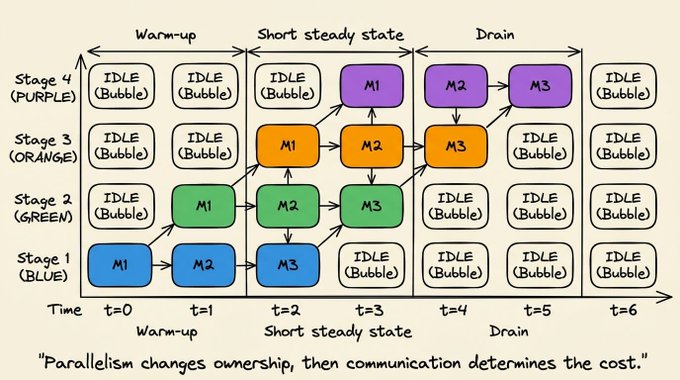 This differs from the traditional training pipeline. Inference has no backward pass. Continuous batching can keep several request groups moving. One autoregressive sequence still depends on its preceding token. Pipeline parallelism therefore solves a model-placement problem with less frequent communication than tensor parallelism. That makes it a useful candidate across nodes or GPUs without fast peer-to-peer links. It does not automatically reduce the latency of one request, because that request must still pass through all stages. Microbatching supplies independent work to the stages. 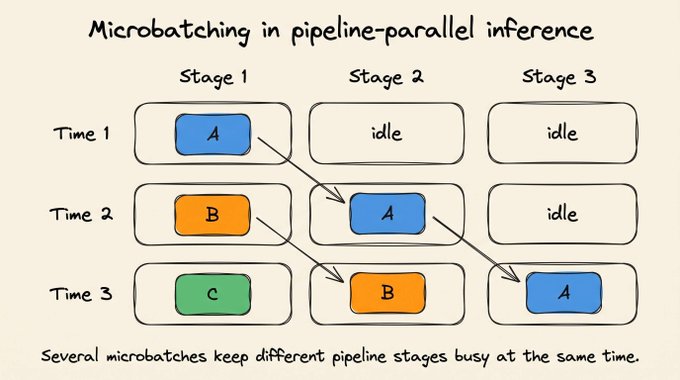 During online serving, those microbatches may contain different requests. Continuous batching changes membership as requests finish. The scheduler must preserve pipeline order while filling newly available slots. The first deployment check is whether the workload supplies enough independent requests to keep the stages busy. Stages are idle during warm-up and drain. Too few microbatches increase this idle fraction, so a lightly loaded online service may use only one stage at a time. The second check is stage balance. An 80-layer model suggests 20 layers per stage in PP4, but equal layer counts do not guarantee equal execution time or memory use. Embeddings, output layers, and heterogeneous blocks distort the split. The slowest stage sets throughput while faster stages wait. One engineering rule is to balance stages with measured execution time and memory use. Equal layer counts are only an initial placement. The third check is activation buffering and operational cost. Activations remain live while requests move through the pipeline. The scheduler must maintain order, and a failure on one stage affects the whole model instance. 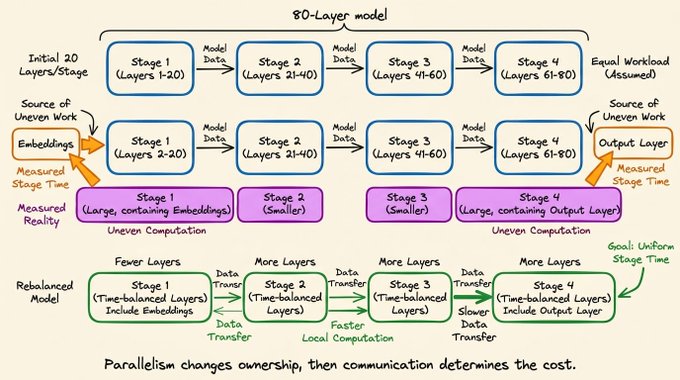 For our four-GPU server, PP4 is reasonable only if the model needs all four GPUs and enough requests are in flight to fill four stages. If the hardware has two fast GPU pairs connected by a slower path, PP2 with TP2 inside each stage can keep frequent tensor collectives within each pair and send activations across the slower boundary. Use pipeline parallelism when model depth must span devices and its stage-boundary transfers fit the topology better than per-layer tensor collectives. Avoid it for low-concurrency traffic unless model fit leaves no alternative. # 4) Context parallelism Assume the weights now fit, but long-context requests still fail one of two tests. A large prompt may miss the TTFT target during prefill, or its KV cache may consume so much memory that too few requests can remain active during decode. Context parallelism addresses these problems by partitioning sequence positions rather than model weights. The two failures require different mechanisms. - Prefill context parallelism, or PCP, divides the work for an incoming prompt. - Decode context parallelism, or DCP, divides the stored KV history used by later tokens. ## Prefill context parallelism Prefill context parallelism divides prompt tokens across ranks. Each rank computes query, key, and value tensors for its local token chunk. The attention algorithm must still expose every query to the required keys and values. One implementation gathers keys and values on every rank. Each rank evaluates its local queries against the complete history. This works only while the gathered tensors fit in memory. Another family circulates partial key-value chunks. Ring-attention-style algorithms merge partial attention results incrementally. They avoid materializing the full sequence everywhere, but require several communication rounds. 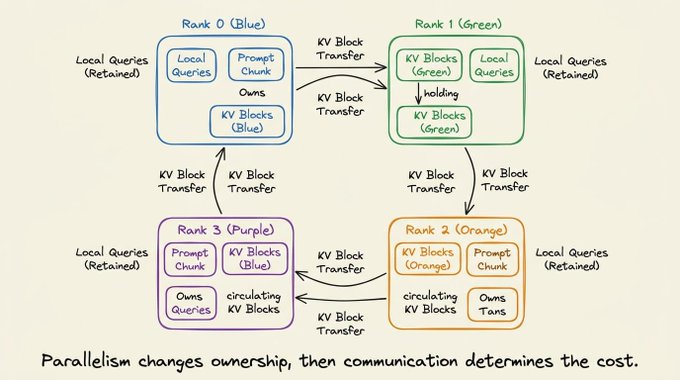 The practical question is where PCP crosses over from overhead to benefit. Measure TTFT across prompt-length buckets, not only at the maximum context length. Long prompts may contain enough attention work to offset the exchanges. Short prompts usually do not, so a mixed service may route only long-context requests to PCP-enabled workers. ## Decode context parallelism Decode context parallelism partitions the stored KV cache by sequence position. Each rank attends to its local history. The ranks then merge partial attention outputs and softmax statistics. ``` import numpy as np def merge_attention_partials(partials): global_max = max(part.maximum for part in partials) scales = [np.exp(part.maximum - global_max) for part in partials] denominator = sum( scale * part.exponential_sum for scale, part in zip(scales, partials, strict=True) ) numerator = sum( ( scale * part.weighted_value for scale, part in zip(scales, partials, strict=True) ), start=np.zeros_like(partials[0].weighted_value), ) return numerator / denominator ``` Each rank reports its local maximum, exponential sum, and weighted-value sum. The global maximum rescales every contribution before the final reductions. This preserves stable softmax across KV shards. The project file tests the result against unsharded attention. The local run produces this merged attention output: ``` merged_attention_output = [0.769627, 0.779901] ``` The full attention calculation produces the same result. This verifies that splitting the KV history does not change the attention output for the test input. The maximum is needed because exponentials can overflow. Subtracting the global maximum keeps every exponent at most one. The scaled denominators and weighted-value sums then reconstruct the unsharded attention result within normal floating-point tolerance. 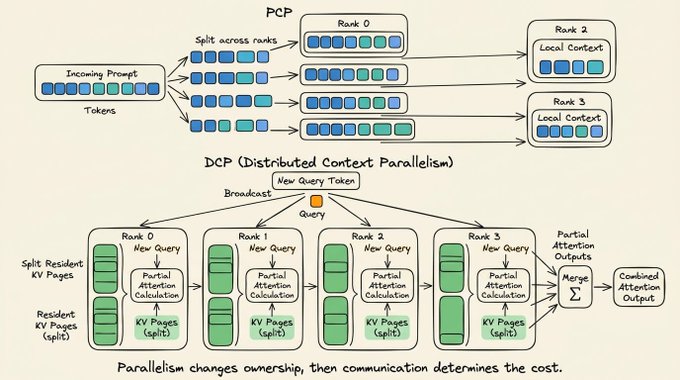 1) The first DCP check is memory. Record resident KV tokens and maximum concurrency before and after sharding. 2) The second is decode cost. Every decoder layer must merge partial attention results, which can increase TPOT. DCP is useful only when the extra KV capacity or supported context length is worth that repeated merge. Sequence parallelism is related, but not identical. Megatron-style sequence parallelism commonly shards activations around normalization and similar operations. Context parallelism partitions attention across context positions. Frameworks sometimes use these labels differently. For our four-GPU server, keep ordinary chats on the baseline TP2 replicas. Route the occasional long prompt to a PCP-enabled group if prompt-length tests show a TTFT improvement. Add DCP only if KV memory, rather than weight memory or compute, limits the number or length of active requests. PCP solves long-prompt compute. DCP solves long-history storage. Treat them as separate decisions and enable neither without a prompt-length or KV-capacity measurement that justifies it. # 5) Expert parallelism Expert parallelism applies only when the model contains mixture-of-experts layers. In that case, storing every expert on every GPU can dominate parameter memory even though each token uses only a few experts. Expert parallelism places different experts on different ranks so one model instance can distribute that expert-weight memory. 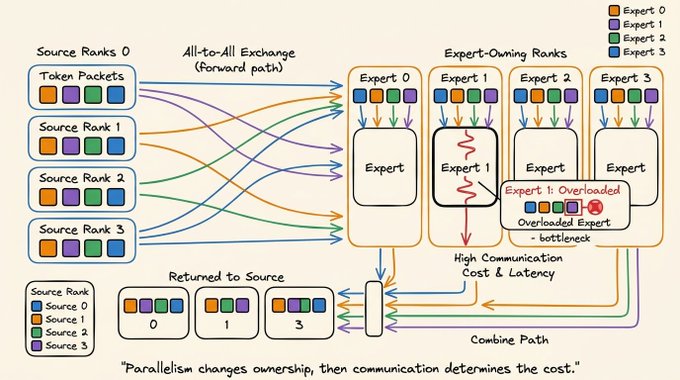 At runtime, the router chooses experts for each token. The system sends each token representation to the ranks that own those experts, runs the local expert networks, and returns their outputs. The placement saves memory, but it puts data-dependent all-to-all traffic on the request path. > **Avi Chawla@_avichawla**: [原文链接](https://x.com/_avichawla/status/2100876555409039605) > The first deployment check is placement. Count expert-weight memory per rank and verify that shared attention, embeddings, buffers, and KV cache still fit. Expert parallelism does not determine how the dense parts of the model are placed. The second check is routing traffic. Unlike dense tensor parallelism, the transferred bytes depend on which experts the router selects. Measure bytes sent per rank and all-to-all time using the real prompt distribution. The third check is imbalance. Token counts can skew across experts, and the collective finishes when the busiest rank finishes. Average load hides this straggler. Measure the maximum tokens per expert, local expert time, and post-compute wait time. Expert capacity, padding, and load-balancing policy can change both runtime and, if tokens are dropped, model behavior. On four GPUs, an MoE model might distribute one quarter of its experts to each GPU while using TP or DP for attention and other dense operations. This layout is attractive when expert weights are the fit problem and routing remains balanced. It is unattractive when the expert set already fits comfortably or all-to-all communication dominates layer time. > Attention and expert layers need not use the same partition. Dense attention may use DP or TP while MoE layers use EP. Use expert parallelism to solve expert-weight placement. Validate it with per-rank routing and imbalance measurements, not with average token throughput alone. # 6) Hybrid parallelism One parallel method often solves only part of the deployment. Tensor parallelism may make a model fit within a node, pipeline parallelism may extend it across nodes, and data parallelism may then add enough replicas for the request rate. A hybrid layout composes those choices, but each added axis also adds its own scheduler or communication path. For independent dense-model groups, the worker count is the product of the data, pipeline, and tensor-parallel degrees. 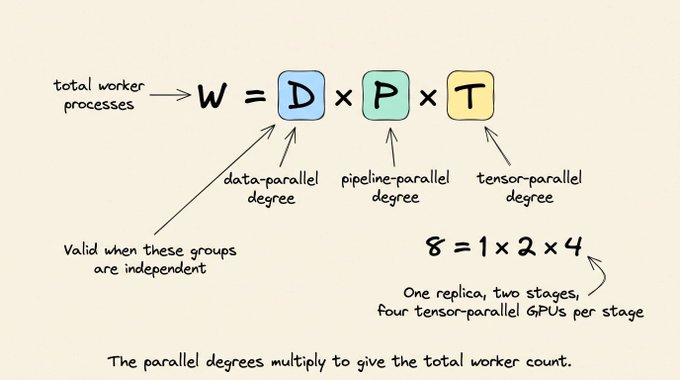 Some context-parallel methods reuse existing ranks. Expert groups can also interact with data groups differently. Consider eight GPUs across two four-GPU nodes. The intra-node links have higher bandwidth and lower latency. One candidate layout uses TP4 inside each node and PP2 across nodes. This keeps frequent layer collectives local. Only stage-boundary activations cross the slower network. All eight GPUs extend one model instance. If the model fits on four GPUs, another layout becomes attractive. TP4 within each node and DP2 across nodes creates two replicas. Requests no longer depend on the cross-node path. 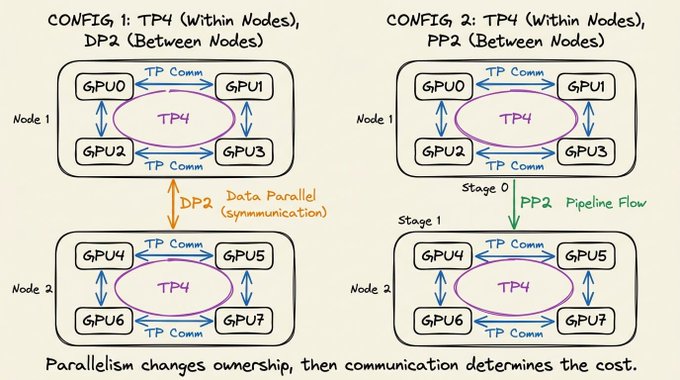 Build a hybrid layout in that order. First choose the smallest TP group that makes each stage fit, and keep it on the fastest links. Add PP only when the model must cross a slower boundary. Add DP after one complete model instance fits. Add CP for a measured long-context problem and EP only for MoE expert placement. This order prevents a common mistake: multiplying parallel degrees before deciding which resource each one fixes. Every new axis should have one stated job and one measurement that verifies it. Prefill and decode disaggregation is useful when the two phases need different hardware or scaling ratios. Separate worker pools handle each phase, so the prefill pool can favor large prompt operations while the decode pool favors KV capacity and steady token generation. This introduces a KV-state transfer and coordination boundary. 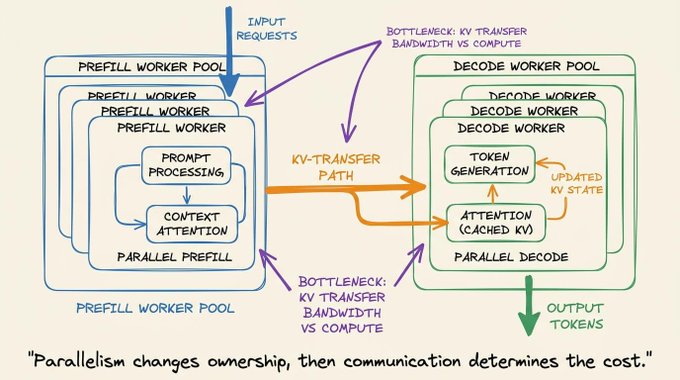 > Disaggregation does not replace TP, PP, or CP. Each worker pool still needs a model-placement plan. A hybrid layout is successful only when each communication pattern matches the physical network. Place the most frequent collectives on the fastest links, then verify the complete layout under the production request mix. # A practical decision framework Use this framework from top to bottom. Stop after selecting the smallest change that addresses the measured limit, benchmark it, and return to the framework only if another limit remains. Stacking every available parallel mode makes attribution harder and can add communication without solving a problem. Start by determining whether one complete replica fits on one GPU while preserving KV-cache capacity for the target concurrency. 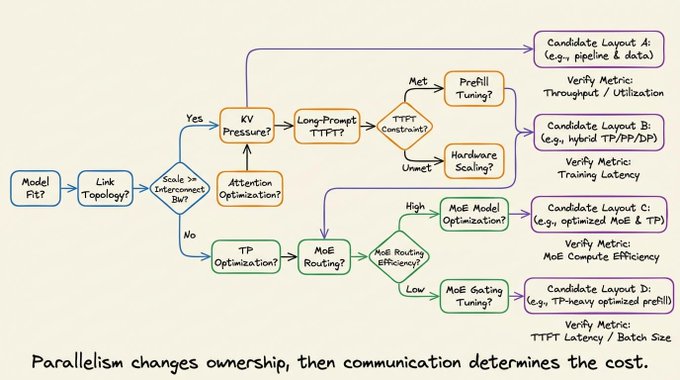 - If it fits, start with one replica. Add data parallelism when traffic can use another scheduler. Preserve prefix locality in the router. - If it does not fit, find the smallest tensor-parallel degree that works. Benchmark decode latency at that degree. Consider pipeline parallelism when layer groups have similar execution time or peer links are slow. If the model must span nodes, keep TP within the faster intra-node links. Test PP across nodes. Measure stage balance before increasing load.  Long prompts create separate questions. Evaluate PCP when TTFT fails at large input lengths. Evaluate DCP when KV capacity limits concurrency or long-context decode. MoE models need one more branch. If expert weights cause the fit problem, test EP while tracking token imbalance and all-to-all time separately. Do not add EP to a dense model or infer its benefit from total GPU utilization. 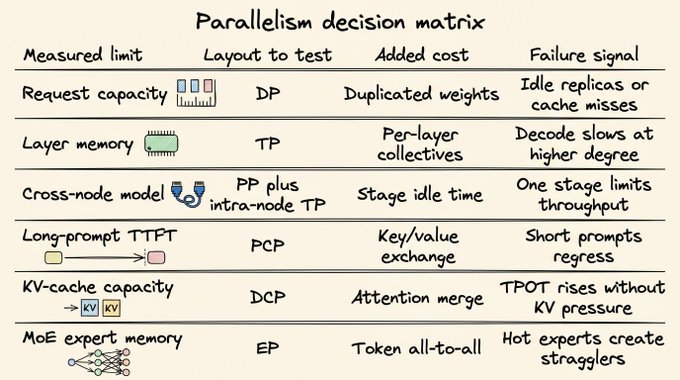 > Enable a parallel mode only when measurements identify the resource limit it addresses. Identify the constrained resource first. Then choose a partition whose communication fits the available interconnect. Parallelism is typically a placement decision, not a GPU-count setting. Start with the resource that prevents the service from meeting its target. Then choose the smallest layout change that addresses that constraint. Every split introduces communication, synchronization, or scheduling overhead. The saved memory or compute must outweigh that cost on the actual hardware and request distribution. The best layout is the simplest one that meets the latency and throughput objectives. Everything else still needs measurement. That's a wrap! If you enjoyed this: Find me → [@_avichawla](https://x.com/@_avichawla) Every day, I share tutorials and insights on DS, ML, LLMs, and RAGs. ## 相关链接 - [Avi Chawla](https://x.com/_avichawla) - [@_avichawla](https://x.com/_avichawla) - [1.8K](https://x.com/_avichawla/status/2107427400779026843/analytics) - [Jun 28](https://x.com/_avichawla/status/2071201619530956863) - [308K](https://x.com/_avichawla/status/2071201619530956863/analytics) - [Sep 18](https://x.com/_avichawla/status/2100876555409039605) - [147K](https://x.com/_avichawla/status/2100876555409039605/analytics) - [@_avichawla](https://x.com/@_avichawla) - [Upgrade to Premium](https://x.com/i/premium_sign_up) - [7:07 PM · Oct 6, 2026](https://x.com/_avichawla/status/2107427400779026843) - [1,810 Views](https://x.com/_avichawla/status/2107427400779026843/analytics) --- *导出时间: 2026/10/6 20:46:28* --- ## 中文翻译 # LLM 推理的并行策略,清晰讲解 **作者**: Avi Chawla **日期**: 2026-06-28T11:58:41.000Z **来源**: [https://x.com/_avichawla/status/2107427400779026843](https://x.com/_avichawla/status/2107427400779026843) ---  你需要了解的一切——如何在 GPU 之间切分 LLM 推理,而不让性能损耗在通信上。本文涵盖数据并行、张量并行、流水线并行、上下文并行和专家并行,如何组合它们,以及决定哪种布局适合你的模型、硬件和工作负载的部署检查。 四块 GPU 提供四个独立的内存空间和四个处理器。它们不会表现得像一块容量四倍的 GPU。 一块 GPU 上运行的内核,若不传输数据,就无法使用存储在另一块 GPU 上的权重或 KV 缓存块。  因此,分布式推理首先要解决数据放置问题。推理引擎将权重、激活值、请求以及缓存的键值分配到具体的设备上。 任何跨设备的依赖都会在请求路径上增加一次传输或集合通信操作。 工程上的难题在于选择一种放置方案,既能消除当前瓶颈,又不会增加超出硬件承受能力的通信量。这正是我们要解决的问题。 读完本文后,你应当能够检视一个模型、工作负载、GPU 拓扑和延迟目标,然后选择一个站得住脚的初始布局。 我们将用五个问题来比较每种策略: - 划分了什么状态? - 哪些内容被复制保留? - 什么数据跨过了互联? - 该传输多久发生一次? - 该布局提升的是内存容量、请求延迟还是吞吐量? 在整篇文章中,我们假设使用同一台四 GPU 服务器。该模型至少需要其中两块 GPU,且服务器同时接收短对话和长上下文请求。我们将保持模型、工作负载和硬件不变,只改变推理工作在 GPU 之间的划分方式。 > 我们将在整篇文章中使用“集合通信”这个词。集合通信是指多个 GPU 作为一组交换或合并数据的操作。例如,两个 GPU 可能分别计算一个层输出的不同部分,一个 all-reduce 操作将这些部分相加,并把完整结果交给两个 GPU。其他集合通信操作在参与 GPU 之间移动不同的数据片段。每个参与的 GPU 必须完成自己那部分,集合通信才能结束。因此,一个慢的 GPU 或连接可能拖慢整个组。这与直接传输不同——直接传输是一个 GPU 向另一个 GPU 发送数据。 # LLM 推理的工作原理 在理解如何优化 LLM 推理之前,我们首先需要了解 LLM 推理是如何工作的。 LLM 推理分为两个阶段。  - Prefill(预填充)处理提示词并构建其键值缓存。它一次性处理许多提示词 token,通常执行大型矩阵乘法。Prefill 强烈影响首 token 时间,通常称为 TTFT。 - Decode(解码)一次一步地生成后续 token。每一步都要读取模型权重和不断增长的缓存。Decode 强烈影响每个输出 token 的时间,通常称为 TPOT。有些系统报告的是 token 间延迟。  这两个阶段对硬件的使用方式不同。 - Prefill 通常对大量提示词 token 执行大型矩阵乘法。 - Decode 执行较小的操作,并反复读取权重和 KV 缓存数据。一个缩短 prefill 的布局仍可能因为给每个生成 token 增加同步而拖慢 decode。 如果你想深入了解,我在这里详细讲过: > **Avi Chawla@_avichawla**: [原文链接](https://x.com/_avichawla/status/2071201619530956863) > 通常有四种资源限制部署。 1. 参数内存决定模型能否装下。 2. KV 缓存内存限制驻留 token 数量和并发请求数。 3. GPU 计算时间涵盖本地矩阵操作。 4. 通信时间涵盖设备间的传输和集合通信。 服务指标必须与底层的产品目标相匹配。 - TTFT 衡量初始响应速度。 - TPOT 衡量流式输出的节奏。 - 请求吞吐量统计已完成的请求数。 - Token 吞吐量区分输入和输出工作。 - 有效吞吐量只统计满足服务水平目标的请求。 只看任何指标的平均值都会掩盖尾延迟。这就是为什么必须报告中位数和较高的百分位数。  此外,p95 TTFT 是 95% 的请求都能达到的阈值。应将其与相同请求分布下的服务目标进行比较。 > 注意。没有延迟上限的每秒 token 数可能具有误导性。一台饱和的服务器可能在违反尾延迟目标的同时报告高吞吐量。 这些指标告诉我们哪个服务目标没有达标。而资源测量则告诉我们是内存、计算还是通信导致的。 下一个决策是如何在 GPU 之间划分推理工作,以解决那个具体的瓶颈。 这就是并行的作用。每种方法划分工作负载的不同部分,并引入不同的通信工作负载需要处理。下面的对比为我们接下来要研究的技术提供了一张地图。  上表中的通信一列非常重要。传输大小本身固然重要,但传输频率同样重要。例如,在每个解码器层中重复执行的小型集合通信,其代价可能超过流水线阶段之间一次较大的激活值传输。 我们将从数据并行开始,因为它把每次前向传播都保留在一个副本内。其他方法将单次前向传播拆分到多个 GPU 上,因此把通信直接置于其执行路径上。 # 1) 数据并行 数据并行推理划分的是请求。 每个副本存储完整的模型。它还拥有独立的调度器和 KV 缓存。路由器将每个请求发送到一个副本。  这与训练时的数据并行不同。 由于推理阶段无需在每次前向传播后同步梯度,一个请求始终留在它被分配到的副本内。 假设一个双 GPU 副本能满足延迟目标,但无法处理进来的请求速率。 在我们的四 GPU 服务器上,数据并行让我们可以运行第二个双 GPU 副本。两个副本并发处理不同请求,因此这种配置针对的是吞吐量而非单请求延迟。 1) 第一个部署检查是内存。 每个副本必须包含完整的双 GPU 模型布局,这意味着四 GPU 服务器要存储两份模型。 因此,只有在一个完整副本已经能装下之后,数据并行才可用。它本身无法解决模型放置问题。 2) 第二个检查是请求路由。 一旦两个副本都在运行,路由器就要决定每个请求进入哪个队列和哪个 KV 缓存池。 轮询路由把两个副本视为同等可用,即使其中一个队列更长、KV 剩余容量更少,或已缓存了可复用的前缀。  3) 第三个检查是准入容量。 一个请求在到达时只占用少量 KV 内存,随着 decode 添加 token 会占用更多。 路由器必须为这种增长预留容量。否则,副本可能接受一个在 prefill 期间装得下、但在生成期间耗尽 KV 空间的请求。 这里有一条工程规则。添加副本之后,基于队列延迟、可用 KV 容量和前缀缓存命中进行路由。在准入请求之前,为预期的 decode 长度预留 KV 空间。 这也解释了数据并行何时没有帮助。 在低流量时,第二个副本闲置,无法降低单个请求的延迟。只有当完整副本装得下、且请求并发足够高能让多个副本保持繁忙时才使用它。 # 2) 张量并行 假设模型装不进一块 GPU,但当其最大的权重矩阵被划分到两块 GPU 时就能装下。 数据并行无法解决这个问题,因为每个副本仍需要完整的模型布局。张量并行可以,因为它让多个 GPU 在同一个 Transformer 层、同一个请求上协作。 这使得张量并行首先是模型放置工具。它也可以减少大型操作的计算时间,但前提是节省的计算量超过 GPU 间通信的成本。 最初的 Megatron-LM 论文解释了常见的双投影构造。我们可以通过一个前馈块看到这种依赖关系。 第一个投影产生中间激活。第二个投影将其还原到隐藏层宽度。 下图标注了输入、两个权重矩阵、激活函数、中间张量和输出。  使用两个秩时,我们按列切分第一个权重矩阵。每个秩计算不同的中间特征。 第二个矩阵按行切分,因此每个秩消费与其匹配的特征切片。然后两个秩各自产生部分输出张量。  每个 GPU 用本地权重分片计算一个矩阵乘积。all-reduce 对这些部分张量求和。在该集合通信完成之前,两个 GPU 都没有得到正确的层输出。 ``` import numpy as np def tensor_parallel_output(x, a_shards, b_shards, activation=np.tanh): partials = [] for a_shard, b_shard in zip(a_shards, b_shards, strict=True): hidden_shard = activation(x @ a_shard) partials.append(hidden_shard @ b_shard) return np.sum(partials, axis=0) ``` 该函数遵循双秩数据依赖。每个秩使用匹配的矩阵分片。归约是必需的,因为每个本地结果只包含输出的一部分。 运行测试示例产生如下输出: ``` tensor_parallel_output = [[-3.294438, 1.406896]] ``` 未分片的 MLP 产生相同的两个值。测试在 NumPy 的浮点容差范围内检查每一个输出元素。  注意力机制采用大致相同的思路。 - 查询、键和值投影可以按头拆分。 - 输出投影随后合并部分结果。 - 具体布局取决于多头注意力、分组查询注意力以及模型特定的内核。 在选择张量并行大小之前,需要弄清楚两个术语。 - 张量并行组是共同服务一个请求的一组 GPU。 - 秩是该组内的一个 GPU 进程。TP2 有两个秩,TP4 有四个。  提高 TP 度会把每个分片矩阵切分得更多。考虑一个有 8,192 个输出列的矩阵。 - TP2 给每个秩 4,096 列。 - TP4 给每个秩 2,048 列。 因此每块 GPU 存储更少的权重并执行更小的矩阵乘法。 这听起来像是直接的改进,但该层不能在只有各自部分结果的情况下继续。 各秩必须交换或合并这些结果。 因此 TP4 在让每个秩的本地工作更少的同时,参与的秩数量是 TP2 的两倍。TP4 是否更快取决于节省的计算与增加的通信之间的平衡。 这给了我们三个部署检查。 1) 第一个检查是模型是否真的装下了。 分片减少了被切分的权重矩阵的内存。其他分配可能在每个秩上仍被复制保留。 这些包括某些参数、临时缓冲区、CUDA 图和 KV 缓存分配。要测量每块 GPU 的峰值内存。不要假设 TP2 把每项分配都减半。  2) 第二个检查是各秩花在通信上的时间。 张量并行集合通信在许多 Transformer 层内合并部分结果。慢速链路可能让 GPU 在每次本地计算后陷入等待。这种等待发生在 prefill 期间和每个 decode 步骤中。 3) 第三个检查是每个秩是否仍获得足够的工作量。 GPU 能高效运行大型矩阵乘法,因为它们天然暴露出大量并行工作。 提高 TP 度使每个本地矩阵更小。到某个程度时,更小的计算对 GPU 的利用效率降低,而集合通信仍在发生。 注意力头数量和量化布局带来额外约束。例如,一个注意力头或量化组可能需要完整地保留在一个秩上。因此,模型的形状和推理引擎决定了哪些 TP 度是有效的。 在大规模 prefill 上,TP2 可能胜过单 GPU,因为两个秩都能获得充足的工作。 当计算仍占主导时,TP4 可能带来进一步帮助。当更小的本地操作不再能覆盖增加的通信时,它也可能更慢。 Decode 更早到达这个临界点,因为一个 token 提供的矩阵工作量少于一段长提示词。  一条常见的工程规则是使用满足内存和延迟要求的最小张量并行度。每次提高后都要重新测量。 秩之间的链路决定通信成本。NVLink 和 NVSwitch 在延迟和带宽上不同于节点间网络。 对于我们的四 GPU 服务器,从 TP2 开始,因为模型需要两块 GPU。 如果该布局满足延迟目标,剩下的两块 GPU 可以组成第二个 TP2 副本以提升吞吐量。 只有当 TP2 仍然无法满足内存或单请求延迟要求时,才转到 TP4。TP4 把全部四块 GPU 花在每个请求上,并放弃了运行第二个副本的选项。 用张量并行解决单副本装不下或实测的单请求计算瓶颈。不要仅仅因为有更多 GPU 就提高并行度。 # 3) 流水线并行 当张量并行的逐层集合通信跨越慢速链路时,代价很高。 如果模型必须跨越连接较弱的 GPU,流水线并行提供了另一种放置方式,即按深度划分模型,在每个阶段保留连续的一组层,只在执行跨阶段移动时传输激活值。 阶段零运行第一组层,并把其隐藏状态发送给阶段一。最后一个阶段运行最后一组层并产生 logits。 请求仍按顺序访问每个阶段,但任一阶段的权重都保留在其 GPU 或张量并行组的本地。  这与传统的训练流水线不同。 推理没有反向传播。连续批处理可以让多个请求组持续流动。一条自回归序列仍然依赖其前一个 token。 因此,流水线并行解决模型放置问题所需的通信频率低于张量并行。 这使它成为跨节点或没有快速点对点链路的 GPU 上的有用候选。它不会自动降低单个请求的延迟,因为该请求仍必须经过所有阶段。 微批处理为各阶段提供独立的工作。  在在线服务期间,这些微批可能包含不同的请求。连续批处理随着请求完成而改变成员。调度器必须在填充新空位的同时保持流水线顺序。 第一个部署检查是工作负载是否提供了足够多的独立请求来让各阶段保持忙碌。 阶段在预热和排空期间是空闲的。微批太少会增加这种空闲比例,因此负载较轻的在线服务可能一次只用到一个阶段。 第二个检查是阶段平衡。 一个 80 层的模型在 PP4 下意味着每阶段 20 层,但相同的层数并不能保证相同的执行时间或内存占用。嵌入层、输出层和异构块会扭曲这种划分。最慢的阶段决定吞吐量,而较快的阶段在等待。 一条工程规则是用实测的执行时间和内存占用来平衡各阶段。相等的层数只是初始放置。 第三个检查是激活值缓冲和运维成本。激活值在请求流经流水线期间保持存活。调度器必须维护顺序,且一个阶段的故障会影响整个模型实例。  对于我们的四 GPU 服务器,只有当模型需要全部四块 GPU 且有足够多的请求在途以填满四个阶段时,PP4 才合理。 如果硬件是两对由较慢路径连接的高速 GPU 对,则每个阶段内使用 TP2 的 PP2 可以把频繁的张量集合通信保持在每对内部,而只让激活值跨越较慢的边界。 当模型深度必须跨越设备、且其阶段边界传输比逐层张量集合通信更符合拓扑时,使用流水线并行。除非模型放置别无选择,否则避免将其用于低并发流量。 # 4) 上下文并行 假设权重现在装得下了,但长上下文请求仍然通不过以下两个测试之一。 一段大提示词可能在 prefill 期间错过 TTFT 目标,或者其 KV 缓存可能占用太多内存,以至于 decode 期间能保持活跃的请求数太少。 上下文并行通过划分序列位置而非模型权重来解决这些问题。 这两种失败需要不同的机制。 - Prefill 上下文并行(PCP)划分传入提示词的工作。 - Decode 上下文并行(DCP)划分后续 token 所使用的已存储 KV 历史。 ## Prefill 上下文并行 Prefill 上下文并行把提示词 token 划分到各秩。每个秩为其本地 token 块计算查询、键和值张量。注意力算法仍必须让每个查询接触到所需的键和值。 一种实现在每个秩上收集键和值。每个秩用其本地查询评估完整历史。 只有在收集来的张量能装进内存时才可行。 另一类做法循环传递部分键值块。环形注意力风格的算法增量地合并部分注意力结果。 它们避免了在所有地方实体化完整序列,但需要多轮通信。  实际问题是 PCP 从开销转为收益的临界点在哪里。要跨提示词长度分桶测量 TTFT,而不仅在最大上下文长度处。 长提示词可能包含足够的注意力计算量来抵消交换开销。短提示词通常不能,因此混合型服务可以只把长上下文请求路由到启用 PCP 的工作节点。 ## Decode 上下文并行 Decode 上下文并行按序列位置划分已存储的 KV 缓存。 每个秩只关注其本地历史。然后各秩合并部分注意力输出和 softmax 统计量。 ``` import numpy as np def merge_attention_partials(partials): global_max = max(part.maximum for part in partials) scales = [np.exp(part.maximum - global_max) for part in partials] denominator = sum( scale * part.exponential_sum for scale, part in zip(scales, partials, strict=True) ) numerator = sum( ( scale * part.weighted_value for scale, part in zip(scales, partials, strict=True) ), start=np.zeros_like(partials[0].weighted_value), ) return numerator / denominator ``` 每个秩报告其本地最大值、指数和以及加权值和。 全局最大值在最终归约之前重新缩放每个贡献。这在 KV 分片之间保持了稳定的 softmax。项目文件针对未分片注意力测试了该结果。 本地运行产生如下合并注意力输出: ``` merged_attention_output = [0.769627, 0.779901] ``` 完整注意力计算产生相同结果。这验证了切分 KV 历史不会改变该测试输入的注意力输出。 最大值是必需的,因为指数可能溢出。减去全局最大值使每个指数最多为 1。 缩放后的分母和加权值和随后在正常浮点容差范围内重建出未分片的注意力结果。  1) 第一个 DCP 检查是内存。 记录分片前后的驻留 KV token 数和最大并发数。 2) 第二个是 decode 成本。 每个解码器层都必须合并部分注意力结果,这可能增加 TPOT。只有当额外的 KV 容量或支持的上下文长度值得这种反复合并时,DCP 才有用。 序列并行与之相关但不相同。 Megatron 风格的序列并行通常围绕归一化等操作切分激活值。上下文并行则按上下文位置划分注意力。各框架有时对这些标签的使用不一致。 对于我们的四 GPU 服务器,让普通聊天保留在基线 TP2 副本上。如果提示词长度测试显示 TTFT 有改善,则把偶尔出现的长提示词路由到启用 PCP 的组。 只有当限制活跃请求数量或长度的是 KV 内存而非权重内存或计算时,才添加 DCP。 PCP 解决长提示词的计算问题。DCP 解决长历史的存储问题。把它们当作两个独立的决策,没有提示词长度或 KV 容量的测量支撑时,两者都不要启用。 # 5) 专家并行 专家并行只在模型包含混合专家层时适用。 在这种情况下,把每个专家都存储在每块 GPU 上可能主导参数内存,即使每个 token 只使用少数几个专家。 专家并行把不同的专家放在不同的秩上,使一个模型实例能够分担专家权重的内存。  在运行时,路由器为每个 token 选择专家。系统把每个 token 的表示发送到拥有那些专家的秩,运行本地专家网络,并返回其输出。 这种放置节省了内存,但它把数据依赖的 all-to-all 流量放在了请求路径上。 > **Avi Chawla@_avichawla**: [原文链接](https://x.com/_avichawla/status/2100876555409039605) > 第一个部署检查是放置。 统计每个秩的专家权重内存,并验证共享的注意力、嵌入、缓冲区和 KV 缓存仍然装得下。专家并行不决定模型稠密部分的放置方式。 第二个检查是路由流量。与稠密张量并行不同,传输的字节数取决于路由器选择了哪些专家。使用真实的提示词分布测量每个秩发送的字节数和 all-to-all 时间。 第三个检查是不均衡。token 数量可能在专家之间偏斜,而集合通信要等最繁忙的秩完成才算结束。 平均负载掩盖了这种掉队者。要测量每个专家的最大 token 数、本地专家时间和计算后的等待时间。专家容量、填充和负载均衡策略会改变运行时间,若发生 token 丢弃,还会改变模型行为。 在四块 GPU 上,一个 MoE 模型可能把四分之一的专家分给每块 GPU,同时对注意力和其他稠密操作使用 TP 或 DP。 当专家权重是放置瓶颈且路由保持均衡时,这种布局很有吸引力。当专家集合已经轻松装下、或 all-to-all 通信主导层时间时,它就不那么有吸引力了。 > 注意力层和专家层不必使用相同的划分。稠密注意力可以使用 DP 或 TP,而 MoE 层使用 EP。 用专家并行解决专家权重的放置问题。用每秩路由和不均衡测量来验证它,而不是仅凭平均 token 吞吐量。 # 6) 混合并行 单一的并行方法往往只能解决部署的一部分问题。 张量并行可能让模型装进一个节点,流水线并行可能把它扩展到多个节点,数据并行随后可以为请求速率增加足够的副本。 混合布局组合这些选择,但每个新增的维度也会增加自己的调度器或通信路径。 对于独立的稠密模型组,工作节点数是数据并行、流水线并行和张量并行度的乘积。  一些上下文并行方法复用现有的秩。专家组也可以以不同方式与数据组交互。 考虑两台四 GPU 节点共八块 GPU。节点内链路具有更高带宽和更低延迟。一个候选布局在每个节点内使用 TP4,跨节点使用 PP2。 这使频繁的层集合通信保持在本地。只有阶段边界的激活值跨越较慢的网络。全部八块 GPU 扩展同一个模型实例。 如果模型能装进四块 GPU,另一个布局就变得有吸引力。每个节点内 TP4、跨节点 DP2 会创建两个副本。请求不再依赖跨节点路径。  按此顺序构建混合布局。首先选择使每个阶段能装下的最小 TP 组,并将其放在最快的链路上。 只有当模型必须跨越较慢的边界时才添加 PP。在一个完整模型实例装下之后添加 DP。为实测的长上下文问题添加 CP,仅为 MoE 专家放置添加 EP。 这个顺序可以避免一个常见错误:在决定每个并行度解决什么资源瓶颈之前就相乘各并行度。每个新维度都应有一个明确的任务,以及一个验证它的测量。 当两个阶段需要不同的硬件或不同的扩展比例时,prefill 和 decode 分离是有用的。 分开的工作节点池处理各自阶段,因此 prefill 池可以偏重大型提示词操作,而 decode 池偏重 KV 容量和稳定的 token 生成。这引入了 KV 状态传输和协调边界。  > 分离并不取代 TP、PP 或 CP。每个工作节点池仍需要一个模型放置方案。 只有当每种通信模式都与物理网络相匹配时,混合布局才是成功的。把最频繁的集合通信放在最快的链路上,然后在生产请求混合下验证完整布局。 # 一个实用的决策框架 自上而下使用这个框架。 选定解决实测瓶颈的最小改动后就停止,进行基准测试,只有在仍有其他瓶颈时才回到框架。 堆叠所有可用的并行模式会让归因更困难,并可能在不解决问题的情况下增加通信。 首先确定一个完整副本是否能装进一块 GPU,同时为目标并发保留 KV 缓存容量。  - 如果装得下,从一个副本开始。当流量能利用另一个调度器时添加数据并行。在路由器中保持前缀局部性。 - 如果装不下,找到可行的最小张量并行度。在该并行度下对 decode 延迟进行基准测试。当各层组的执行时间相近或点对点链路较慢时,考虑流水线并行。 如果模型必须跨越节点,让 TP 保持在较快的节点内链路中。跨节点测试 PP。在增加负载前测量阶段平衡。  长提示词带来单独的问题。当 TTFT 在大输入长度下不达标时,评估 PCP。当 KV 容量限制并发或长上下文 decode 时,评估 DCP。 MoE 模型还需要一个分支。如果专家权重导致放置问题,测试 EP,同时分别跟踪 token 不均衡和 all-to-all 时间。不要给稠密模型添加 EP,也不要从整体 GPU 利用率推断其收益。  > 只有当测量识别出某个并行模式所针对的资源瓶颈时,才启用它。 先识别受约束的资源。然后选择一种通信方式符合现有互联的划分方式。 并行通常是一个放置决策,而不是 GPU 数量设置。从阻止服务达成目标的那项资源入手。然后选择解决该约束的最小布局改动。 每一次切分都会引入通信、同步或调度开销。节省的内存或计算必须在实际硬件和请求分布上超过这些成本。 最好的布局是满足延迟和吞吐量目标的最简单的那个。其他一切都仍需测量。 本篇就到这里! 如果你喜欢这篇内容: 来找我 → [@_avichawla](https://x.com/@_avichawla) 我每天分享关于数据科学、机器学习、大语言模型和 RAG 的教程与见解。 ## 相关链接 - [Avi Chawla](https://x.com/_avichawla) - [@_avichawla](https://x.com/_avichawla) - [1.8K](https://x.com/_avichawla/status/2107427400779026843/analytics) - [Jun 28](https://x.com/_avichawla/status/2071201619530956863) - [308K](https://x.com/_avichawla/status/2071201619530956863/analytics) - [Sep 18](https://x.com/_avichawla/status/2100876555409039605) - [147K](https://x.com/_avichawla/status/2100876555409039605/analytics) - [@_avichawla](https://x.com/@_avichawla) - [Upgrade to Premium](https://x.com/i/premium_sign_up) - [7:07 PM · Oct 6, 2026](https://x.com/_avichawla/status/2107427400779026843) - [1,810 Views](https://x.com/_avichawla/status/2107427400779026843/analytics) --- *导出时间: 2026/10/6 20:46:28*
「 「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧 本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。 技术 › LLM meng shao 2026-09-29 LLM推理GPU推理优化量化投机解码KV缓存vLLMTensorRT-LLM容量规划FlashAttention
图 图解大语言模型部署 本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。 技术 › LLM WquGuru 2026-08-29 LLM模型部署推理优化显存KV cacheTTFT吞吐量量化vLLM成本核算
推 推理是训练的 12 倍,可一块卡生成时只跑出 5% 的算力 文章基于 YC Paper Club 播客,剖析 LLM 推理成本真相:按两年模型寿命摊算,推理总算力约为训练的 12 倍。decode 阶段 MFU 仅 5%,瓶颈在显存带宽而非算力。DeepSeek 通过 KV cache 保留 72 小时、radix attention、零开销调度等手段将缓存命中率做到 96%,实现 38 美元一卡时、80% 毛利。文章还讨论了 SSM 等被低估的模型结构、服务商质量参差(同一模型不同服务商差距超开源闭源差距)以及开源推理生态的规模,指出推理成本优化才是 LLM 竞争的胜负手。 技术 › LLM Saito 2026-10-26 LLM推理优化DeepSeekSGLangKV缓存MoE量化开源模型推理解码算力成本
权 权重压到 4 bit,大模型为什么还能工作? 文章以 Qwen3.8-27B 为例,系统讲解大模型权重量化的原理。从参数如何参与矩阵乘法运算入手,说明 bit 数与编码格式(FP16、BF16、INT4)的关系,演示 0.73 如何被 4 bit 编码为 0.8 并引入误差。深入分析了刻度选择中范围、分辨率与截断误差的取舍,权重误差如何随输入放大为输出误差,以及 GPTQ、AWQ、PTQ、QAT 等量化方法如何利用校准数据控制误差。最后估算 4 bit 模型的存储大小(约 13.5-19 GB),讲解 KV 缓存、混合注意力结构对显存的影响,并给出选择和评估本地量化模型的实用建议。 技术 › LLM gKev1n 2026-10-05 量化4bitLLMQwen大模型模型压缩推理优化KV缓存INT4GPTQ
v vLLM 架构之美:PagedAttention 与 Continuous Batching 解析 作者赞颂 vLLM 的软件设计之美。文章首先介绍 LLM 自回归生成的基本原理,以及推理的两个阶段:计算密集的 Prefill 和带宽受限的 Decode,指出 KV Cache 动态增长与静态批处理带来的内存浪费问题。vLLM 借鉴操作系统分页思想,将 KV Cache 切分为固定大小的块并维护逻辑到物理的块表(PagedAttention),将内存浪费降至约 3%;配合 Continuous Batching 和动态调度,避免已完成的请求阻塞整个批次,让 GPU 始终保持高效。作者认为 vLLM 的成功源于借鉴已被大规模验证的成熟系统概念。 技术 › LLM Atharva 2026-09-27 vLLMPagedAttentionKV Cache推理优化Continuous BatchingLLM推理GPU系统设计
L LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程 本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。 技术 › LLM meng shao 2026-09-22 LLM推理KV CachePrefillDecodeFlashAttention量化推理优化GPUBenchmarkPagedAttention
P Prefill and Decode:理解 LLM 推理的两个阶段 文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。 技术 › LLM Dongxi 东锡 NLP 2026-09-15 LLM推理优化PrefillDecodeKV CacheTTFTTransformer自回归生成chunked prefilldisaggregation
D DeepSeek V4.1 Flash:架构学习笔记 本文是 DeepSeek V4.1 Flash 的架构学习笔记。文章详细解析了其 Causal Encoder-Decoder(CED)结构,该结构通过前后半段网络的不对称计算减少长输入处理成本。核心创新在于 KV 缓存压缩:通过 CSA2 跨层共享全局 KV、FP4 量化、分层稀疏检索以及 SWA 有界回放等设计,将全局 KV 降至约 890 字节/token,持久化缓存约为上一代的 1/8。文章还讨论了这些设计如何协同工作,使长上下文在 Agent 场景下更可负担。 技术 › LLM AI Dance 2026-09-11 DeepSeekLLM架构KV缓存长上下文模型量化稀疏注意力Agent推理优化
D DeepSeek-V4.1-Flash 发布:更聪明、更快速、更高效 DeepSeek 发布新架构家族中最小的模型 V4.1-Flash,具备原生视觉理解能力。该模型采用非对称因果编码器-解码器架构,552B 参数 MoE,仅 8B 激活参数用于输入、16B 用于输出,通过新预训练方法和大规模 RL 后训练,性能超越旗舰模型 V4-Pro。KV 缓存仅需前代 1/4 的 HBM 和 1/8 的 SSD 存储,大幅降低 Agent 成本。模型已上线 DeepSeek API,支持多模态,API 价格下调,非高峰时段费率为峰值的 50%。官方将与开源社区合作推进推理支持,模型已在 HuggingFace 开放。 技术 › LLM DeepSeek (@deepseek_ai) 2026-09-10 DeepSeekV4.1-FlashMoE多模态KV缓存API定价开源RL后训练推理优化
L LLM 注意力机制详解:从 Self-Attention 到 MLA 文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。 技术 › LLM Akshay 🚀 2026-09-05 注意力机制TransformerKV缓存MHAGQAMLAFlashAttention推理优化DeepSeek
S Static vs. Dynamic vs. Continuous Batching in LLMs, clearly explained 文章从第一性原理剖析了 LLM 推理服务中三种批处理策略。现代 GPU 在 LLM 解码时受显存带宽限制,计算单元大量空闲,批处理可将权重读取成本分摊到多个序列以提升吞吐。由于自回归解码的输出长度不可知、序列间相互依赖,传统批处理存在短板:静态批处理在批开始时一次决定,受最慢成员拖累;动态批处理加入定时器,缓解入批等待但仍整批绑定;连续批处理(iteration-level scheduling)在每次前向传播后重新调度,完成的序列立即让位给排队请求,是现代推理引擎高吞吐的关键。文章还讨论了固定输出场景下静态批处理的适用性,并给出 vLLM 和 Triton 的配置示例。 技术 › LLM Akshay 2026-09-01 LLM推理批处理Continuous BatchingvLLMTritonGPU吞吐静态批处理动态批处理推理优化KV Cache
L LLM 推理原理:从 Prompt 到流式响应的全流程解析 文章深入剖析了大语言模型(LLM)的推理过程。首先介绍了文本如何通过分词和嵌入转换为向量,接着详细解释了 Transformer 层中的自注意力机制与前馈网络如何协同工作。文章重点揭示了推理过程的两个不同阶段:处理输入时的“预填充”阶段受算力限制,而生成输出时的“解码”阶段受内存带宽限制,这种性能差异导致了首个token与后续token生成速度的不同。 技术 › LLM Akshay 2026-05-03 LLM推理Transformer分词向量嵌入自注意力机制KV缓存预填充解码技术原理生成式AI









