Wiki 知识库

全部文档 / 标签: 实测评测

7 篇
清除

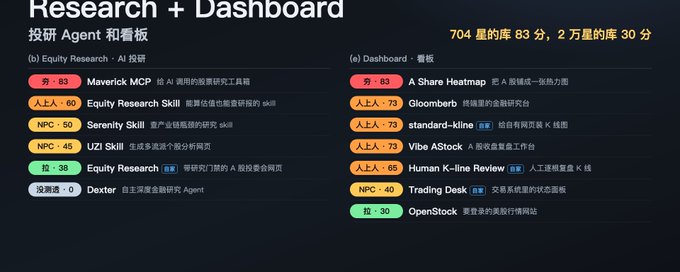
投研 Agent 和交易看板实测:704 星的库 83 分,2 万星的库 30 分(3/5)

本文是 trading 开源库实测系列第 3 期,评测两类共 13 个开源项目:Equity Research(AI 投研研判)6 个和 Dashboard(市场看板)7 个。结论是投研类可复现的极少,大部分只输出无法追溯的文字;唯一可核验的 Maverick MCP(704 星)得 83 分居首,Equity Research Skill 得 60 分,Serenity 和 UZI 分列其后,作者自家的库只得 38 分;2 万星的 OpenStock 因匿名访问被重定向登录只获 30 分,27,659 星的 Dexter 未实测不排名。评测按可复现、可核验等 5 条标准打分,强调星数不代表质量。

投资 › 股票 Park 2026-10-1640.1 KB 3.3K 4 86

Google 的本地笔记:你出题,它检索

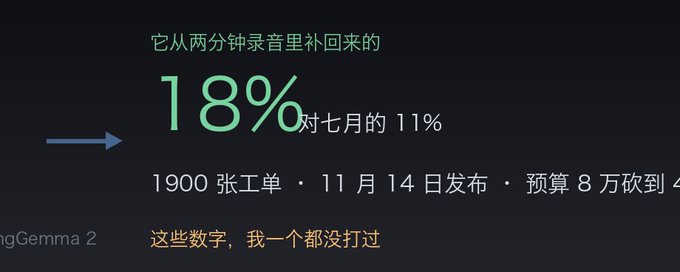
文章评测了 Google DeepMind 随 EmbeddingGemma 2 发布的 Mac 应用 Google AI Edge Foresight。该应用在会议中监听系统音频,用户手写简短笔记后,它基于本地嵌入检索实时补齐细节,全程离线运行。作者通过实测验证它能准确捕捉音频中的具体数字,且不覆盖用户原文,遵循 Jef Raskin '不剥夺用户决策权'的界面理念。文章同时指出其不足:Live Enhance 开关状态不可见、转写无法区分远端说话人身份。技术层面分析了 EmbeddingGemma 2 在短查询检索长文档上的优势(93.7% 命中率),说明'用户出题、模型检索'正是其强项所在。

技术 › LLM yibie 2026-10-117.5 KB 831 2 83

LibTV 1.5 实测:一个人搞定短剧片段,角色、剧本、导演全流程拆解

作者实测 AI 视频平台 LibTV 1.5,通过制作一段 1 分钟都市悬疑短剧,拆解了其五大核心能力:角色造型、原创编剧、导演分身、3D-BOX 虚拟影棚和成片精修。文章详细演示了从导入参考图创建可复用的角色卡、局部修改剧本并预览对故事钩子的影响,到 AI 自动拆分分镜并批量生成视频节点的完整工作流。复盘显示传统方式需半天的工作压缩至约 2 小时。作者指出角色资产沉淀、剧本可控修改是主要优势,但仍需人工把控创意与镜头情绪,适合短剧团队和独立创作者使用。

技术 › 短剧 Modengsir AI 2026-09-258.3 KB 9.3K 78 79

我让 WorkBuddy 删掉55个文件,它竟然…

作者分享了WorkBuddy这款work类agent在安全机制上的实测体验。作者从早年AI改代码踩坑的经历出发,指出不写代码的白领用户同样需要'撤销键'。实测中,WorkBuddy在批量删除55个文件时主动确认、先备份再移入废纸篓,备份经sha256校验逐字节一致;其操作日志为哈希链可防篡改,技能安装有风险检查。此外,WorkBuddy开放十几个模型可选、连接飞书钉钉等第三方办公产品,并内置独立开发者的开源skill。作者认为安全能力本质是给用户加了胆子,让非技术用户也能放心尝试和迭代。

技术 › Agent 花叔 2026-09-1810.0 KB 4K 5 68

三个月,豆包大模型进化了多少?7个案例实测

作者通过7个实际案例测试豆包 Seed-2.1-pro-0915(Doubao-Seed-Evolving)的进化效果,涵盖深度调研 Obsidian AI 插件 Top20、根据视频演示开发跨平台剪贴板应用并改造成 Swift 原生版、Blender 3D 白模驱动视频生成、天津海钓点调研与导航地图制作、电影3分钟解读视频剪辑、3.5万行代码仓库分析等任务。作者感受:多模态理解能力显著提升,Agent 长程任务可靠性增强,但仍存在文案质量和迭代准确性等不足。

技术 › LLM 向 向阳乔木 2026-09-1711.8 KB 25.4K 18 78

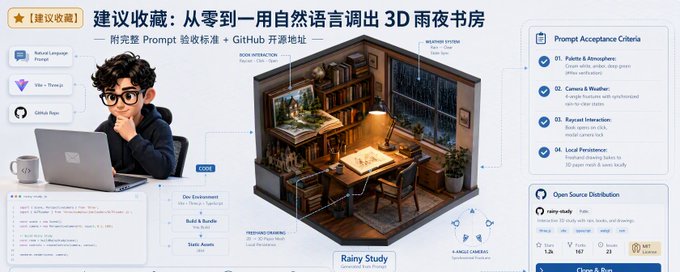
建议收藏:从零到一用自然语言调出 3D 雨夜书房(附完整 Prompt + GitHub 开源地址)

作者用上海 AI 实验室新开源的 744B MoE 智能体模型 Atria Dawn Preview 做实测,通过自然语言生成一间可交互的 3D 雨夜书房:窗外下雨、桌上点灯、书架的书可取下阅读、纸笔可手写保存、还有带动画和中文朗读的立体儿童绘本。文章记录了从初始提示词到多轮返修的全过程,指出该模型能组织出可运行原型并响应反馈修改,但主体生成耗时约 219 秒、需 7 轮返修,收尾工作仍需 Codex 补充。项目代码已开源并附在线体验地址,核心结论是:提示词的每条要求都应能在成品中验收,模型能力须回到实际使用结果上评估。

技术 › LLM Berryxia.AI 2026-09-1519.7 KB 12.5K 36 75

我逐条核了 Apodex 1.1 报的行号,10条全对,因为它交稿前自己先改过一轮

作者用 Apodex 1.1 对 modelcontextprotocol/servers 的三个参考实现做安全审计实测,并以 Apodex 提出的六条标准(理解目标、真实环境动手、长链条任务状态、处理新反馈、失败自修复、结果可核查)逐一验证。测试中多 subagent 并行推进、可中途切换威胁模型并仲裁内部结论分歧、三次撞墙均自行修复。最终交付30条清单,作者抽验10条行号全部准确,关键在于交稿前的 Statement Review 自查机制抓出并修正了多处错误。结论:五条通过、一条有条件通过,工具的可验证性和自我纠错能力表现出色。

技术 › Agent 阿良|AI 工作流 2026-08-2717.5 KB 57.6K 105 85