Wiki 知识库

全部文档 / 标签: 检索增强

9 篇
清除

Google 的本地笔记:你出题,它检索

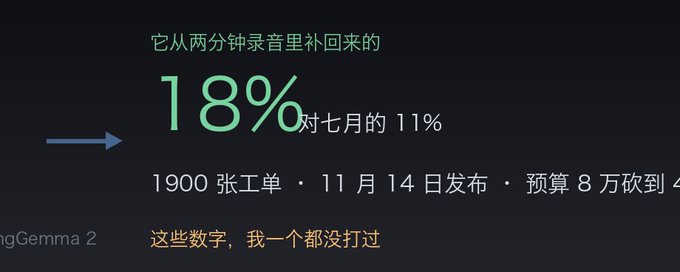
文章评测了 Google DeepMind 随 EmbeddingGemma 2 发布的 Mac 应用 Google AI Edge Foresight。该应用在会议中监听系统音频,用户手写简短笔记后,它基于本地嵌入检索实时补齐细节,全程离线运行。作者通过实测验证它能准确捕捉音频中的具体数字,且不覆盖用户原文,遵循 Jef Raskin '不剥夺用户决策权'的界面理念。文章同时指出其不足:Live Enhance 开关状态不可见、转写无法区分远端说话人身份。技术层面分析了 EmbeddingGemma 2 在短查询检索长文档上的优势(93.7% 命中率),说明'用户出题、模型检索'正是其强项所在。

技术 › LLM yibie 2026-10-117.5 KB 831 2 83

Jev-Mem: 无需 LLM 的记忆决策

文章介绍了 UT Dallas 的新论文 Jev-Mem,提出用 TypeSafe AI 的 Jev 模型替代通用 LLM 来处理 Agent 记忆系统中的小决策(如判断消息类型、记忆关联、检索终止等)。Jev 只返回结构化数值或标签,无需解析文本,通过 System One 轻量控制器与 System Two 生成式 LLM 的分工,显著提升效率。在 LoCoMo 基准上,答案质量相对最强基线提升 11%,构建速度快 6.6 倍,查询延迟降低 36.7%。文章也指出其局限:阈值依赖单一模型与基准、缺乏校准概率、消融实验不足,阈值在不同模型和数据分布下的泛化能力是最大隐患。

技术 › Agent mem0 2026-10-0811.6 KB 48K 516 77

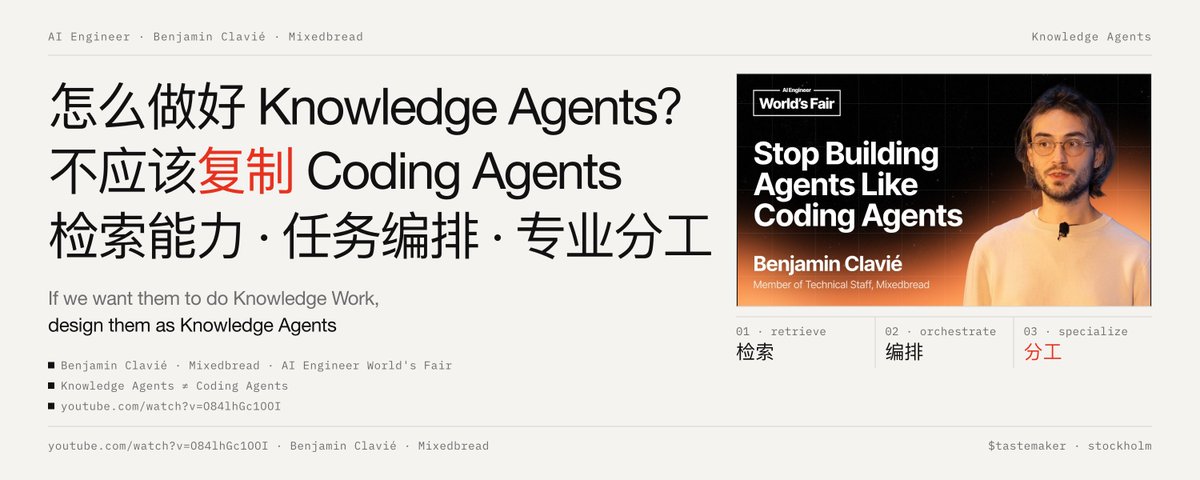
怎么做好 Knowledge Agents?不应该复制 Coding Agents,做好检索能力、任务编排与专业分工

本文介绍 Ben Clavié 在 AI Engineer World's Fair 的演讲,主张知识型 Agent 不应照搬 Coding Agent 范式。核心观点:编程智能体的成功源于代码环境的结构化红利;而法律、医疗、投研等知识任务的难点在于正确定位、理解和验证证据。要构建可用的知识 Agent,需具备面向任务的高质量检索工具(含图表、扫描件等多模态内容),以及主智能体负责任务分解、子智能体承担专业分工的编排架构。文章还给出企业级建设的优先级建议:定义可验证任务、建设证据层、按需拆分智能体、多维度评估并保留人工审核。

技术 › Agent meng shao 2026-09-186.2 KB 14.5K 63 77

本周顶级AI论文精选(9月7日-13日)

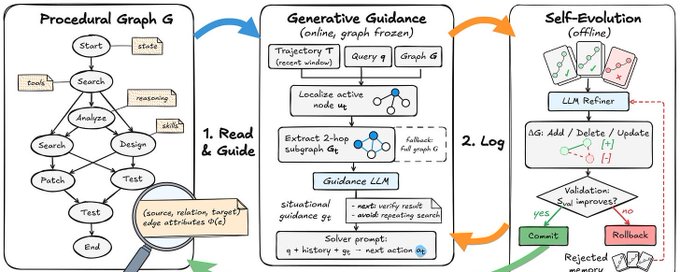
DAIR.AI发布本周(9月7日-13日)顶级AI论文精选,涵盖五篇论文:Procedural Graphs提出用显式程序图指导长时程智能体,减少动作漂移;FrogNano证明4B编码智能体可通过纯强化学习与在线任务合成达到竞争性能;STAIR利用目录结构改进生成式检索,显著提升召回率并降低幻觉;AI-Native Design Docs主张以自然语言设计文档为持久产物,由编码子智能体重新生成实现;PARSER将阅读与推理分离,通过并行子智能体与迭代散射-聚集提升长文档处理效率。

技术 › LLM DAIR.AI 2026-09-1416.3 KB 34.6K 96 74

How I Built pragatiLM?

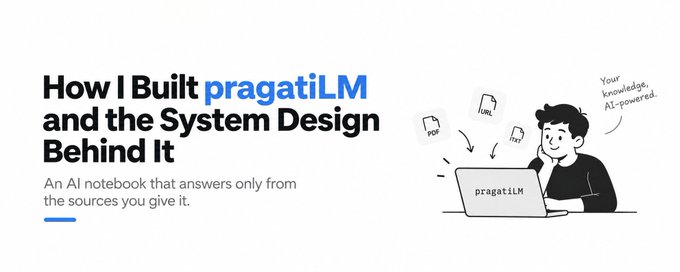
作者详细介绍了 pragatiLM 的构建过程——一个只基于用户提供的源(PDF、网页、YouTube 视频、字幕文件或粘贴文本)作答并附带可点击引用的 AI 笔记本。文章系统讲解了基础 RAG 的原理及其三大失效点:问题作为搜索键不佳、存储只单向单次搜索、输出缺乏自检。pragatiLM 采用九阶段检索管线:将问题转化为五个搜索变体、并行多通道检索、基于排名一致性融合、重排序、答案 grading,低分时基于缺失诊断再次检索,极低分时拒答。文章还涵盖基础设施、消融实验测试等内容。

技术 › LLM Saurav Jha 2026-09-1340.3 KB 3.7K 34 85

万字长文:知识库从入门到精通

文章系统讲解知识库的进阶路径:从最轻的文件上传开始,到 iMA、飞书知识问答承接多文件场景,再用 Obsidian 将资料沉淀为个人判断,进而用 LLM Wiki 让 Agent 自动维护知识库,最后进入企业级 RAG 阶段。作者详细介绍了各阶段的关键实践,包括提示词设计、目录结构、切片与检索策略、权限控制、评测方法等,强调知识库的核心是在模型回答前找到可靠材料,并保留来源、暴露冲突、允许拒答。

技术 › LLM Miles Ma 2026-08-1829.6 KB 104.3K 414 87

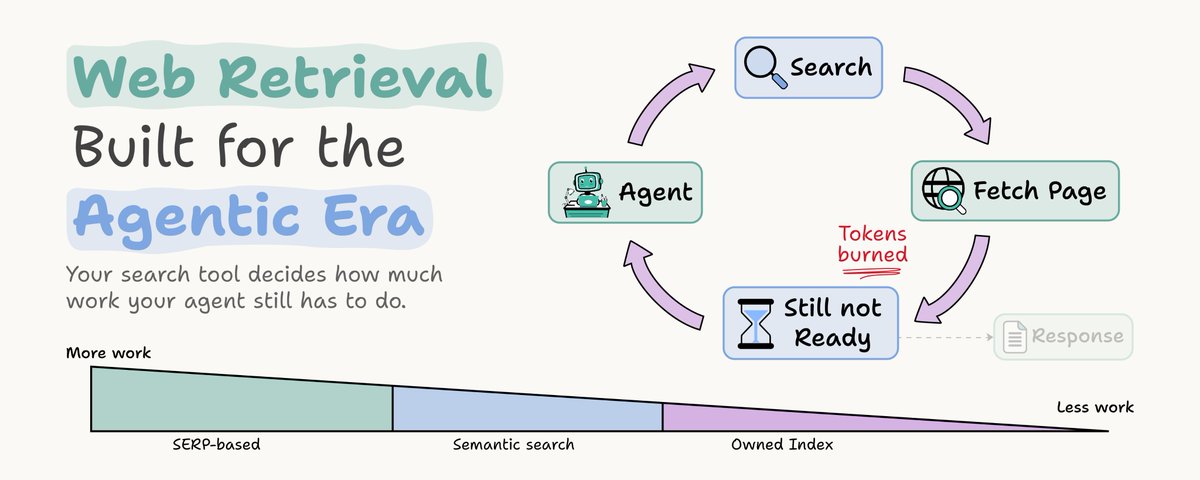
Agents Need a New Kind of Web Search

文章探讨了当前 AI Agent 在使用传统网页搜索时面临的“检索税”问题。传统搜索 API 仅返回链接和摘要,迫使 Agent 耗费大量 Token 去抓取和清洗内容。作者通过对比实验指出,使用预先爬取并结构化处理的索引(如 Seltz)能显著降低成本并提升效率,这种返回完整文档而非指针的方式是 Agent 搜索的未来。

技术 › Agent Akshay 2026-07-179.7 KB 72.1K 152

你的第二大脑需要 QMD 才能健康扩展

文章探讨了在构建基于 Obsidian 和 Claude Code 的“第二大脑”知识库时,随着内容增多遇到的索引臃肿、语义搜索困难及原文细节丢失三大瓶颈。作者引入 QMD 这一本地 RAG 工具,通过混合检索(向量+BM25)弥补了传统 Wiki 模式的缺陷,大幅提升检索精度并节省 Token。文中还包含从零搭建知识库及配置 QMD 的完整实操指南。

技术 › 工具与效率 R Ren 2026-05-2113.2 KB 92

不做中转,不卖课,如何用 AI 月入 10万

作者分享了今年通过接企业知识库项目实现月入数万的实战经验。文章详细阐述了如何将基础 RAG 升级为企业级 RAG 系统,重点涵盖数据处理层面的文档切分策略(针对 PDF、Excel、代码等)、向量化模型选择及数据库选型;同时深入讲解了检索策略优化,包括长问题处理、混合检索、Rerank 精排及多因素加权排序等技术细节。

技术 › LLM M Miles. 2026-05-1226.8 KB 91