Wiki 知识库

全部文档 / 标签: 推理部署

3 篇
清除

Cerebras 如何部署万亿参数前沿模型

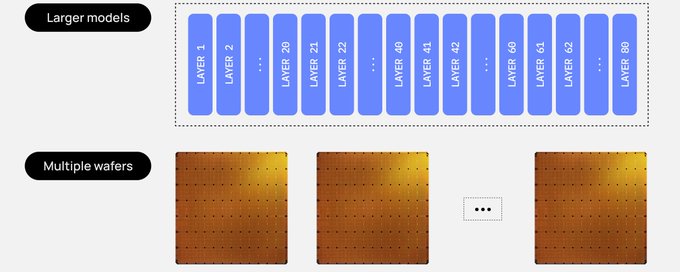
Cerebras 团队详细介绍了如何在 WSE-3T 晶圆级芯片上部署万亿参数大模型。以 3 万亿参数的开源模型 Kimi K3 为例,团队通过 4-bit 权重量化和 8-bit KV 缓存计算每层约 16 GB 的显存需求,将模型切分到 59 片晶圆上:每个 dense 层独占一片晶圆,每片可放两个 linear-attention 层。晶圆间通过以太网 RDMA 传递激活值,权重无需移动。系统以流水线方式运行,各阶段可同时处理不同请求和微批次,从而实现 1000-2000+ tokens/秒的推理速度。

技术 › LLM Sarah Chieng 2026-10-239.9 KB 282.4K 816 85

AI 工程师面试:大厂反复考的 25 道通用题

文章总结了 AI 工程师面试中各科技大厂(OpenAI、Meta、DeepSeek、Anthropic 等)反复考察的高频题目,覆盖三大模块:LLM 内部原理(attention、KV cache、RoPE、MoE、scaling laws、解码策略等)、推理部署与 GPU 性能(continuous batching、PagedAttention、量化、并行策略、显存估算、延迟指标等),以及 RAG、Agent、微调、评测、安全、多模态、系统设计等方向。作者指出各家面试题高度重合,建议优先刷这些通用题以获得最高性价比。

技术 › LLM 山景城小路 2026-10-073.7 KB 21.2K 258 71

如何在一张 GPU 上服务 100 个微调模型

文章介绍如何在单张 GPU 上高效服务大量 LoRA 微调模型。将适配器合并进基座会为每个变体生成 15.2GB 的完整模型副本,而分开保存适配器只需约 40MB,共享基座后 100 个变体仅占 19.3GB。作者对比了四种部署形态(合并独立 endpoint、启动时注册、请求时解析、托管按租户),并在 Runpod 上用 Qwen 1.5B 训练三个 LoRA 适配器做实验。结果显示共享 endpoint 复用 worker 池,显著减少冷启动与显存浪费;同时强调应分开记录等待时间与执行时间,并通过镜像缓存优化冷启动延迟。

技术 › LLM yibie 2026-09-1611.8 KB 5.4K 38 86