Wiki 知识库

全部文档 / 标签: Cerebras

5 篇
清除

Cerebras 如何部署万亿参数前沿模型

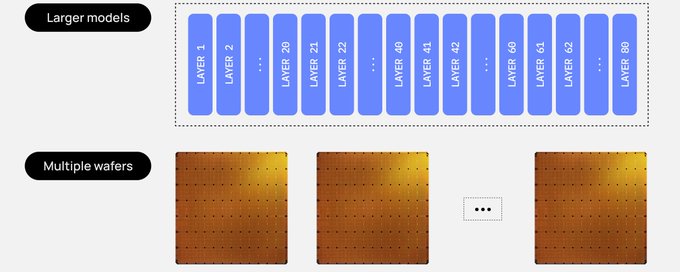
Cerebras 团队详细介绍了如何在 WSE-3T 晶圆级芯片上部署万亿参数大模型。以 3 万亿参数的开源模型 Kimi K3 为例,团队通过 4-bit 权重量化和 8-bit KV 缓存计算每层约 16 GB 的显存需求,将模型切分到 59 片晶圆上:每个 dense 层独占一片晶圆,每片可放两个 linear-attention 层。晶圆间通过以太网 RDMA 传递激活值,权重无需移动。系统以流水线方式运行,各阶段可同时处理不同请求和微批次,从而实现 1000-2000+ tokens/秒的推理速度。

技术 › LLM Sarah Chieng 2026-10-239.9 KB 282.4K 816 85

Disaggregated Inference From The Ground Up

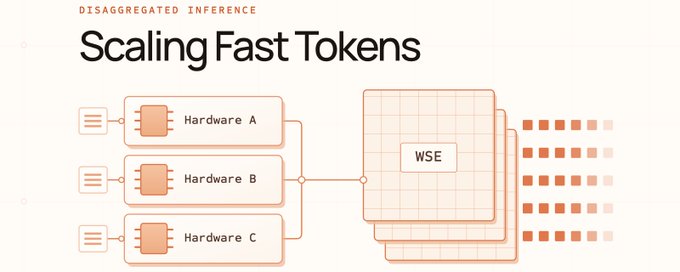
本文由 Cerebras 撰写,从基础原理讲解推理系统中的分离式推理技术。文章先介绍加速器的构成(计算单元与存储),并引入算术强度概念,通过矩阵加法与矩阵乘法的实例说明数据搬运与计算的关系。随后分析 LLM 推理的两个阶段:prefill(处理整个 prompt,计算密集型)与 decode(逐 token 生成,受限于内存带宽),解释二者对硬件需求的不同。Cerebras 提出异构分离式推理,将不同类型芯片分配给不同推理阶段,在相同硬件数量下将吞吐量提升 5 倍且不损失单用户生成速度。

技术 › LLM Cerebras 2026-10-0219.6 KB 400.2K 299 70

We built a 20x faster Grok bot

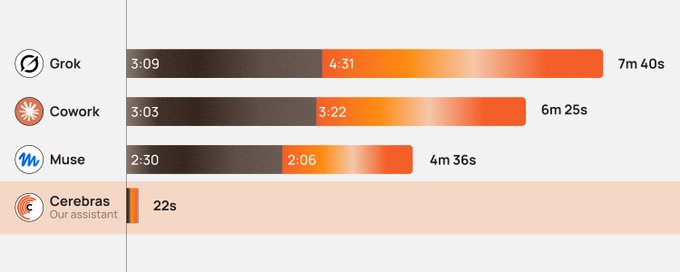
Cerebras 团队测试了主流 AI 个人助理完成订餐任务的表现,发现现有助理耗时过长(如 Grok Bot 需 7 分 40 秒)。团队使用 Qwen 3.8 27B 模型运行在 Cerebras 硬件上,以 Pi 作为 Agent Harness,通过三项优化将任务压缩至 22 秒:1) 并行执行独立的检查操作;2) 借助 Cerebras 快速推理加速模型调用;3) 将探索网站的经验固化为 Skill 复用,减少 80% 以上的工具调用。文章展示了 Harness Engineering、快速推理和经验沉淀对 Agent 效率的巨大提升潜力。

技术 › Agent Cerebras (Sarah Chieng, @0xSero) 2026-09-267.4 KB 685.5K 1.9K 70

2026 年最全免费 AI 资源盘点

作者花费 20 天实测了各类免费或近免费的 AI 模型获取渠道,包括免费 API、促销额度、创始人和学生计划、开源维护者资助等。文章指出多数“免费 AI”汇总信息过时且不准确,并从三个维度评估:永久配额与限时额度的区别、实验用途与生产用途的区别、以及隐藏的数据隐私代价。详细分析了 Google AI Studio、Groq、Cerebras、Mistral、Cloudflare Workers AI、OpenRouter、Cohere、OpenAI 等平台的免费额度与限制,还涵盖初创企业资助、学生福利、开源维护者计划以及地理限制,最后强调本地部署模型是唯一不可撤销的保底方案。

技术 › LLM Innopro 2026-09-2610.8 KB 381.6K 156 85

BestBlogs 早报 · 08-14|DeepSeek Harness 智能体,GPT-5.6 Sol 压缩推理等待,多智能体实验暴露协作失灵

本期早报聚焦智能体系统的三大核心问题:架构、算力与协作机制。DeepSeek Harness 提供插件化 Agent Harness,将模型、工具等能力拆分为可替换组件;Cerebras 与 OpenAI 推出 GPT-5.6 Sol Ultrafast,通过专用硬件实现高速推理;Anthropic 的多智能体实验揭示了协作中的冲突、从众与信任问题。此外,速览部分涵盖 Gemini 3.7 Flash 发布、Agent 评测与轨迹复盘、ICML 论文复现经验、Claude Tag 更新及小红书开源 TTS 模型。

技术 › LLM ginobefun 2026-08-1430.6 KB 7.7K 2 76