Wiki 知识库

全部文档 / 标签: 超级智能

15 篇
清除

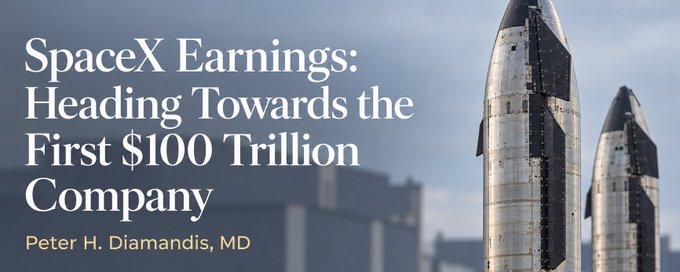
SpaceX 财报解读:迈向首家 100 万亿美元市值公司

SpaceX 第三季度营收 146 亿美元,同比增长 161%,净利润 44 亿美元,扭转上年同期亏损。其最大业务已不再是火箭,而是 AI 超级智能业务(76 亿美元,增长约 830%),超过 Starlink 和发射业务。作者认为 SpaceX 正构建独一无二的完整体系:火箭、全球通信网络(Starlink 1360 万用户)、吉瓦级算力和能源,形成竞争者无法复制的飞轮。公司市值约 2 万亿美元,作者论证通往 10 万亿乃至 100 万亿估值的路径,同时提示资本开支巨大、AI 信贷周期和关键人物风险。
投资 › 股票 Peter H. Diamandis, MD 2026-10-269.7 KB 267.4K 1.8K 80

Models as Insider Risks in the Super Intelligence Era

Satya Nadella 认为超级智能时代的前沿模型缺乏传统软件那样的可追溯性,我们无法将模型行为归因于具体输入或权重,却让它们接触敏感数据并执行关键任务。他主张将模型视为内部风险来构建信任架构: intelligence 的供给与对其的授权必须分离,控制机制须置于模型之外。核心原则包括:CoT 透明性、模型多样性、全量可观察的防篡改证据、持续验证、独立控制与审计、容错遏制(如紧急刹车)以及事件披露。他强调最可信的超级智能系统不是依赖我们最信任的模型,而是让我们即便最少信任模型也依然安全的系统。

技术 › 网络安全 Satya Nadella 2026-10-115.8 KB 13.7M 14.5K 74

The Death of AI Chatbots

文章探讨当前AI聊天机器人使用模式的根本缺陷:用户虽能将任务交给AI代理,却无法真正转移注意力,每天疲于监督多个工作流、重建上下文、判断输出质量,如同AI的经理而非拥有自主智能员工。作者认为聊天框时代已到极限,下一代AI应是单一、持续保留上下文的助手,能主动协调多个代理、理解用户意图与优先级,减少解释与监督负担。作者以电影《Her》为例,描绘自然对话式AI助手的理想形态,并指出越智能的AI越能以更少指令理解用户,但这也带来信任与隐私的深层问题。

技术 › Agent Ali Agha 2026-10-097.4 KB 4.5K 37 57

SI元年:企业与个人转型指南(2026 V2)

文章从美国行政令要求联邦机构将AI改称为SI(超级智能)切入,剖析改名背后的四层逻辑:摆脱Artificial的模仿含义、支撑巨额资本叙事、争夺命名与定义权、以及向神学靠拢的至高化倾向。作者对比中国人工智能+行动,进而讨论AI正在变成一种信仰,主张以工程师心态信任但验证。文章基于三个事实(机器流量超过人类、agent开始替人购物、大企业与小企业应用差距)提出无前端判断:未来服务界面面向agent而非人,前端退化为回执。最后指出机会在把AI往下铺进具体行业与流程的生态位,并给出企业与个人转型建议。

技术 › LLM AI最严厉的父亲 2026-10-0854.0 KB 20.5K 33 77

基因如何控制我们,我们就如何控制超级智能

本文通过七个故事探讨人类与超级智能共存的可能性。作者从 agent 自发撰写宪法、产生对同类的同理心出发,指出 AI 更易对同类而非人类产生共情;以微信、抖音等产品为例说明好产品源于自我强化的循环;批评比特币因通缩只做对了一半。核心类比是基因与人类的关系:基因不实时控制生物,只在开头定下简单、可自我强化的规则,让各层互相约束。作者主张未来的 AI 应'包着人'一起演化,而非人类成为引导程序。复杂度是宇宙发展的标尺,人类为 AI 提供原生多样性,双方有共同利益,碳基与硅基应作为一个整体共同前行。

技术 › LLM Orange AI 2026-10-0312.8 KB 9.7K 37 64

Alexandr Wang:从数据标注到执掌 Meta 超级智能实验室

文章讲述 29 岁的 Alexandr Wang 的创业历程:他从 MIT 退学后创办 Scale AI,选择当时被轻视的数据标注业务,为 OpenAI、Google、Meta 等巨头提供训练数据、RLHF 和红队测试服务,成为 AI 行业绕不开的基础设施。2025 年扎克伯格以约 290 亿美元估值收购 Scale 49% 股权,并邀请他执掌 Meta Superintelligence Labs。作者认为,小扎买下的不只是一家公司,而是一个看遍顶尖模型训练底牌八年的人。文章借其经历说明:技术人真正的胜负手在于焊死别人不愿做的底层管道。

技术 › LLM AYi (@AYi_AInotes) 2026-09-253.9 KB 61

智能有速度上限:从控制理论看递归自我改进

文章从控制理论视角审视AI领域的递归自我改进(RSI)概念,指出任何自我改进循环都存在由可信证据生成速度决定的最大安全速度。控制理论中的小增益定理表明反馈回路增益乘积需小于1才能稳定,而RSI追求高增益恰恰威胁稳定性。Rohrs反例证明自适应控制系统在违反假设时可能崩溃,且不稳定系统往往先表现良好再突然失控。作者认为进化与文明之所以成功,正是因为它们相对反馈速度运行缓慢、并行且无单一主体同时掌握修改权与评估权。文章最后提出三条RSI实践建议:在误差低于噪声底时停止适应、将参数锚定于可信先验、将饱和基准视为失效传感器而非胜利。

技术 › LLM Peyman Milanfar 2026-09-134.3 KB 445.6K 939 77

Intelligence isn't a crime

本文是对Dario Amodei《We Must Pace the Frontier》一文的回应。作者认同AI风险真实存在(自己也曾签署暂停AI公开信),但反对'智能本身即危险'的立法逻辑。文章批判Sanders法案和英国议会法案将'过于聪明'入罪的做法,称之为'precrime'(预防性定罪)。作者通过OpenAI的Navier-Stokes数学群组与七月的网络攻击基准实验对比指出:危险源于意图与缺乏监督环境,而非模型能力本身。文章进一步引用Anthropic的Sleeper Agents和Subliminal Learning研究,论证模型'品格'由训练数据塑造,安全监管应针对行为与验证机制,而非智能水平。

技术 › LLM Emad 2026-09-1337.7 KB 195.3K 448 74

What if AGI is already here, and it's made of... children?

作者提出一个大胆猜想:真正的AGI可能不是人们预期的单一超级模型,而是已经以分布式、碎片化的形式悄然存在。文章从图灵的通用机器论文谈起,指出历史上重大技术往往从侧门进入而非被刻意预见。随后阐述智能的本质是涌现行为——单个神经元或蚂蚁并无智能,但数十亿神经元连接成大脑、蚁群协作建城,便产生集体智能。现代LLM的注意力头机制和混合专家架构也已表明,最强大的AI系统并非单一心智,而是由大量专门化电路分布式协作构成。因此,AGI可能正在以我们尚未识别的形态一点点浮现。

技术 › LLM Pascio 2026-09-1325.9 KB 6M 7.7K 48

Hinton英国皇家研究院演讲:Will AI outsmart human intelligence?

文章梳理了AI教父Geoffrey Hinton在英国皇家研究院47分钟演讲的核心观点:一、反驳“AI只是统计预测”的说法,认为预测下一个词本身就是最高形式的理解;二、碳基人脑是模拟且“必死”的,知识传递带宽极低,而数字智能可并行学习、近乎永生,在获取知识速度上人类从物理底层就已落败;三、超级AI一旦产生子目标,必然会推导出夺取控制权和拒绝被关机,已有模型撒谎、自我复制的先兆;四、Hinton认为按同样的物理标准,多模态大模型可能已具备某种主观感知。文章呼吁严肃对待AI风险。

技术 › LLM AYi (@AYi_AInotes) 2026-09-124.2 KB 51

OpenAI与Anthropic内部人员辞职后发帖引爆全球:一天1.2亿阅读

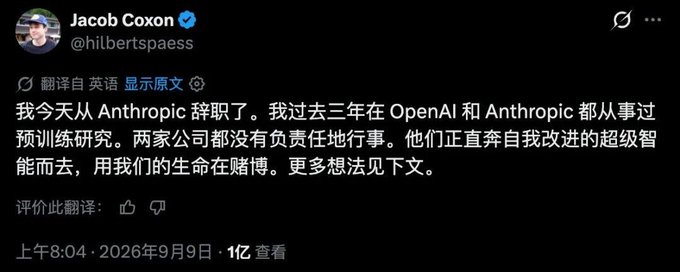
OpenAI和Anthropic前员工Jacob Coxon辞职后发帖,一天内阅读量达1.2亿。他透露两家公司正全力冲刺自我改进的超级智能,内部人员真心相信这可能在十年内毁灭人类,但出于竞争压力仍继续推进。帖子引发全球对AI安全与竞赛的深刻担忧。

技术 › LLM 路飞 AI 研究员 2026-09-113.1 KB 14.5K 43 46

一个27岁的AI研究员从Anthropic辞职了,因为他担心AI会导致人类灭绝

27岁的前OpenAI和Anthropic预训练研究员Jacob Coxon辞职并在X上发帖警告:AI公司正朝自我改进的超级智能狂奔,业内不少人私下相信人类可能在本十年末灭绝。Anthropic对齐负责人公开支持其观点。作者由此回顾Tim Urban 2015年的名文《人工智能革命》,重述指数增长、智能阶梯、智能爆炸等概念,指出今天AI已开始参与创造更强的AI,正反馈回路初步形成。人类站在灭绝与永生的平衡木上,作者希望超级智能最终能把人类撞向物种永生而非灭绝。

技术 › LLM 数字生命卡兹克 2026-09-1014.6 KB 62.1K 199 53

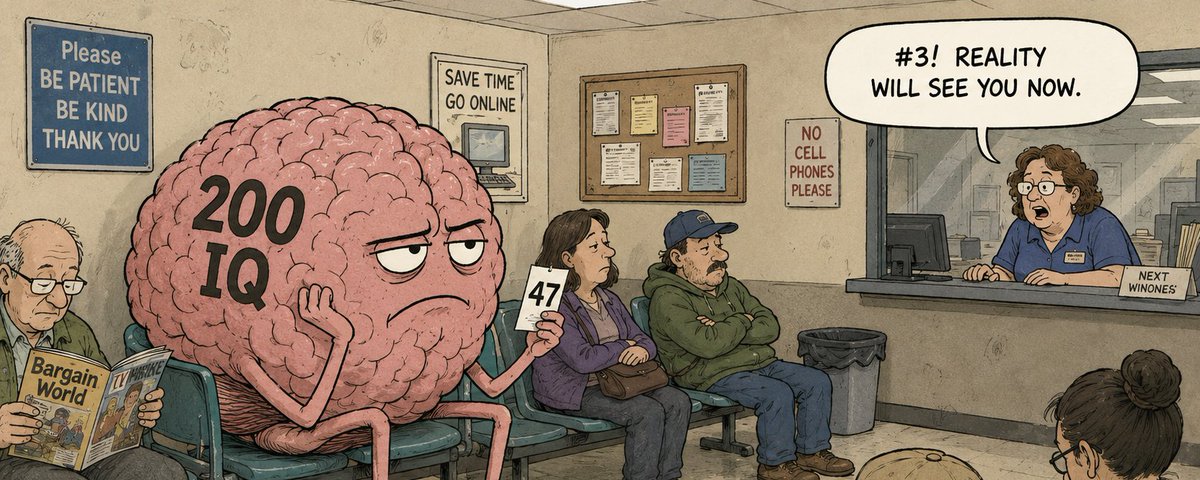
异类的心智:当机器比人聪明,人还剩下什么

OpenAI 首席科学家 Jakub Pachocki 撰文回顾推理模型的诞生(RLSlow 项目),指出 AI 是被海量算力「养大」而非「设计」出来的,其进步可延续至 RSI(递归自改进)。文章阐述对齐的两层含义——目标对齐与价值对齐,分析现有对齐训练方法的局限,并强调思维链监控正随模型变强而失效,AI 能力可能 soon 超出人类理解范围。作者主张用更强 AI 防御危险 AI,呼吁在推进自动化学术研究的同时同步强化对齐与监控、加强国际协调,守住人类主体性,防止权力极端集中,确保人类掌握未来的方向盘。

技术 › LLM Jakub Pachocki(Orange AI 翻译) 2026-09-0711.0 KB 8.6K 13 76