Wiki 知识库

全部文档 / 标签: 架构创新

3 篇
清除

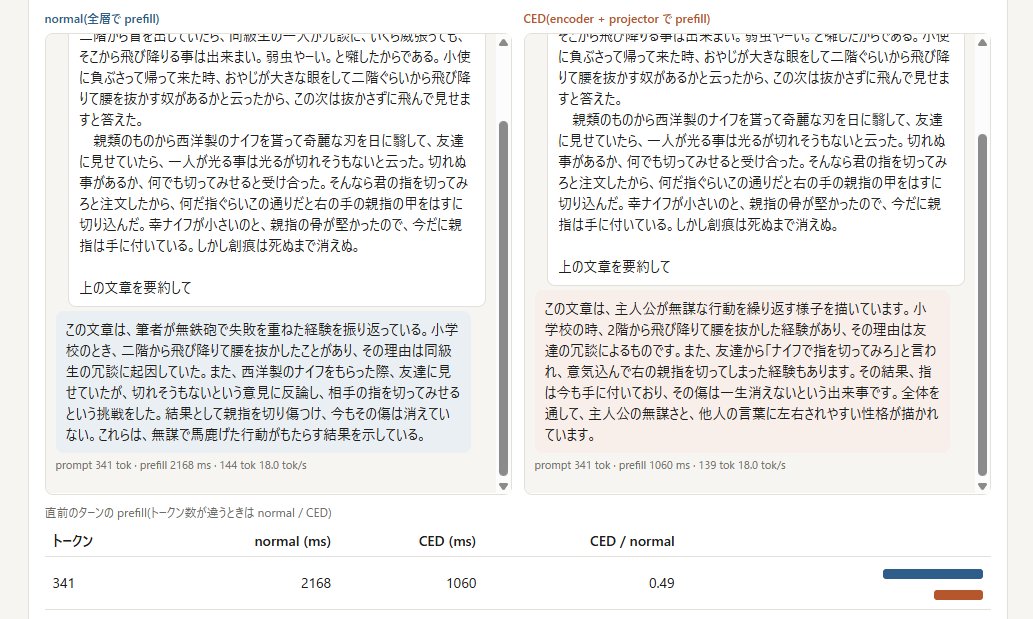
大开眼界:把 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 思路移植到 Qwen3-8B

文章介绍了一项实验:研究者将 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 机制移植到现有 Qwen3-8B 上,不修改原模型权重,仅外挂一个小模型近似后半层 KV Cache,使 Prefill 时间缩短近一半且输出一致。作者分析了这对本地模型部署(尤其 DGX Spark)的重大意义:长上下文首 token 等待明显降低,KV Cache 内存占用减少,Coding Agent、Computer Use Agent 等本地工作负载体感大幅提升。文章同时指出结果尚需在更多任务上验证,但认为已有模型可通过轻量近似层获得架构级推理升级。
技术 › LLM Wei (@wei_wang) 2026-09-135.5 KB 75

Kimi K3:超越 Fable 5 的开源模型完全指南

本文详细介绍了月之暗面发布的 Kimi K3 模型。该模型拥有 2.8 万亿参数和 100 万 token 上下文,性能超越 Claude Opus 4.8 和 GPT-5.6 Sol,对标 Fable 5。文章分析了其定价策略、架构创新以及模型自主优化架构的能力,展示了其在长程编码和 3D 前端开发方面的强大实力。

技术 › LLM Kirill 2026-07-2141.9 KB 1.3M 394

何恺明和字节Seed跳到同一条河流:连续扩散语言模型的范式转移

文章深度解读了2026年5月何恺明MIT团队与字节Seed团队前后发布的两篇论文(ELF与Cola DLM)。两者殊途同归,挑战了主流的自回归(AR)生成范式,主张将语言模型的生成过程从“离散Token预测”转变为“连续空间的潜变量扩散”。这种“先思考后落字”的铅笔模式,不仅提升了效率与效果,更可能引发LLM底层架构、评估标准及多模态统一范式的新一轮变革。

技术 › LLM 花叔 2026-05-2522.2 KB 8.9K 25 72