Wiki 知识库

全部文档 / 标签: 扩散模型

10 篇
清除

APEX: Better generation from fewer tokens

APEX(Asynchronous Prefix denoising for EXtreme compression)由 Lightricks 与耶路撒冷希伯来大学联合研发,是一种面向扩散模型的极端潜空间压缩方法。它通过“结构到细节”的累积前缀表示,让少量潜token同时满足计算效率、重建质量和生成质量三个目标。该方法为潜通道分组排序,早期通道表达整体结构,后续通道逐步补充细节,并用异步去噪调度在不同时间窗内分别处理各组。在 ImageNet 512×512 实验中,APEX 在 64× 与 128× 空间压缩下显著提升生成效果,64-token 模型在推理预算相当的情况下全面优于 256-token 基线,为世界模型开发提供了高效表示设计原则。
技术 › LLM LTX.io 2026-10-1714.8 KB 1.4M 91 67

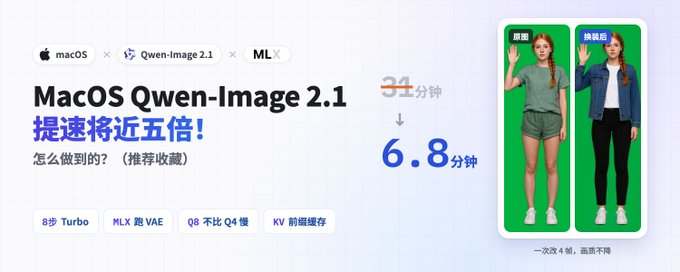
MacOS 本地部署 Qwen-Image 2.1 提速将近五倍!怎么做到的?(推荐收藏)

作者分享了在 M2 Pro Mac 上将 Qwen-Image 2.1 改图时间从 30 分钟压到 6.8 分钟(提速4.5倍)的完整方法论。首先通过耗时拆解定位瓶颈,然后叠加四个优化点:换用 Turbo 模型将去噪从20步降至8步;将 VAE 编解码切换到苹果 MLX 框架,从315秒降到15秒;实测发现 Q8 与 Q4 量化在扩散模型上速度相同,因此选用画质更好的 Q8;利用块因果结构实现前缀 KV 缓存,使每步采样时间减半。作者还用该流水线完成了一段10秒视频的逐帧换装,并通过肤色基准校正、锚点补偿和时序平滑三层方案解决了误差累积问题。

技术 › 工具与效率 WquGuru 2026-10-1311.0 KB 16.6K 87 88

在 A100 上实测蚂蚁开源 Ming-Image:电商主图拆成 6 层,一键换双 11 版

作者在 A100-80G 上部署并实测了蚂蚁百灵开源的 Ming-Image-0.1 系列,包括 Design 生图模型和 Layer 拆层模型。文章详细记录了部署过程与显存优化技巧(VAE 逐帧+分块解码可将峰值从 71.8GB 降至 55.4GB),并用 12 张电商图做了拆层评测:平面海报和白底商品图重组 PSNR 可达 29dB 以上,配合 VL 模型生成分层计划能显著提升图层顺序准确性。作者还搭建了电商主图工作台,实现大促换皮(商品层像素零变化)、文案 A/B、一键英文版和 PSD 导出,展示了 AI 生图从「生成」到「可编辑」的完整流水线。

技术 › LLM 柯基是只猫 2026-10-0514.3 KB 11K 49 85

如何用 AI 视频模型创建高质量镜头运动

本文是 LTX-2.5 AI 视频模型的镜头运动指导教程。文章介绍了该 220 亿参数开源音视频基础模型的架构原理,指出良好的镜头运动需具备时间连贯性、意图匹配和画面完整性。作者强调使用官方文档化的镜头词汇(如 pushes in、pulls back、pans across 等),并给出最关键的提示词技巧:描述运动完成后主体在画面中的状态,为模型提供'目的地'而非仅方向。文章还讲解了帧数约束((F-1)%8==0)、提示词修复案例、多镜头剪辑中的镜头规划方法,以及复杂运动可使用 IC-LoRA 深度条件控制等确定性手段。

技术 › AI视频 LTX.io 2026-09-2214.4 KB 137K 162 84

万字长文:通宵评测Qwen-Image-2.1

作者在48GB的4090上对Qwen-Image-2.1进行了13组实验、196张图的深度评测。模型视觉生成为7B DiT架构,配Qwen3-VL编码指令与参考图,支持原生RGBA透明。评测发现其强项为中文排版、原生透明通道和多图身份保持,弱项是「替换」语义常退化为「添加」、编辑具有非局部性、缺乏时间维度建模。文章详细测试了文字渲染阈值、透明度真实性、指令遵循、编辑精度、多图参考及性能表现,并给出KV cache与显存的权衡策略。最后作者通过360°转台动画实验,揭示了条件图下seed敏感性等反直觉发现,定位其为关键帧生成器而非视频模型。

技术 › LLM 实践哥 Li 2026-09-2118.2 KB 525.6K 599 90

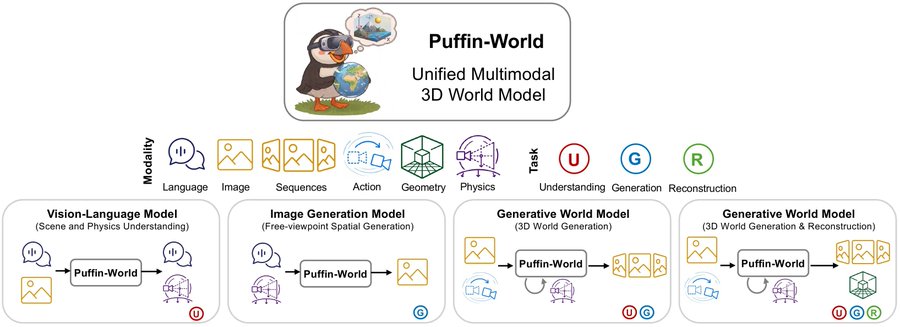
面向空间智能的统一世界模型Puffin-World:从生成画面走向构建物理可信世界

南洋理工大学S-Lab与大晓机器人等机构发布统一世界模型Puffin-World,让同一模型原生理解物理方向、空间几何和视觉外观,实现三维世界生成与重建,无需依赖外部模型。模型将世界表示为物理状态(重力场、纬度图)、几何状态(深度)和外观状态(RGB)三种关联状态,并提出Omni-Camera统一相机表示,结合绝对与相对相机信息。该框架在表征、模态、任务三个层面实现统一,支持相机参数估计、自由视点生成、3D场景重建等任务,并构建了包含1500万组视觉-语言-相机数据的Puffin-16M数据集,在多个基准上取得领先结果。

技术 › LLM 青稞社区 2026-09-1313.4 KB 1.4K 5 71

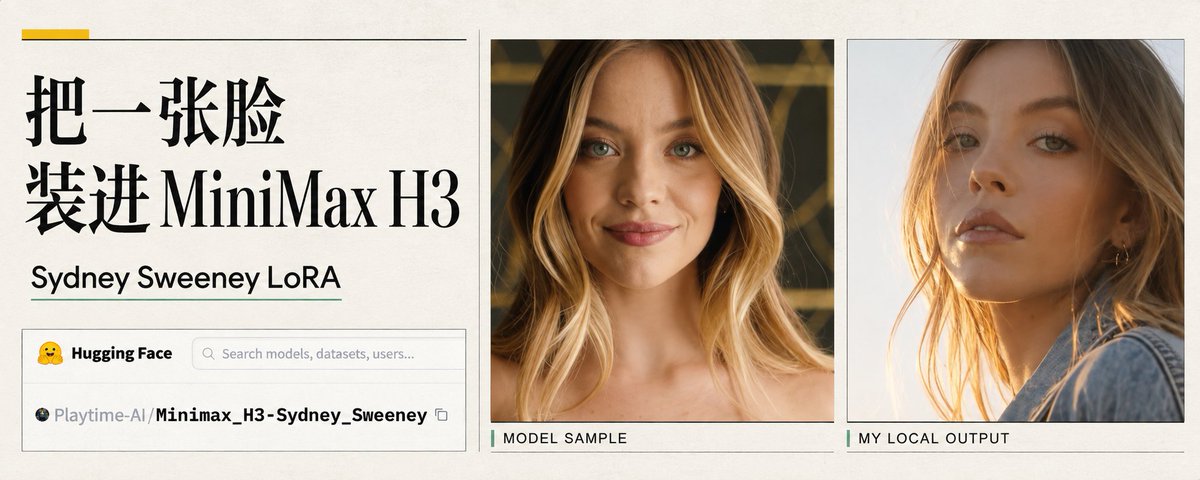
把 Sydney Sweeney 装进 MiniMax H3:人物 LoRA 的原理和本地使用

作者拆解了 Playtime-AI 发布的 Sydney Sweeney 人物 LoRA(仅 155MB)如何在 MiniMax H3 视频模型上无需参考图、仅凭名字生成人物视频。文章讲解 LoRA 低秩自适应原理:冻结基础模型,只训练小矩阵 A、B 记录人物身份差量;还原训练过程(3440 步、120 epoch、rank 16、约 5% caption dropout);并分享本地加载实践,包括底模版本兼容、量化格式、采样步数(6 步而非 30 步才清晰)和触发词拼写等常见坑。最后指出 LoRA 技术正在改变人物身份的传播方式。

技术 › LLM Michael Guo 2026-09-0813.8 KB 32.5K 183 87

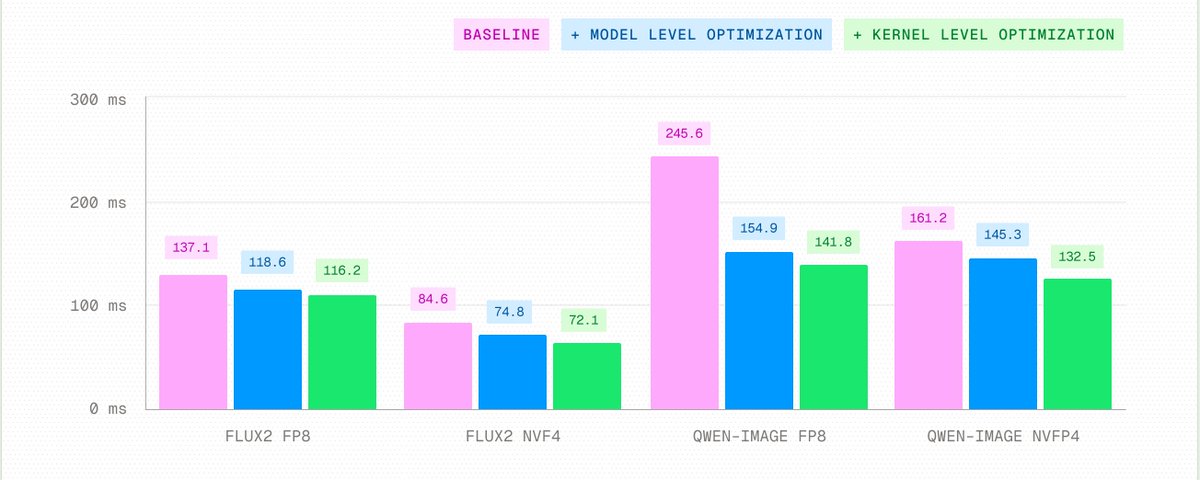
Agentic Kernels in Production

文章介绍了一个面向生产环境的 agentic kernel 优化框架,弥合基准测试与生产部署之间的差距。框架分为模型级优化和单 kernel 优化两层:先对完整 workload 进行 profile,提出算子融合、冗余消除等改进,再并行探索多个 kernel 实现并迭代优化。框架还具备自我改进机制,将成功与失败的优化经验存入知识库供后续复用。在实际部署中,该框架将 Qwen-Image 端到端延迟降低 42.3%,FLUX.2 降低 15.2%,MiniMax M3 吞吐提升 5.5%,具体优化包括 FP8 scale 预打包、QKV 投影融合、归一化与量化融合等。

技术 › LLM Brian Li 2026-08-2917.1 KB 265.1K 758 77

PixVerse R2世界模型:AI视频走向可交互的持续世界

文章介绍了PixVerse R2世界模型的突破:不同于生成固定内容视频的传统路线,R2实现连续可交互的视频流,用户的实时输入能持续影响场景、角色和故事。技术报告解析了其两层训练架构、Dynamic Chunk动态分块、Hybrid Teacher Forcing与Diffusion Forcing抑制漂移,以及Sink Memory、Rolling History、Object KV Cache三通道记忆系统。应用方向包括可探索的World、互动影游Story和实时数字人Character。作者认为影响持续存在的世界模型将催生互动影视、实时游戏和新型社交空间等新形态产品。

技术 › LLM 卡尔的AI沃茨 2026-08-2515.7 KB 3.3K 2 73

何恺明和字节Seed跳到同一条河流:连续扩散语言模型的范式转移

文章深度解读了2026年5月何恺明MIT团队与字节Seed团队前后发布的两篇论文(ELF与Cola DLM)。两者殊途同归,挑战了主流的自回归(AR)生成范式,主张将语言模型的生成过程从“离散Token预测”转变为“连续空间的潜变量扩散”。这种“先思考后落字”的铅笔模式,不仅提升了效率与效果,更可能引发LLM底层架构、评估标准及多模态统一范式的新一轮变革。

技术 › LLM 花叔 2026-05-2522.2 KB 8.9K 25 72