如何构建可持续维护的评估集
本文介绍了如何为AI Agent构建可长期维护的评估(eval)指标体系。指标分三类:目标指标、护栏指标和运营指标,三者结合使用。候选指标来源于错误分析和产品目标与硬约束。并非所有候选都值得跟踪:一次性问题用prompt修改解决即可,只有需要持续追踪的泛化问题才建指标;每个指标必须与具体决策挂钩,否则就是噪音。从零开始时,可先阅读30-50条trace并用自由文本笔记聚类失败模式。此外需定期重跑错误分析、退役失效指标,并警惕Goodhart定律导致的过拟合。
本文介绍了如何为AI Agent构建可长期维护的评估(eval)指标体系。指标分三类:目标指标、护栏指标和运营指标,三者结合使用。候选指标来源于错误分析和产品目标与硬约束。并非所有候选都值得跟踪:一次性问题用prompt修改解决即可,只有需要持续追踪的泛化问题才建指标;每个指标必须与具体决策挂钩,否则就是噪音。从零开始时,可先阅读30-50条trace并用自由文本笔记聚类失败模式。此外需定期重跑错误分析、退役失效指标,并警惕Goodhart定律导致的过拟合。
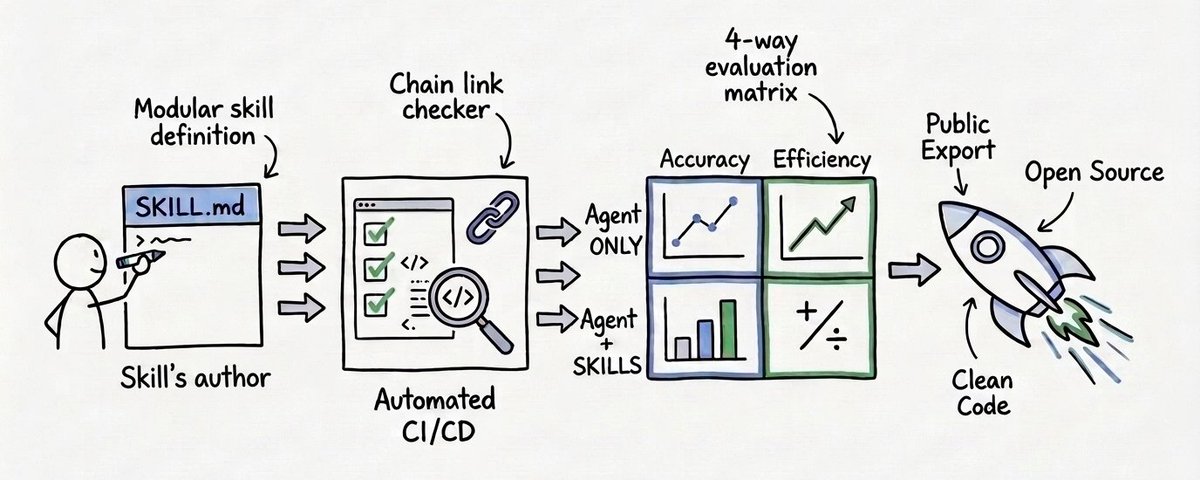
本文深入探讨了 Google Agent Skills 项目的构建与扩展。作者分享了如何通过标准化的存储结构、自动化 CI/CD 检查、持续的评估流程以及严格的所有权规则,来保证技能库在规模增长时的质量和可靠性。文章强调将技能视为产品而非简单代码片段,并介绍了利用 MCP 工具和 GitHub Actions 进行质量管控的实践。
本文是对 Cursor 官方博客《Continually Improving Our Agent Harness》的深度精读。文章剖析了 Cursor 团队在构建 AI Agent 产品时的工程化方法论,强调 Harness(系统提示词与工具调度层)是核心工程壁垒。内容涵盖从上下文管理、线上线下评估体系、工具错误治理(SRE 思维),到针对不同模型的深度定制及中途切换模型的技术挑战。核心观点是将 Agent 视为复杂软件系统,通过指标(如 Keep Rate)和自动化流程持续迭代。
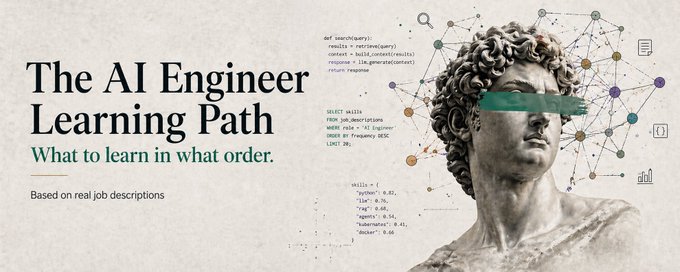
文章基于 2000 余份职位描述,规划了一条务实的 AI 工程师学习路径。重点指出 AI 工程并非从零训练模型,而是构建以 LLM 为核心的系统。核心技能包括 LLM 基础、RAG 检索增强、Agent 智能体、测试评估及监控部署。此外,文章还梳理了 Python、Web 开发、云原生及数据库等支撑性技能,并推荐了学习优先级与主流技术栈,旨在帮助开发者构建可靠、可落地的生产级 AI 系统。
本文记录了 AGI House 举办的一场关于前沿 AI 研究的晚宴讨论。参与嘉宾包括来自 OpenAI、Google DeepMind、Meta 及斯坦福等机构的顶尖研究人员与投资人。讨论重点从单纯的模型规模扩展转向系统化智能,核心观点包括:机器人仿真即将迎来类似 LLM 的突破时刻、智能将从目前的串行处理转向并行处理、AI 代理(尤其是编程 Agent)可能是通向 AGI 的路径,以及评估体系的滞后正成为新的瓶颈。