我把几十万字资料喂给AI后,总结出这套高效知识提炼工作流(附完整Prompt)
作者图南分享处理40万字行业调研资料的AI提炼方法论。指出直接让AI总结长文本会导致废话输出,原因包括'迷失在中间'的注意力规律、提问过于宽泛等。他提出'四步漏斗提炼法':认知骨架扫描、逆向审讯抽脂、红蓝对抗挑刺、知识资产封装,并附上4套实测可用的即插即用Prompt,强调用户需自己掌控提问节奏,用结构化认知建立AI时代的护城河。
作者图南分享处理40万字行业调研资料的AI提炼方法论。指出直接让AI总结长文本会导致废话输出,原因包括'迷失在中间'的注意力规律、提问过于宽泛等。他提出'四步漏斗提炼法':认知骨架扫描、逆向审讯抽脂、红蓝对抗挑刺、知识资产封装,并附上4套实测可用的即插即用Prompt,强调用户需自己掌控提问节奏,用结构化认知建立AI时代的护城河。
文章深入探讨了 AI Agent 遗忘信息的根本原因。作者指出,问题通常不在于检索,而在于 KV Cache 在上下文过长时的处理机制。文章对比了 StreamingLLM(仅保留近期信息)与 SnapKV(基于注意力分数保留关键信息)的区别,并解释了模型如何通过“注意力权重”来决定哪些 Token 值得被记忆,从而实现 92% 的压缩比且不丢失关键信息。
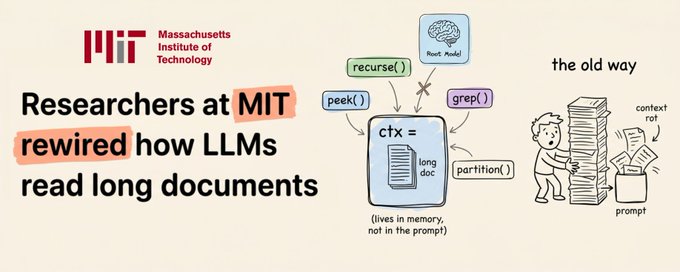
文章介绍了一种称为递归语言模型(RLMs)的新方案,旨在解决大语言模型在处理超长上下文时出现的“上下文腐烂”问题。RLMs 不再将上下文限制在单一 Prompt 中,而是将其视为外部数据,通过赋予模型窥探、正则匹配、分区和递归调用等工具,让模型自主决定如何分解和处理任务。这种方法不仅消除了上下文长度对推理能力的影响,还提高了准确性和成本效率。