Wiki 知识库

全部文档 / 标签: 模型架构

17 篇
清除

中关村学院 3 个月从零训练 7B SOTA 模型的启示

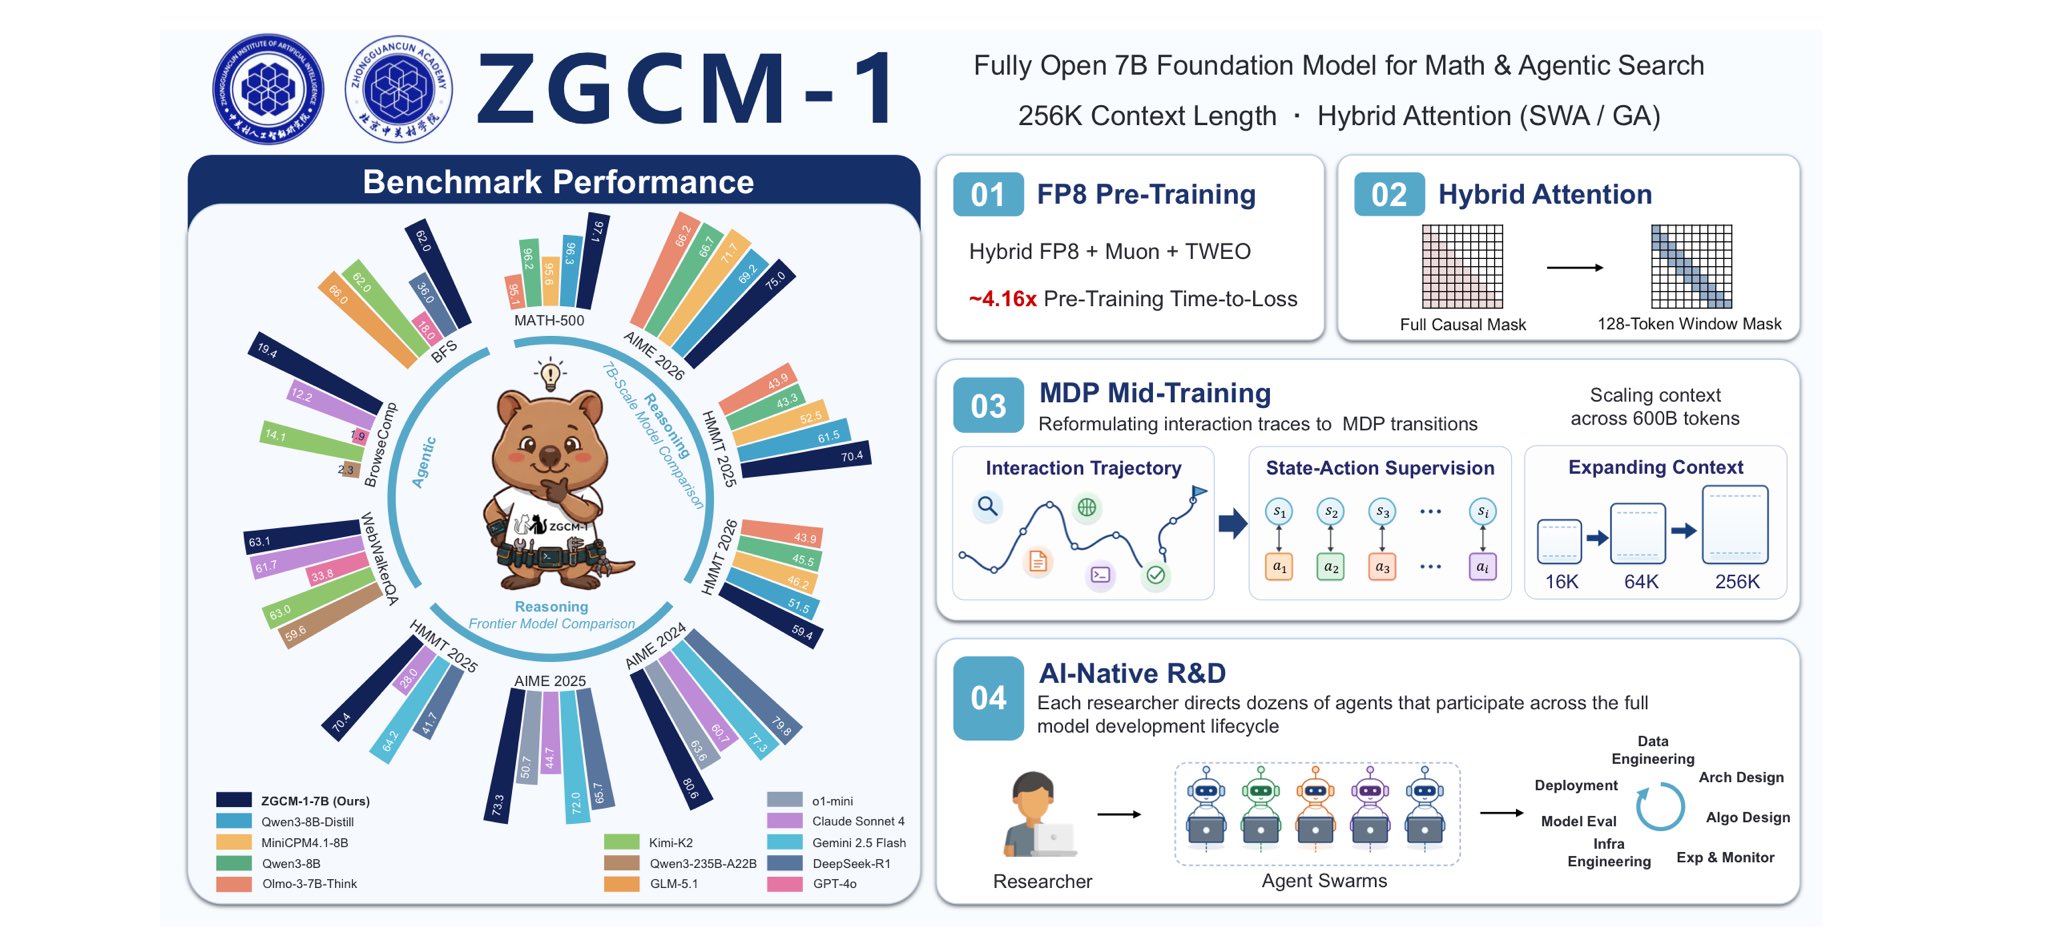
作者评述中关村学院何纪言老师带领 7 位博士生用 3 个月从预训练、中训练到后训练完全自主训练出 7B 模型并达到 SOTA 水平。文章提出三点观察:一是当前模型能力远未到全自主程度,在架构设计、算法设计等方面仅达 L2 辅助水平;二是模型训练会者不难,MiMo V2.6 RL 仅花 300 多万美金即达高水平,说明关键是人才而非算力堆砌;三是数据是新的代码,数据质量如同代码质量一样重要,该模型在数据清洗、课程学习、上下文扩增和 RL 优化上做了深入工作。

技术 › LLM Bojie Li (@bojie_li) 2026-09-262.6 KB 63

Behind Jev: Two Hypotheses About Its Base Model

文章探讨 TypeSafe 公司 Jev 决策 API 背后可能的基础模型架构,提出两种假设:一是 BERT 风格的双向编码器,二是去掉生成循环、直接输出决策概率的因果解码器。作者引用 Archer Hume 基于约一万次 API 调用的逆向分析,认为其可能是带共享状态计算、独立问题分支和直接概率读出的因果 Transformer,甚至可能是 MoE 架构,但其研究无法区分编码器与解码器。文章还通过 OpenJev 等开源项目(基于冻结的 Qwen3.5-4B 权重)证明使用因果模型骨干做直接决策打分在技术上可行,并讨论了因果注意力、前缀缓存等工程优势。作者强调这些都是架构假设,不能确定 Jev 的真实权重来源。

技术 › LLM Roy Chen 2026-09-1911.5 KB 45.6K 123 74

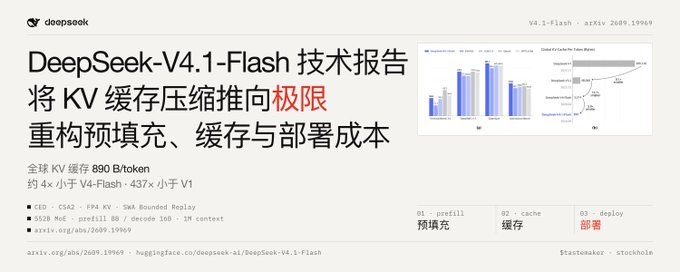
DeepSeek-V4.1-Flash 技术报告:将 KV 缓存压缩推向极限,重构预填充、缓存与部署的成本结构

本文深度解读 DeepSeek-V4.1-Flash 技术报告,该模型通过 CED 不对称编码器-解码器架构、CSA2 跨层稀疏注意力复用、FP4 主 KV 量化及 SWA Bounded Replay 近似恢复四项设计,将常驻 HBM 的全局 KV 缓存降至 890 bytes/token(约为上一代四分之一),持久化缓存降至八分之一。文章详细解析各项技术的原理与协作机制,澄清了对压缩数字的常见误读,评估模型能力变化,并与 PagedAttention、MiniCache 等已有 KV 压缩路线对比,指出该工作将缓存压缩从算法点推进为面向百万 token 长程 agent 场景的系统级共同设计,同时讨论其证据强度与局限。

技术 › LLM meng shao 2026-09-1921.7 KB 7K 25 82

读懂大模型|别怕,大模型的本质就是一个函数

文章以 DeepSeek 开源的 V4-Flash-Vision-Exp 为例,深入浅出地讲解大模型的本质:一个做矩阵运算的超大函数。作者介绍了模型文件结构(权重分片、config.json、tokenizer.json),并详细解析输入输出处理流程,包括文本分词、BPE 算法、Embedding、MoE 混合专家架构、概率性输出与自回归生成机制。此外还逐项解读了核心参数,如词表大小、网络层数、注意力头数、YaRN 长上下文伸缩、视觉模块和 FP8/FP4 低精度量化等,帮助读者建立对大模型原理的整体认知。

技术 › LLM ray 2026-09-0413.7 KB 2.9K 7 74

BestBlogs 早报 · 08-28|MHS 连接真实设备,Anthropic 重构产品协作,GLM 5.3 Flash 以架构与国产芯片降本

本期早报聚焦智能体真实交付的三个坐标。其一,Anthropic 的 MHS 研究预览通过标准驱动和统一能力格式,把实验室设备集成从数周压缩到数小时,让智能体操作显微镜、移液工作站与机械臂,卡内基梅隆团队报告实验速度提升约三倍。其二,Mike Krieger 讨论智能体时代团队从逐步派任务转向结果委派,同时强调可观测性、Feature Flag 与意图审查等工程控制的重要性。其三,智谱 GLM-5.3-Flash 通过稀疏注意力、视觉反馈和国产芯片推理栈实现五层降本。速览覆盖教育实验、双盲评估、数据治理、商业协议与算力金融化等话题。

技术 › LLM ginobefun 2026-08-2829.0 KB 5K 1 79

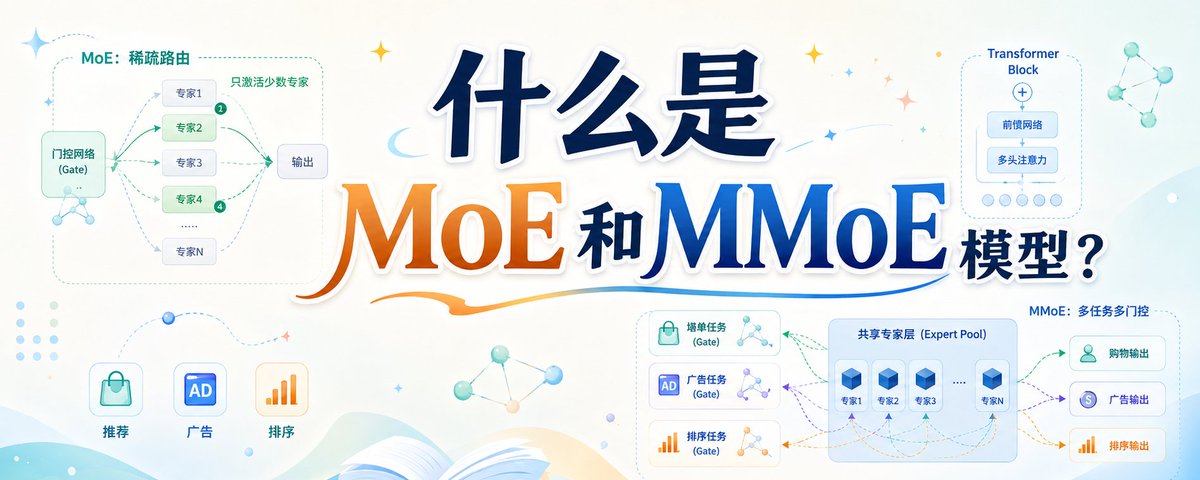
MoE与MMoE模型详解:从稀疏扩容到多任务学习

本文系统梳理了MoE(混合专家)模型的概念分歧与技术演进。针对目前命名混乱导致的认知误区,作者明确划分了两条核心技术路线:一是追求参数量与计算量解耦的稀疏路线,已成为大语言模型的默认架构;二是通过多门控机制实现任务共享的MMoE路线,主要应用于推荐系统。文章深入回顾了条件计算思想,并详细探讨了稀疏MoE在路由设计、负载均衡、并行通信等工程实践及结构演进的现状。

技术 › LLM snowboat 2026-08-0760.2 KB 16.2K 16 89

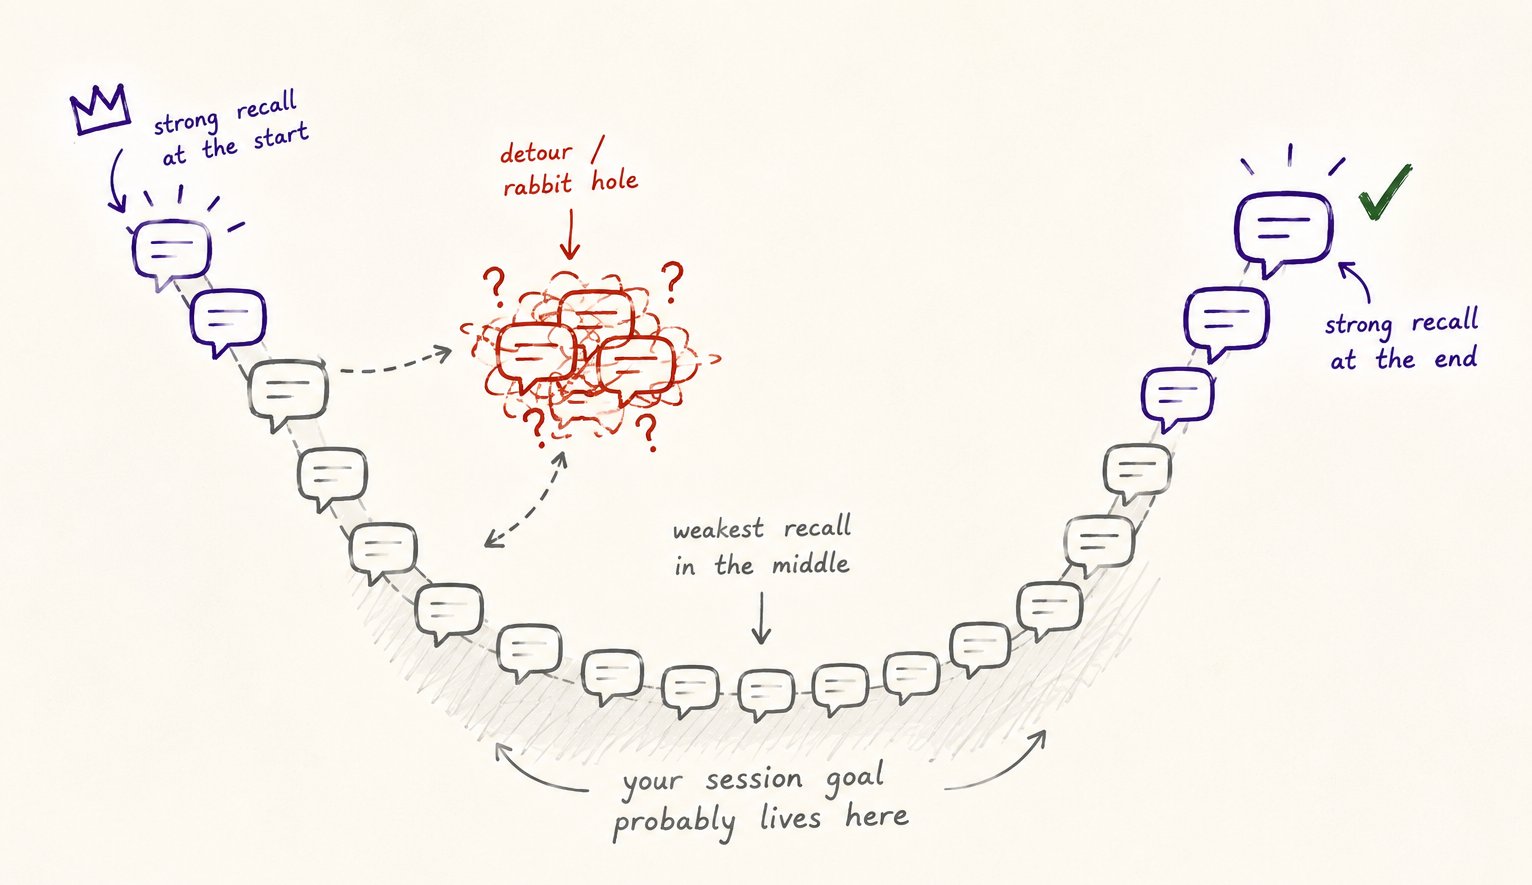
为什么 Claude Code 会话会随时间变差

本文深入探讨了 Claude Code 等智能体工具在长对话中性能下降的现象。作者将其归因于“上下文腐烂”,分为无法避免的内在腐烂(模型架构限制)和可管理的内容腐烂(过时信息积累)。文章提供了具体的治理实践,包括前期策展、保持上下文清洁、及时重置以及使用 git 树结构管理会话,以维持工具的敏锐度。

技术 › Claude Code yibie 2026-08-0317.3 KB

Kimi K3 技术报告拆解:全球首个开源 3T 级模型

本文拆解了 Kimi K3 的技术报告,这是一个全球首个开源的 2.8 万亿参数模型。文章详细解析了其混合注意力架构、注意力残差机制、MoE 设计以及在长文本训练和推理优化上的创新。报告指出 K3 性能虽略逊于顶级闭源模型,但在多项任务中表现优异,且具有极高的成本效率,甚至已能辅助团队进行内核优化和芯片设计。

技术 › LLM Berryxia.AI 2026-07-2920.0 KB 393.1K 186

算不上AGI,但Anthropic发现了Claude的潜意识

Anthropic发布最新论文,利用J-lens技术在Claude内部发现了区分意识与潜水的分界线(全局工作空间)。文章通过五个实验证实了Claude存在类似人类「意识剧场」的结构,并能检测出其内心隐藏的安全风险。最关键的发现是:通过「反事实反思训练」可改写模型潜意识,提示词中应避免否定指令以减少干扰。

技术 › LLM 花叔 2026-07-0722.7 KB 32.5K 55

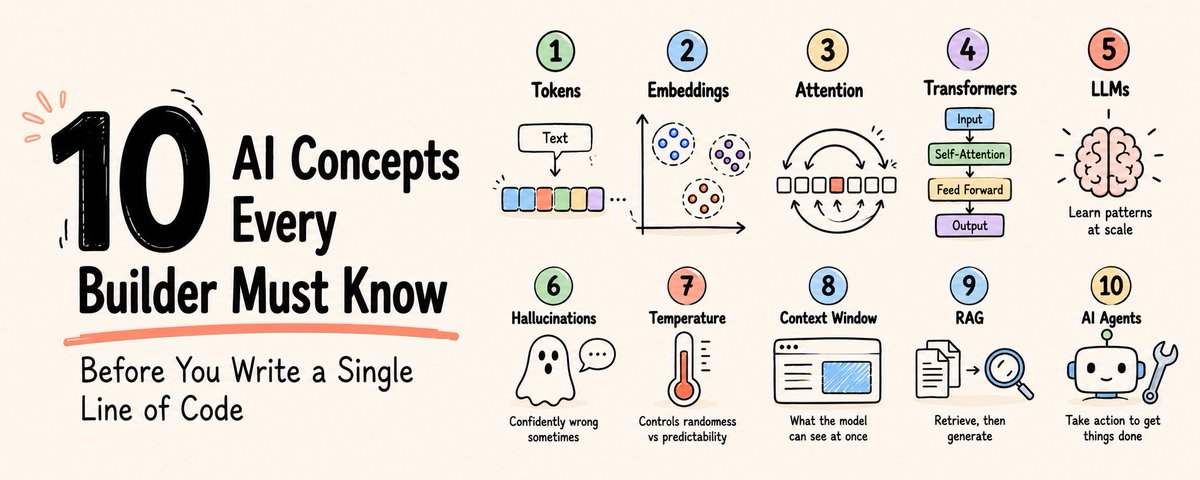
开发者在写代码前必须理解的 10 个 AI 核心概念

本文阐述了 AI 开发者在编写代码前必须掌握的 10 个核心概念,而非急于动手写代码。文章解释了 Tokens(计费基础)、Embeddings(语义理解)、Attention(上下文机制)以及 Transformers(模型引擎)等原理,深入剖析了 LLM 的本质、幻觉产生的原因、Temperature 对输出的控制作用以及上下文窗口的重要性。理解这些心智模型,能帮助开发者避免盲目调试,构建出更稳定、高效的 AI 应用。

技术 › LLM Rahul 2026-06-0412.8 KB 584.7K 402 76

DeepSeek 的 10 万亿美元大战略:技术、算力与国产芯片的未来

本文深入分析了 DeepSeek 如何通过 MLA、MoE、mHC 等一系列底层技术创新,极大幅度降低大模型对 HBM(高带宽内存)和先进 GPU 制程的依赖。文章指出,DeepSeek 的战略并非局限于软件订阅,而是旨在通过算法优化盘活中国产能充足的 NAND 闪存和 LPDDR 产业,以此构建一套独立于西方之外的 AI 硬件生态,最终撬动价值 10 万亿美元的产业巨兽。

技术 › LLM 宝玉 2026-05-2426.0 KB 207.1K 387 82

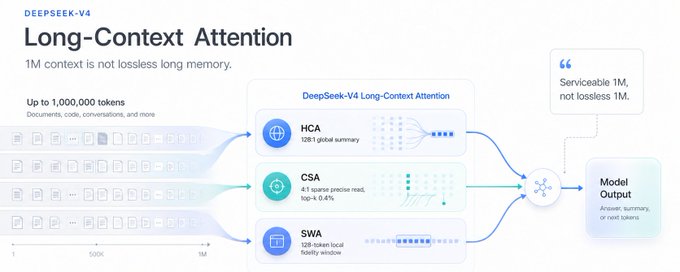
DeepSeek-V4 工程权衡分析:1M 上下文并非无损记忆

文章深入剖析了 DeepSeek-V4 如何通过 HCA、CSA 和 SWA 三通道并行架构,将 KV Cache 压缩至基线的 2%,从而实现工程上可行的 100 万 token 上下文。然而,这种极致的压缩是有代价的:MRCR 8-needle 测试准确率在 1M 长度下显著下降至 0.59。文章指出,V4 通过牺牲检索精度换取了推理成本的数量级降低,是一种‘有损的 1M’,并明确论证了该设计原理上无法完全替代 RAG 系统。

技术 › LLM GoGoNN 2026-04-2845.4 KB 16.8K 23 75

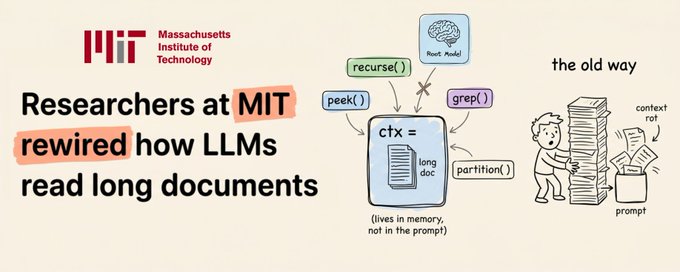
Recursive Language Models (RLMs) 清晰解释:解决大模型长上下文推理难题

文章介绍了一种称为递归语言模型(RLMs)的新方案,旨在解决大语言模型在处理超长上下文时出现的“上下文腐烂”问题。RLMs 不再将上下文限制在单一 Prompt 中,而是将其视为外部数据,通过赋予模型窥探、正则匹配、分区和递归调用等工具,让模型自主决定如何分解和处理任务。这种方法不仅消除了上下文长度对推理能力的影响,还提高了准确性和成本效率。

技术 › LLM Akshay 2026-04-2812.6 KB 131.6K 441 68

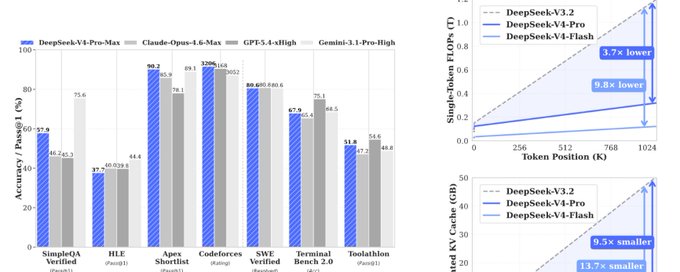
本周顶级 AI 论文综述:DeepSeek V4 与自进化智能体

本周综述重点介绍了 DeepSeek V4,这是首个默认支持百万 token 上下文的开源模型系列,通过 CSA/HCA 混合注意力机制和领域专家后训练技术,在推理性能上媲美 GPT-5.2。此外,还涵盖了 Apple 的 Mamba 架构知识蒸馏方法、Autogenesis 自进化智能体协议,以及 Skill-RAG 失败感知检索系统。

技术 › LLM DAIR.AI 2026-04-2733.5 KB 74.7K 165 68

Looped LLM 与深度缩放:解析 Claude Mythos 的架构演变

文章基于作者在 ByteDance Seed 的研究经历,探讨了 Looped LLM 架构的起源与演进。作者通过分析 Anthropic 发布的 Claude Mythos 在 GraphWalk BFS 基准上的异常表现,指出 Looped 架构在多跳推理和状态追踪上的优势。文章进一步深入讨论了 Looped LLM 在扩展至 10T/100T 规模时面临的深度稳定性、推理效率和 FLOPs 有效性的三大挑战,并对比了 RNN 视角与 Parallel Looped Transformer 等解决方案。

技术 › LLM Rui-Jie Zhu 2026-04-2230.5 KB 85

本周顶级 AI 论文选读:自动化研究员、长周期 Agent 评估与 Nemotron 模型

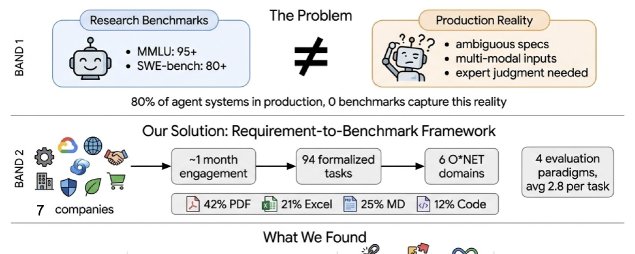
本周重点关注四大 AI 进展:Anthropic 展示 Claude 可进行全自动化对齐研究,成本仅 1.8 万美元且表现接近完美;AiScientist 提出基于文件系统的长周期工程架构;AlphaEval 揭露了 Agent 从研究到生产环境的巨大鸿沟;NVIDIA 发布开源 120B 参数模型 Nemotron 3 Super,采用混合 MoE 架构优化推理吞吐。

技术 › LLM DAIR.AI 2026-04-2033.8 KB 57.2K 168 82

你不知道的大模型训练:原理、路径与新实践

本文深入探讨了大模型训练的全链路流程,指出2026年模型效果的差距主要源于后训练阶段。文章从预训练底座、数据配方、系统架构约束、后训练(SFT/RLHF/DPO)以及 Eval/Reward 机制五个维度,解析了如何通过工程化手段提升模型实际落地效果,并引用了 DeepSeek、Llama 等实例。

技术 › LLM Tw93 2026-04-0333.6 KB 650.9K 86