Wiki 知识库

全部文档 / 标签: decode

8 篇
清除

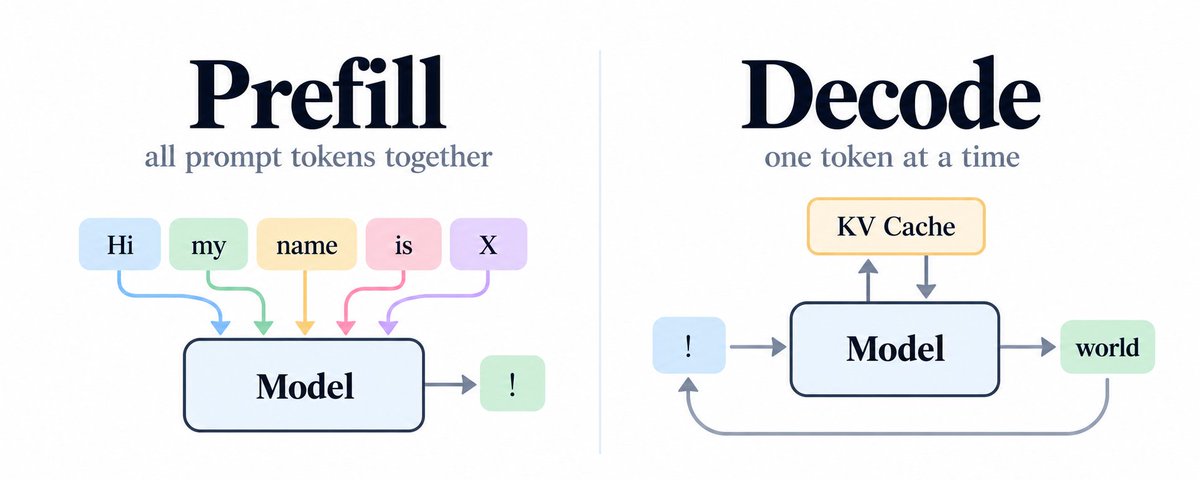
Prefill & Decode made Crystal Clear

本文从第一性原理出发,逐步讲解 LLM 推理过程中 Prefill 和 Decode 两个阶段的真实含义。作者先介绍自回归模型逐 token 预测的基本机制,然后通过 ChatGPT 聊天的例子,展示文本如何经过分词、token ID、embedding 转化为 S×D 矩阵并进入 Transformer 层。重点澄清一个常见误解:处理输入 prompt 时模型并非逐个 token 顺序处理,而是因为所有输入 token 已知,可以并行处理——这一整个输入处理过程就是 Prefill。文章还引出因果掩码等问题,帮助读者建立对推理流程的正确直觉。

技术 › LLM Abhinandan 2026-10-0326.3 KB 9.2K 133 64

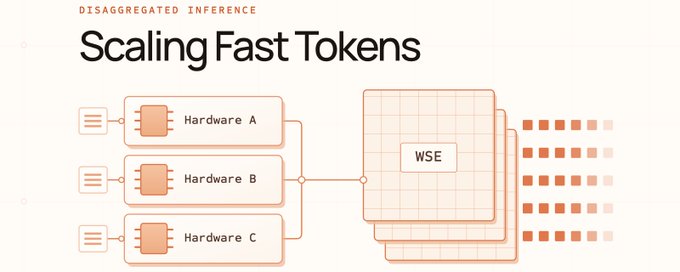
Disaggregated Inference From The Ground Up

本文由 Cerebras 撰写,从基础原理讲解推理系统中的分离式推理技术。文章先介绍加速器的构成(计算单元与存储),并引入算术强度概念,通过矩阵加法与矩阵乘法的实例说明数据搬运与计算的关系。随后分析 LLM 推理的两个阶段:prefill(处理整个 prompt,计算密集型)与 decode(逐 token 生成,受限于内存带宽),解释二者对硬件需求的不同。Cerebras 提出异构分离式推理,将不同类型芯片分配给不同推理阶段,在相同硬件数量下将吞吐量提升 5 倍且不损失单用户生成速度。

技术 › LLM Cerebras 2026-10-0219.6 KB 400.2K 299 70

LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程

本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。

技术 › LLM meng shao 2026-09-2218.3 KB 14.6K 139 84

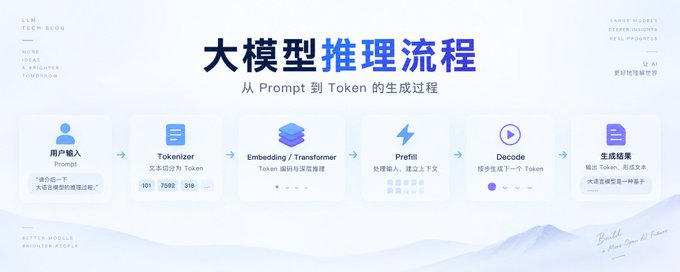
一文了解大模型推理流程

文章系统讲解大模型推理的完整流程:输入文本先经Tokenizer切分为token并转换为token id,再通过Embedding转为带位置信息的语义向量;随后进入Prefill阶段,模型并行处理整个prompt,通过Transformer的Self-Attention计算Q、K、V并生成KV Cache,经Causal Mask确保不偷看未来token;最后经LM Head和softmax输出第一个token。进入Decode阶段后,逐个生成token、不断更新KV Cache,直到满足EOS、max_tokens或stop条件终止,最终反解码为文本输出。

技术 › LLM Jerry Fang 2026-09-184.9 KB 1.4K 8 53

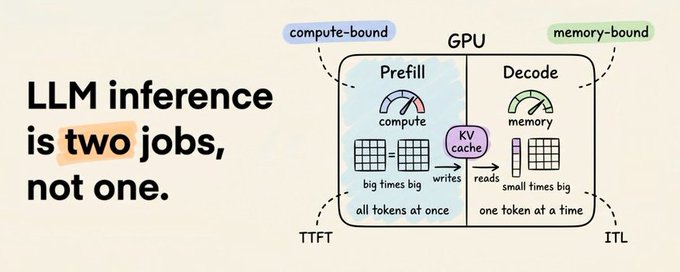
LLM Inference After Training: Prefill, Decode, KV Cache

本文系统讲解 LLM 推理阶段的核心原理。作者指出推理与训练不同,分为 prefill 和 decode 两个阶段:prefill 并行处理整个提示词、计算密集型、决定首 token 延迟(TTFT);decode 逐 token 生成、受 HBM 内存带宽限制、决定 token 间延迟(ITL)。文章介绍了 GPU 关键硬件概念(Tensor Core FLOPS、HBM、SRAM),逐步演示一个请求的完整流程(分词、采样、KV cache 机制),并将 FlashAttention、PagedAttention、continuous batching、RadixAttention 等优化技术归位到这两个阶段中,帮助读者理解推理瓶颈与优化方向。

技术 › LLM Karan 2026-09-1713.8 KB 29.4K 187 83

Prefill and Decode:理解 LLM 推理的两个阶段

文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。

技术 › LLM Dongxi 东锡 NLP 2026-09-1511.3 KB 24.8K 89 74

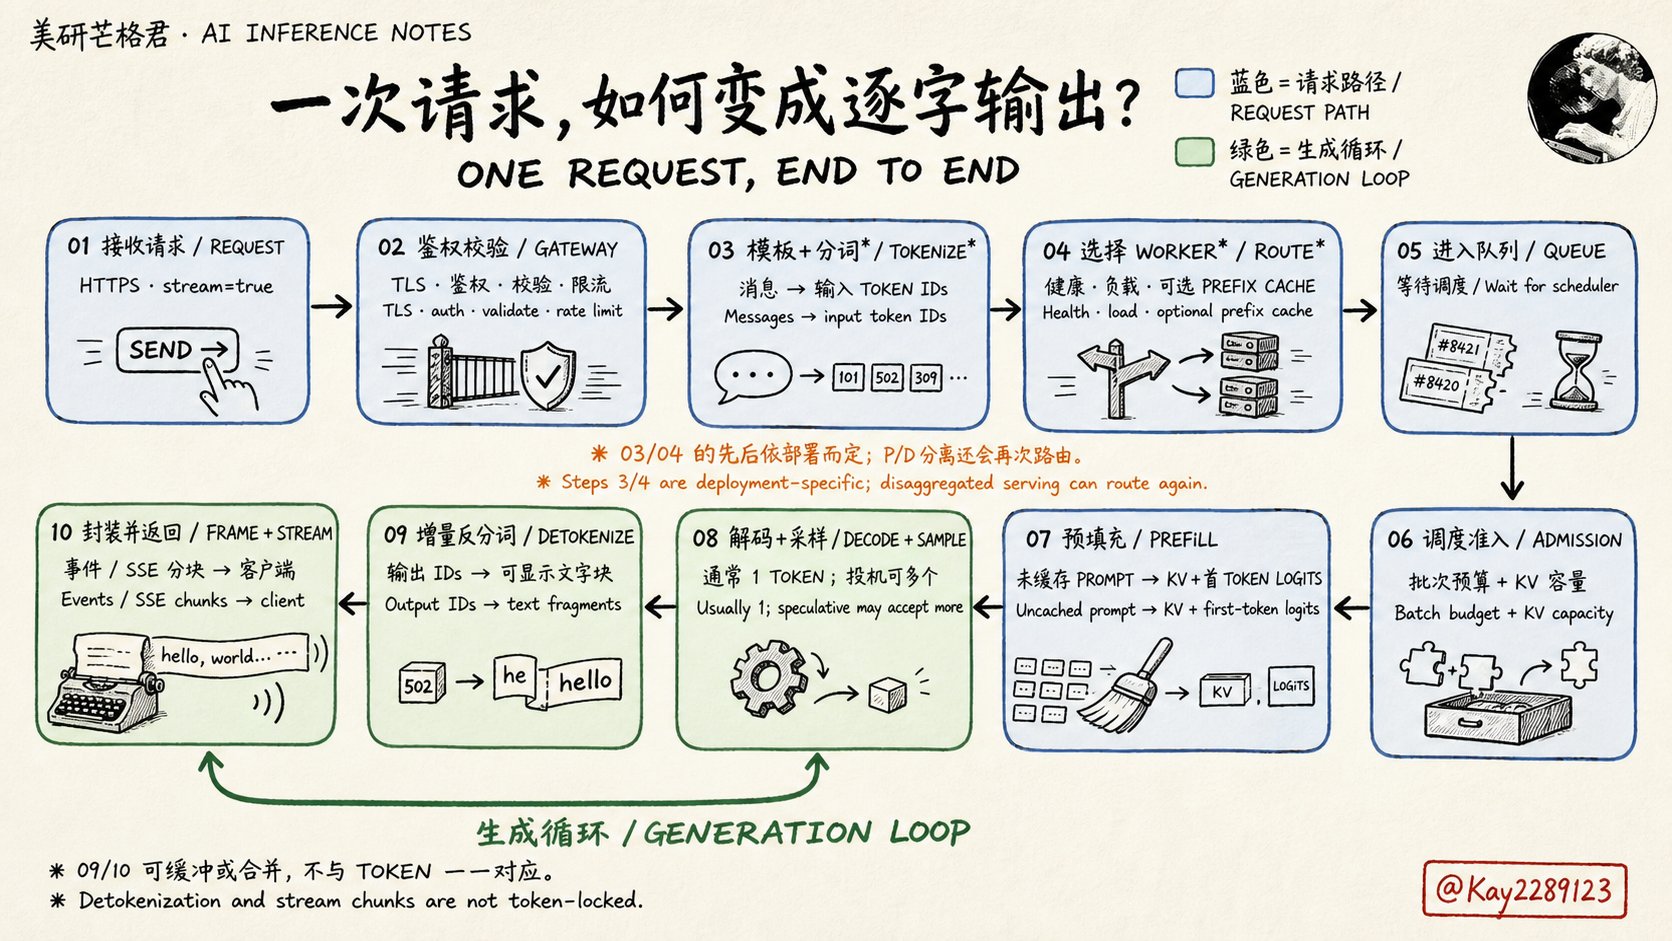
一张图讲清 AI 推理内部流程:从发送请求到首 Token 输出

作者基于在硅谷大厂面试上百人的经验,介绍 AI 推理的完整内部流程:用户发送请求后,需经过 HTTPS 鉴权、模板化分词、路由排队与 KV 容量管理,Prefill 处理完未缓存的 Prompt 后才输出首个 Token,随后进入 Decode + sampling 循环,经增量反分词、SSE 分块返回客户端。作者强调 AI 推理不只是 GPU 速度问题,首 Token 延迟取决于并发排队与 Prefill 的均衡,持续输出取决于 Decode,需优化 KV Cache 以在有限硬件资源下服务更多用户。文中还提到帮团队成员规划了从 SDE 转型 AI infra 的 12 周学习路线。

技术 › LLM 美研芒格君 (@Kay2289123) 2026-08-302.0 KB 57

LLM 推理原理详解:从 Prefill 到 Decode

本文深入解析了大语言模型(LLM)推理的计算流程。文章指出,LLM 推理主要包含 Prefill(处理提示词,计算密集型)和 Decode(逐词生成,显存带宽密集型)两个阶段。作者详细阐述了分词、Embedding、Transformer 层及 KV Cache 的工作原理,并分析了 KV Cache 带来的内存挑战及 vLLM 的优化方案。最后,探讨了 DeepSeek-V4 等新架构通过重新设计注意力机制来从根本上压缩 KV Cache 的创新思路。

技术 › LLM Avi Chawla 2026-06-2923.7 KB 320.3K 776