Wiki 知识库

全部文档 / 标签: 持续学习

19 篇
清除

让 AI 帮你做事,但希望你仍然可以不断学习

作者总结了半年高强度使用 AI 和 Agent 的实践经验:通过沉淀确定性知识库、将高频任务封装为 Skill、用 Plugin 弥补能力不足、多 Agent 分工协作以及构建外部记忆层来搭建可靠的 Harness 工作环境。同时强调 AI 是工具而非决策者,切勿把思考让渡给 AI;AI 并没有创造新需求,重塑的是服务边界;瓶颈在于人的认知与判断力。作者认为 Agent 已能交付生产级成果,真正的护城河是个人的业务理解与持续学习,建议以明确目标驱动闭环,先动手试用再说。
技术 › Agent 饭团儿 2026-10-1516.6 KB 2K 4 70

How We Built Memory For Continually Learning Sales Agents

本文介绍了Monaco团队为持续学习的销售Agent构建记忆系统的实践。作者提出下一代收入平台应从'记录系统'进化为'智能系统',并设计了Monaco Memory:分为组织记忆与用户记忆两层,采用人类与模型都可读的版本化Markdown(S3存储)作为载体,保证可解释性和可编辑性。系统通过基于事件的pub-sub触发器和定期'反思'(reflection)两种机制自动更新记忆,并将记忆作为上下文注入各Agent任务中。文章以账号筛选排除和异议处理两个场景展示了记忆系统如何提升销售工作流的智能化水平。

技术 › Agent Mihail Eric 2026-10-018.6 KB 8K 135 79

健康长寿的真相:真正的密码不在基因里,关键是这五件事

作者通过解读一项针对1400多名80岁以上健康老人的基因研究发现,健康长寿并不存在所谓的“超级基因”,而是与长期生活方式密切相关。文章总结了健康老人共同的五个特征:保持适度偏瘦的体重、持续学习让大脑保持活跃、保持乐观心态、积极经营真实的人际社交、坚持运动并保护肌肉。作者强调健康管理是几十年的长期工程,关键在于把正确的事情持续重复很多年,最终获得健康、自由、有尊严的晚年生活。

生活 › 健康 杨高能 2026-09-129.2 KB 9.8K 29 70

想做专业期权交易员?先把这两项底层基本功焊死

拥有12年经验的期权交易员分享成为专业期权交易员所需的两大核心基本功:理智与持续学习能力。作者指出数学天赋并非硬门槛,关键在于识别直觉中的逻辑思维和概率感知盲区,并强调市场不断变化需要持续迭代。文章还给出普通人学习路径:掌握希腊字母、吃透波动率体系、策略由简入繁、坚持复盘归因、敬畏概率。最后提醒不要迷信全职交易的自由光环、警惕高胜率陷阱、多用小仓位实盘练习,并指出套利才是期权交易的进阶蓝海。

投资 › 期权 期权坤哥 | Sober CFA 2026-09-078.7 KB 6.2K 39 71

Top AI Papers of the Week

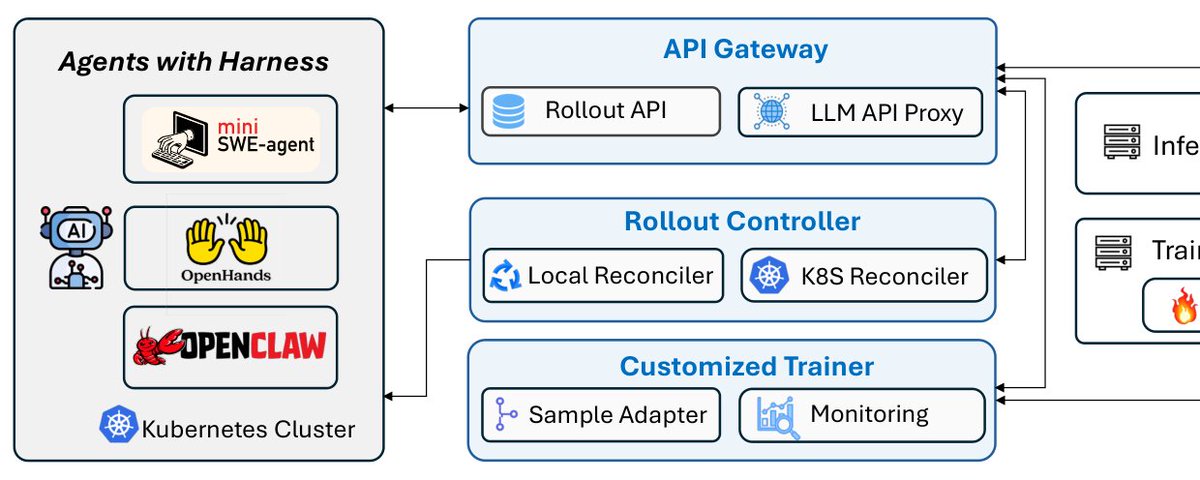
DAIR.AI 盘点本周 AI 领域重要论文:微软 Agent Lightning 通过端点代理将任意 Agent harness 接入 RL 训练;Skill 触发瓶颈论文提出三层协议缓解提示词槽位稀缺;Harness 级遗忘现象被命名并给出测量协议;对十个真实 Agent 应用的剖析发现非 LLM 组件主导一半应用的延迟;Skill 机制研究表明程序性锚定远胜知识注入且库规模过大导致精度崩塌。核心主题是 harness 应成为训练与优化栈中的一等公民。

技术 › Agent DAIR.AI 2026-08-2414.5 KB 38K 148 81

让AI从新人变成长期的同事——硬核拆解Alloomi的三层技术路线

作者通过分析Alloomi的两篇技术报告,拆解了让AI具备长期工作能力的三层技术路线:记得住、学得会、做得成。第一层通过给信息打标签、时间有效期管理和连接强化构建持久化上下文记忆(OpenContext已开源);第二层通过经验池筛选、微调飞轮和Engram X设计将经验写入模型权重实现自我进化,并配有三裁判安全阀机制;第三层在SWE-Bench-CL、JobBench、GDPval等基准上验证端到端交付能力。三层构成可回滚的闭环,让AI每完成一次交付就变强一点。

技术 › Agent AI少年 2026-08-1815.9 KB 19K 73 74

Agent员工的重要一环:Agent 的经验去了哪里?

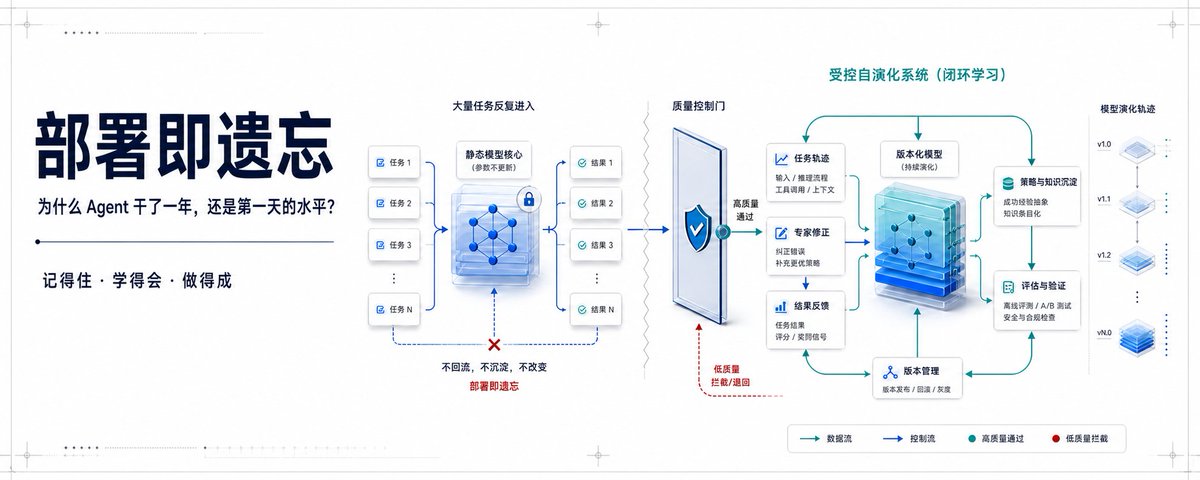
文章探讨企业Agent普遍存在的“部署即遗忘”问题:Agent完成任务却未把专家的修改、否决和判断理由转化为经验。Alloomi提出“记得住、学得会、做得成”三层技术路线:用Holistic Context组织带时间和来源的长期上下文,用Self-Evolving Agent从筛选后的任务轨迹中学习并通过版本化机制保证可审计可回滚,最终在真实交付中检验能力。文章认为Agent公司的护城河在于版本之间积累的经验与评价体系,而非模型本身。

技术 › Agent Russell 2026-08-1817.3 KB 9.4K 71 74

Agent的长期记忆与学习:从保存到判断的跨越

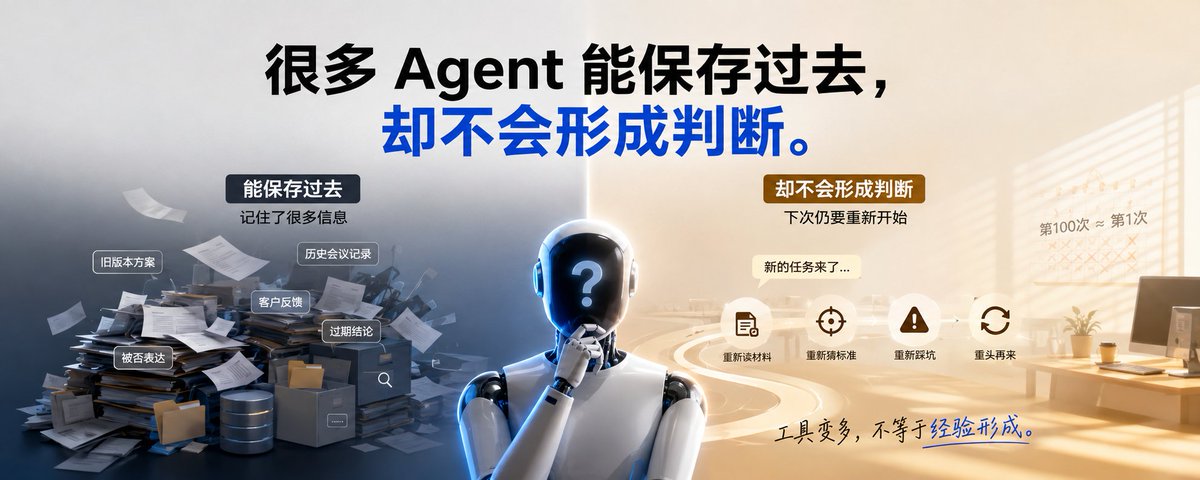
文章探讨了当前Agent系统在长期记忆与学习能力上的局限,指出许多系统仅能保存历史数据,却无法理解信息的时效性和判断的演变。作者以Alloomi的技术报告为例,介绍了其Holistic Context和Self-Evolving Agent两条技术路线,分别解决动态上下文管理和模型自我进化问题。通过公开评测数据,展示了在长上下文理解、持续学习和专业交付方面的提升。文章强调,真正的Agent能力应体现在将工作经验转化为模型能力,并建立从真实反馈到模型更新的闭环,这对企业级应用尤为重要。

技术 › Agent DeFi狙击手 | Ai|Gate美股0费率 2026-08-1511.9 KB 17.5K 59 69

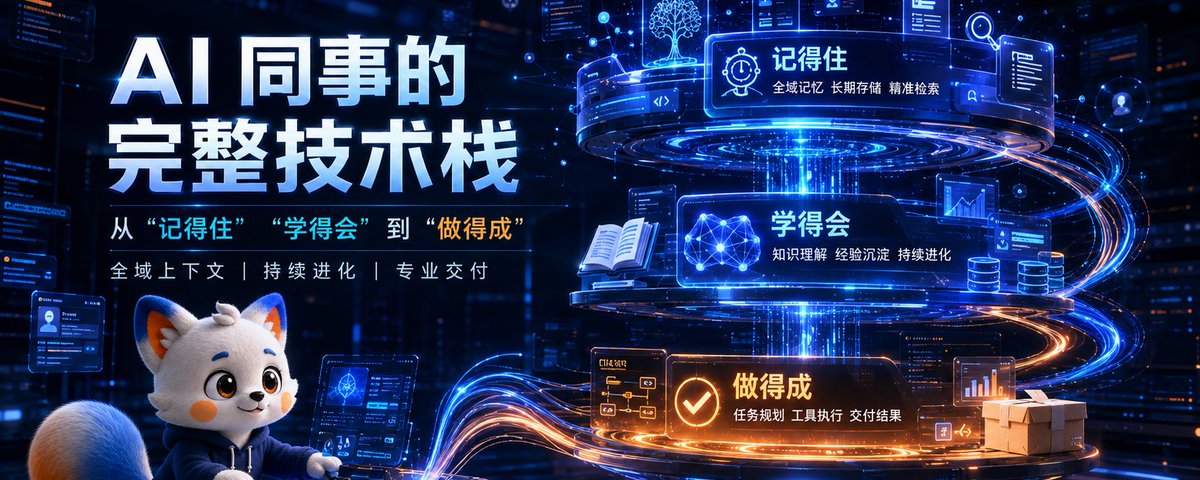
AI 同事的完整技术栈:从“记得住”“学得会”到“做得成”

本文介绍了 Alloomi 提出的 AI 同事完整技术栈,由三层能力闭环组成:Holistic Context 负责跨会话的上下文记忆,Self-Evolving Agent 通过后训练从反馈中学习,专业交付层验证实际工作成果。文章详细阐述了每层的技术机制、benchmark 结果及其局限性,并强调 OpenContext 仅是工程底座而非完整方案。最终指出,只有三层协同工作,才能实现可持续的 AI 同事。

技术 › LLM 一 2026-08-1511.7 KB 18.7K 44 73

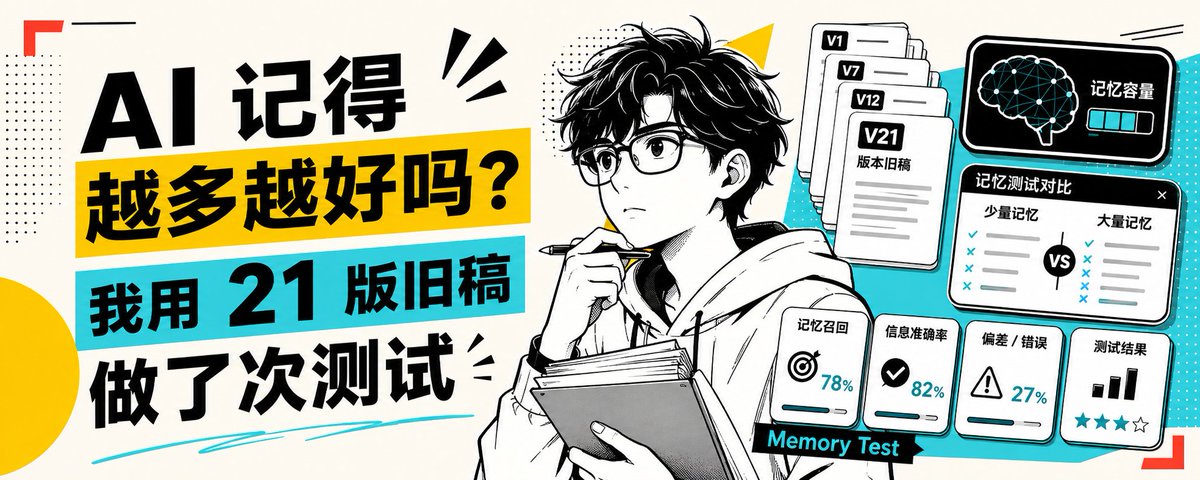
AI 记得越多越好吗?我用 21 版旧稿做了次测试

作者用一篇修改过21次的旧稿测试了开源组件OpenContext,探讨AI长期记忆的核心问题:记住多少才算够?文章将AI长期记忆拆解为三层:记得住(Holistic Context)、学得会(Self-Evolving Agent)、做得成(真实交付),并分别对应OpenContext、后训练循环和benchmark评测。作者通过本地测试验证了消息写入、读取和版本标记功能,但语义搜索未配置。文章强调,AI记忆的关键不在于存储量,而在于理解信息的时效性、冲突和取代关系,并最终将经验转化为下一次交付的提升。

技术 › LLM 小墨同学 2026-08-1419.4 KB 75

AI Agent 的自进化:从第二次交付看真实能力

本文探讨了AI Agent 的自进化能力,提出判断其是否真正变强的关键在于第二次交付的表现。作者认为,如果Agent每次任务都从零开始,无法记住上次的修改和专家的纠正,那么系统只是在重复劳动。文章介绍了Alloomi 的路线,即通过沉淀真实工作中的判断、修改和结果,让经验成为下一次交付的输入,形成复利闭环。文中还展示了Alloomi 在长期记忆、持续学习和专业交付方面的benchmark数据,并讨论了其技术架构,包括Holistic Context 和Self-Evolving Agent,以及开源项目OpenContext。最后,作者强调下一代AI公司的护城河在于用户第二次任务是否优于第一次,以及模型能否从经验中学习并回滚错误。

技术 › Agent bbshare (@shadouyoua) 2026-08-148.2 KB 64

AI代理的新前沿:从真实世界经验中自我进化

本文探讨了AI代理从工具调用到子代理协作再到处理更大上下文的演进,指出当前代理在真实工作中受限于缺乏真实世界经验和学习能力。作者提出全栈模型+应用的方法,通过整体上下文、自进化记忆模型、专家锚定和受控进化四层机制,使代理从工作中学习并持续进化。文章还介绍了九个基准测试,验证了Alloomi在整体理解、持续进化和专业交付方面的能力,展示了其超越现有模型的性能。

技术 › Agent AlloomiAI 2026-08-1411.5 KB 170.8K 202 60

Alloomi|客户已经改到 V4,AI 还在执行 V1:Agent 需要的不只是上下文

本文通过一个广告片修改的实例,指出当前AI Agent在长期工作中的一个关键缺陷:无法区分旧要求与当前状态,导致执行过时指令。作者认为Agent的下一轮竞争不在于工具数量,而在于记忆、学习与执行三层能力。文章介绍了Alloomi的两份技术报告,分别对应Holistic Context(全域上下文)和Self-Evolving Agent(自进化智能体),并给出了多个基准测试结果,证明其在长期记忆、持续学习和真实任务交付上的优势。最终,作者强调AI应像人类同事一样,从项目经验中成长。

技术 › Agent 波妞PONYO 2026-08-147.9 KB 15.6K 67 69

Agent记忆的进阶:从记住到学会再到做得成

本文深入探讨了Agent长期记忆的复杂性,指出仅记住历史并不足够,还需处理信息过期、判断变更、反馈应用及错误回滚等问题。作者通过Alloomi的Holistic Context和Self-Evolving Agent技术报告,阐述了如何通过组织实体时间线、经验筛选与后训练,实现Agent从记忆到学习再到实际交付的进化。文章强调,真正的数字员工应具备经验迁移、状态理解和受控进化能力,并提出了三层评估框架。

技术 › Agent Yanhua 2026-08-1314.5 KB 7.4K 50 78

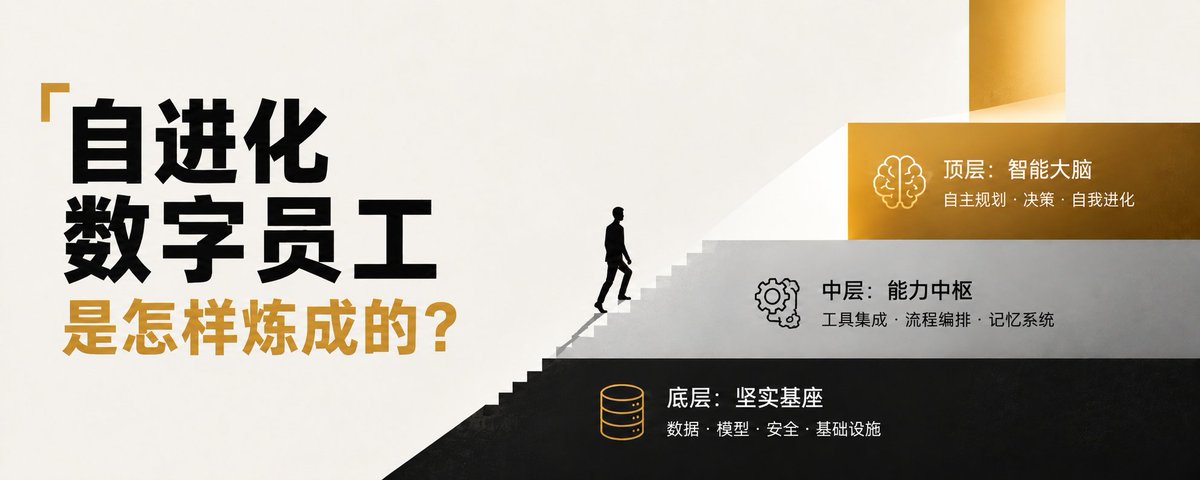
「自进化数字员工」是怎样炼成的?拆解 Alloomi 的三层技术路线

本文深入探讨了AI Agent从“记忆”到“学习”的进化路径,指出传统RAG方案在长周期业务中的局限性,并详细拆解了Alloomi提出的三层技术路线:任务层(Holistic Context)、脚手架层(MAPE控制环)和模型层(Self-Evolving Agent)。通过九项Benchmark验证,展示了该方案在长期记忆、持续学习和真实任务交付上的显著提升,提出了数字员工应具备“记得住、学得会、做得成”三类能力的观点。

技术 › Agent Lonely 2026-08-1312.0 KB 53.2K 101 73

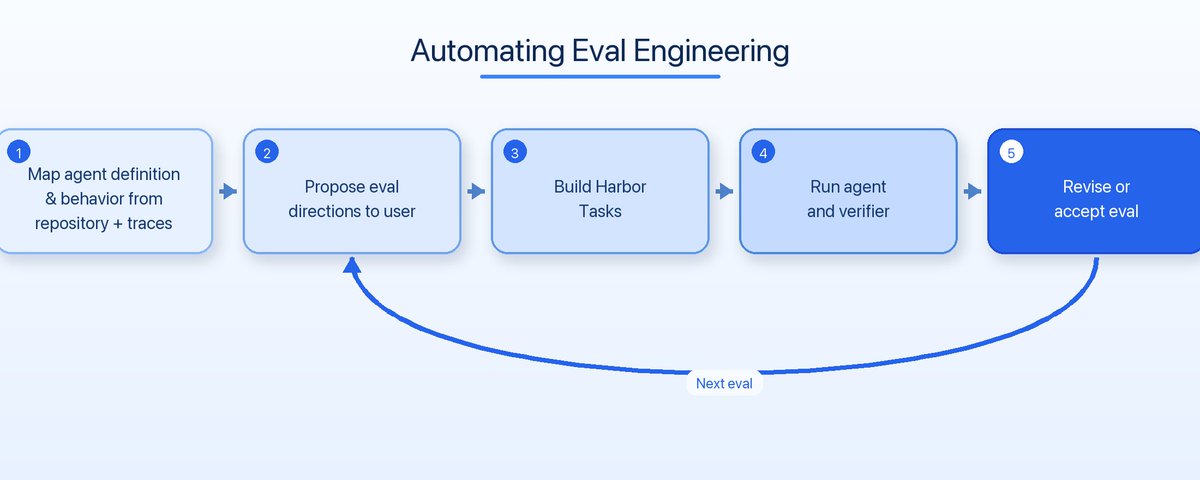
Towards Automating Eval Engineering

文章介绍了Eval Engineering Skill,这是一个帮助编码代理使用仓库上下文和代理跟踪构建评估的技能。该技能通过检查代理结构、挖掘模式并与用户交互,生成可执行的Harbor格式评估。文章还强调了迭代设计评估的重要性,以及容器化评估在持续学习中的作用。

技术 › Skill Viv 2026-07-236.9 KB 487.5K 890

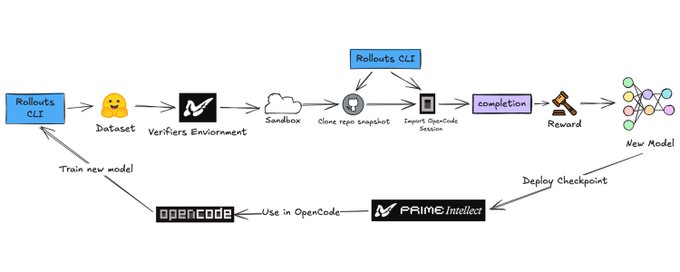
Prime Intellect 持续学习系统构建指南

本文介绍了如何利用开源生态系统构建一个持续学习的编码代理系统。作者基于 Prime Intellect 平台和 OpenCode 环境,创建了一套批量增量式在线强化学习流程,通过 Git 快照收集真实交互数据(约 21.8 亿条记录),并在沙箱环境中进行模型训练与部署,旨在实现代码生成的个性化与自我进化。

技术 › Agent Sriraam 2026-04-076.4 KB 46.5K 695 75

AI 智能体的持续学习:模型、控制层与上下文

文章探讨了 AI 智能体的持续学习机制,将其分为三个层次:模型权重的更新、Harness 控制层的优化以及 Context 上下文层的记忆与配置。作者指出,虽然大多数讨论集中在模型层的微调(如 SFT)及其带来的灾难性遗忘问题上,但工程实践中 Harness 代码和 Context 技能(如 SOUL.md)的迭代往往更为灵活高效。文章最后以 LangSmith 和 Deep Agents 为例,强调了 Trace(追踪日志)在驱动所有层级进化中的核心作用。

技术 › Agent Harrison Chase 2026-04-0515.9 KB 518.1K 1K 86