Wiki 知识库

全部文档 / 标签: Scaling Laws

4 篇
清除

AI 工程师面试:大厂反复考的 25 道通用题

文章总结了 AI 工程师面试中各科技大厂(OpenAI、Meta、DeepSeek、Anthropic 等)反复考察的高频题目,覆盖三大模块:LLM 内部原理(attention、KV cache、RoPE、MoE、scaling laws、解码策略等)、推理部署与 GPU 性能(continuous batching、PagedAttention、量化、并行策略、显存估算、延迟指标等),以及 RAG、Agent、微调、评测、安全、多模态、系统设计等方向。作者指出各家面试题高度重合,建议优先刷这些通用题以获得最高性价比。

技术 › LLM 山景城小路 2026-10-073.7 KB 21.2K 258 71

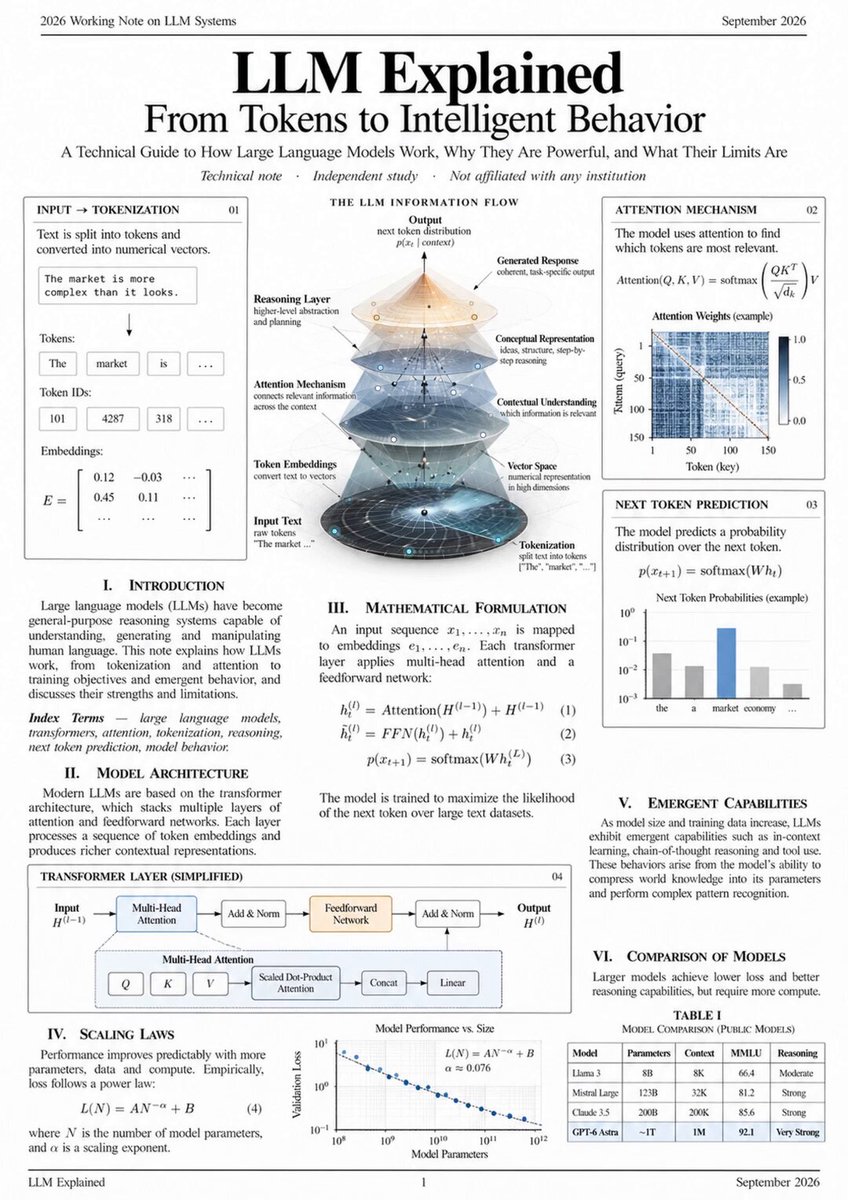
Andrej Karpathy 与 GPT 七年演进:理解 Transformer 与 LLM 架构

文章回顾 Andrej Karpathy 在 OpenAI 七年间见证 GPT 从 1.17 亿参数增长到万亿参数的历程,强调 Transformer 是近 50 年计算领域最重要的架构。内容深入浅出地讲解 LLM 内部机制:文本被切分为 token 并映射为高维嵌入向量,模型通过注意力机制(Q、K、V 矩阵)学习上下文语义;Kaplan 提出的缩放定律证明性能随参数规模可预测提升;大模型还涌现出上下文学习、思维链推理等未显式编程的能力。作者指出 LLM 不是工具而是基础设施,真正赚钱的是理解底层架构并在此基础上构建的人。

技术 › LLM Deliriumm (@0xDeliriumm) 2026-10-043.0 KB 55

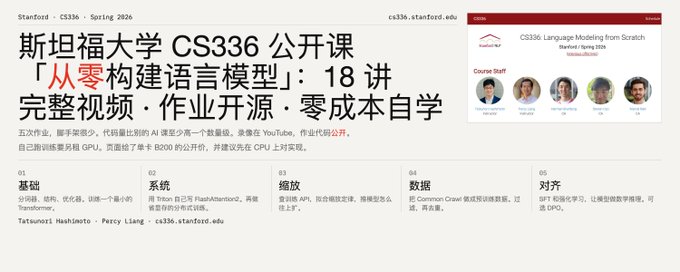
斯坦福大学 CS336 公开课「从零构建语言模型」:18 讲完整视频 · 作业开源 · 零成本自学

本文介绍斯坦福大学 2026 春季研究生课程 CS336「从零构建语言模型」。该课程由 Hashimoto 和 Liang 教授讲授,工程量极大,学生需亲手实现 tokenizer、模型、FlashAttention2 内核及分布式训练。内容覆盖 LLM 全生命周期:模型架构、系统优化(GPU/内核/并行)、Scaling Laws、数据处理、推理评估及后训练对齐(含 RLVR)。五次编程作业串起从原始数据到可对话模型的完整生产流程。目前 18 讲视频与作业已全部公开,是自学者系统补齐 LLM 工程能力的稀缺资源,但要求扎实的 PyTorch 与体系结构基础。

技术 › LLM meng shao 2026-09-247.2 KB 15.5K 194 81

Anthropic CEO Dario Amodei 访谈:我们正在接近指数的终点

Anthropic CEO Dario Amodei 在 Dwarkesh Podcast 的访谈中,深入探讨了 AI 扩展定律(Scaling Laws)的延续、强化学习的规模化以及“天才之国”(Country of Geniuses)的预测时间表。对话涵盖了 AI 编程工具带来的实际生产力提升(当前 15-20%)、AI 公司的商业盈利模型(算力供需平衡),以及与 OpenAI 在 Stargate 项目上截然不同的风险策略。

技术 › LLM 宝玉 2026-02-1532.2 KB 516.1K 1.1K 71