# AI for Physics 全景图
**作者**: snowboat
**日期**: 2026-08-08T04:31:15.000Z
**来源**: [https://x.com/snowboat84/status/2085946919277461512](https://x.com/snowboat84/status/2085946919277461512)
---
过去两三年,随手翻一翻物理领域的新闻,会看到两个很不一样的AI世界。
一个世界里,AI已经走进了物理学的生产线。
材料科学里,机器学习势函数正在改变分子模拟的工作方式。过去,人们常被夹在两头:第一性原理计算足够精确,只能处理几十个原子。经验势场能模拟更大的体系,可靠性又经常不够。现在,神经网络开始填中间这块空地。
天文学和引力波领域也有类似变化。过去需要几小时甚至几天的参数估计,现在能压到几秒钟。高能物理实验中,从触发系统、探测器模拟到事例重建,神经网络已经进了日常流程。
如果只看这些成果,很容易得出一个判断:AI正在改写现代物理学的工作方式。
另一个世界就冷得多。
十年来,从SINDy到AI Feynman,再到PySR,研究者一直希望让机器直接从数据中发现物理规律。结果不是零:机器重新发现了开普勒第三定律,重新推导了朗道理论,也能从数据中自动识别守恒量。尴尬的地方在于,这些结果几乎都是人类早就知道的东西。
到今天,我们仍然很难举出一个被学界广泛接受、由AI独立构造出来的新理论。无论是凝聚态物理、高能物理还是宇宙学,这样的例子都少到几乎看不见。
为什么会这样?
同样的技术,同样的十年,为什么有些方向进展很快,另一些方向却一直卡住?
我读博士时做的是数值模拟和统计推断,后来转到工业界做AI产品。这几年我越来越觉得,这种差异不是偶然。物理学内部本来就有两类很不一样的问题。
有一类问题,核心瓶颈是计算:状态空间太大,方程太复杂,模拟太昂贵。过去,物理学家只能靠各种近似和经验方法往前走。AI恰好擅长处理这种高维、复杂、难以穷举的计算任务。
还有另一类问题,困难不在算力,而在概念本身。新的理论框架从哪里来?哪些变量才是真正重要的自由度?哪些规律只是表象,哪些规律才是底层结构?这些问题即使有无限算力,也未必会自动冒出答案。
AI在第一类问题上已经很成功,在第二类问题上仍然几乎是一片空白。
这篇文章讨论的,就是这两类困难之间的分界线:AI到底改变了物理学的什么,又还没碰到什么。
# 一、已有的地图,和这张地图的画法
## 1.1 七份现成的综述,各按什么切
关于AI for Physics的综述,这几年已经出了不少。它们讨论的问题相近,但组织材料的方式并不相同。把几篇最有代表性的文章放在一起看,可以很清楚地看到这个领域是如何理解自己的。
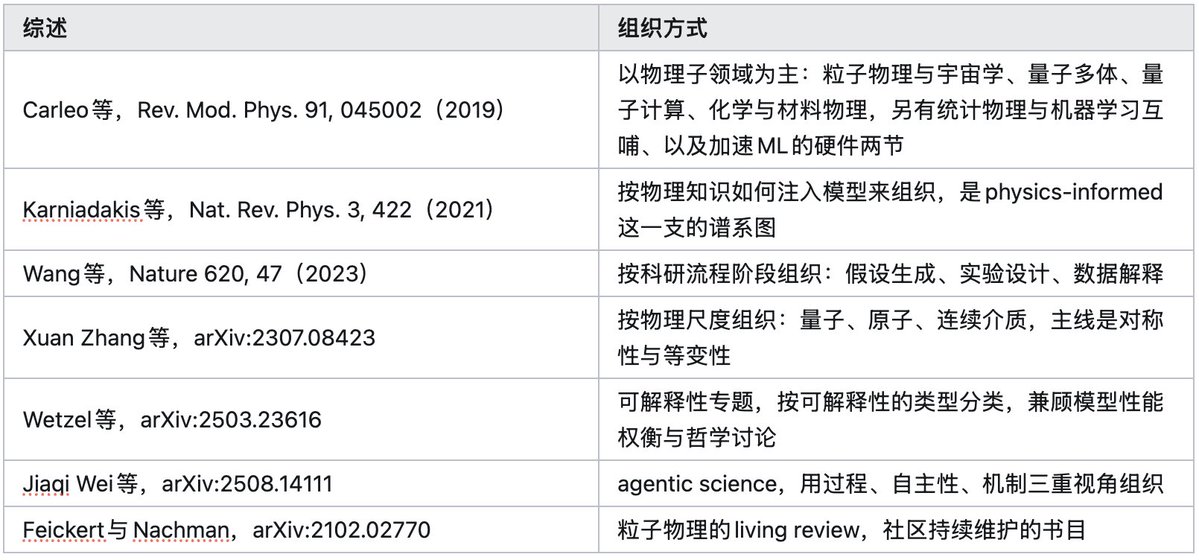
这些综述各有各的价值。Carleo那篇到今天仍然是最经典的物理视角综述,而Feickert和Nachman的living review,则几乎已经成为粒子物理方向查找文献的标准入口。
不过,尽管组织方式不同,它们有一个共同特点:分类的出发点都是研究成果本身。
有的按照学科领域划分,有的按照科研流程划分,有的按照研究对象所在的尺度划分。这样的框架非常适合整理已有文献,但它们并不能回答一个更基础的问题:为什么AI在某些物理问题上进展迅速,而在另一些问题上却长期停滞?
同样是粒子物理,AI已经深度参与了触发系统、探测器模拟和事例重建,但在利用实验数据寻找超出标准模型的新理论方面,贡献依然有限。凝聚态物理也是类似的情况:机器学习势函数已经改变了日常研究方式,而自动构造新的有效理论却几乎没有突破。
同一个学科内部的差异,往往比不同学科之间的差异还要大。仅仅按照研究对象来分类,很难解释这种现象。
## 1.2 从物理学家的工作方式重新组织
本文采用的是另一种视角。
在讨论AI之前,我们先暂时把机器学习放在一边,回到一个更基本的问题:物理学家究竟是怎样做研究的?
物理学并不是一条单一的流水线。从建立基本方程开始,它大致会沿着几条不同的路线展开:解析求解、数值模拟、定性分析、有效理论构造,以及实验与观测。
每一条路线都有自己的目标、自己的工具,也面临着完全不同的困难。
为了后文讨论方便,本文把它们分别记作:
- A:解析求解(Analytical Solution)
- B:数值模拟(Numerical Simulation)
- C:定性分析(Qualitative Analysis)
- D:有效理论构造(Effective Theory)
- E:实验、观测与统计推断(Experiment and Inference)
第二章会逐一讨论这五条路线究竟在解决什么问题。
先来看几个简单的例子。
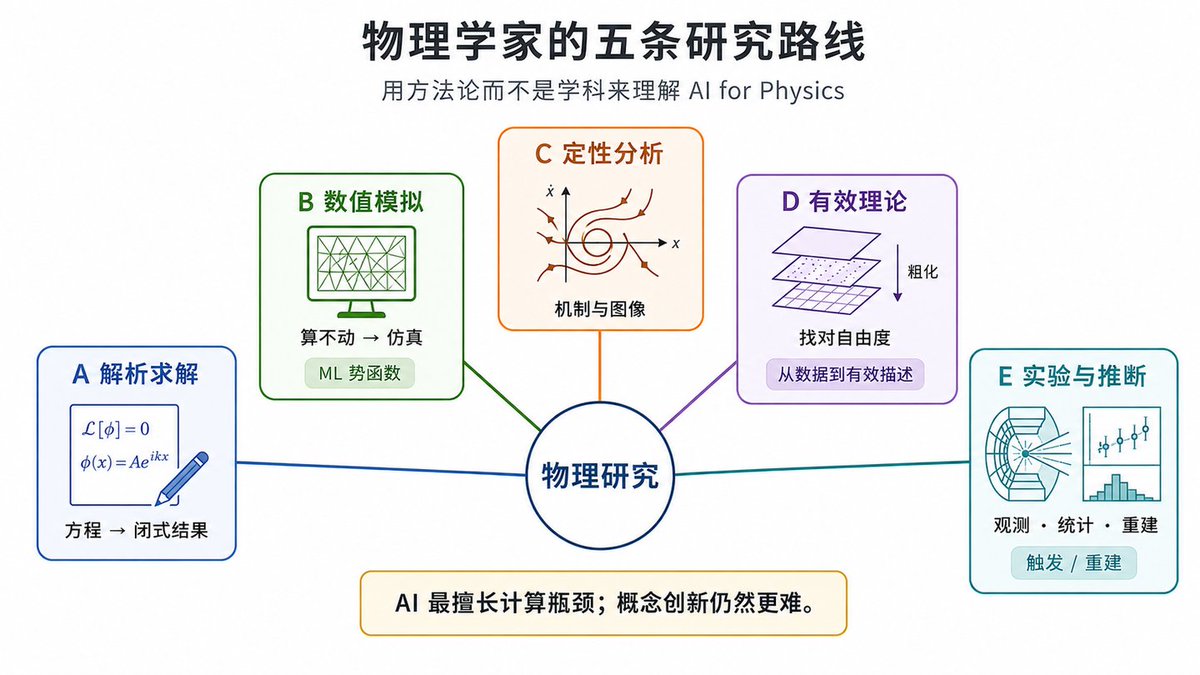
粒子物理中的触发系统和事例重建,本质上属于路线E(实验与推断),它们面对的是海量数据处理和统计推断的问题,因此非常适合机器学习。材料模拟中的机器学习势函数,则属于路线B(数值模拟),它解决的是高维方程无法直接求解的问题。
然而,从实验数据中建立新的有效理论,则属于路线D(有效理论)。这里真正困难的地方在于找到正确的自由度、正确的描述语言,以及隐藏在现象背后的结构。
这几类问题虽然都属于物理学,但它们所面对的障碍完全不同。如果按照学科划分,这种差异很难解释。换成物理学的方法论视角,情况就清楚得多:AI最成功的地方,往往是那些长期受限于计算能力的问题。那些真正依赖概念创新和理论构造的领域,AI至今仍然进展有限。
因此,本文不打算用这套框架替代现有综述。它只回答一个更具体的问题:
面对一项AI for Physics的工作,我们究竟应该如何判断,它改变的是物理学的哪一部分,以及它到底解决了什么困难。
## 1.3 三个标签
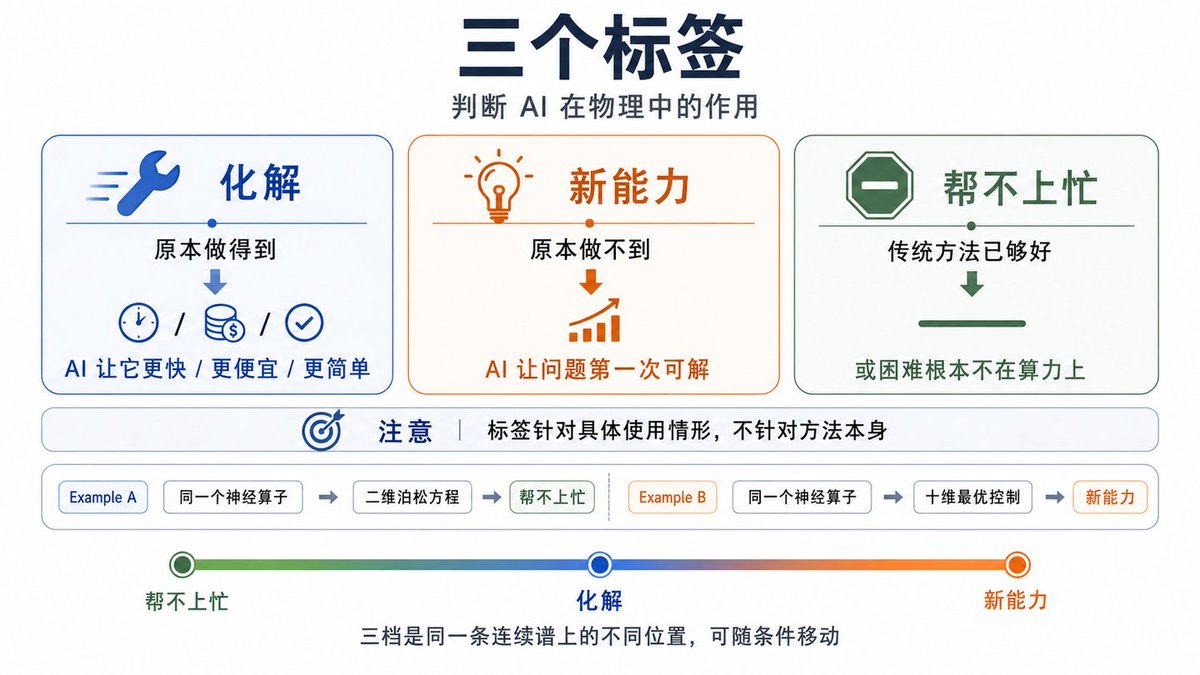
全文会反复用到三个判断标签,先把定义摆出来。
化解:物理学家原本做得到,只是很麻烦、很贵、很慢。AI让它变简洁。这一档的价值是真实的,但它不改变任何物理结论,只改变做这件事的成本。
新能力:物理学家原本做不到。AI让它成为可能。这一档少得多,含金量高得多。判断标准很硬:如果这项工作让某个此前算不出来的量算出来了,或者让某个此前没法回答的问题有了答案,才算。
帮不上忙:传统方法本来就够好,或者困难根本不在算力上。这一档在文献里的比例远超一般人的印象,而且很多时候是被基准设置掩盖掉的。
这三个标签的用法有一个容易搞错的地方:判定要针对具体的使用情形,不针对方法本身。同一个神经算子,用在二维泊松方程上是帮不上忙,用在十维的最优控制方程上是新能力。第四章那张四格表就是这件事最具体的一次落地。
还有一条实操上的提醒。论文自己给出的定位不能直接采信。一篇工作宣称自己解锁了新能力,要看它对照的传统方法有没有被削弱过。一篇工作只报自己快了多少倍,通常对应的是化解那一档,价值真实但要按化解估值。
这三档标记的是同一条连续谱上的三个位置,彼此之间可以移动。第四章会说明化解怎么在特定条件下外溢成新能力。
# 二、物理学家实际是怎么做研究的
## 2.1 关键的方程从哪里来
物理学有一个很少明说的偏好:一个现象要算被"理解"了,通常要先有一个方程。
这条线索从牛顿开始。1687年的《自然哲学的数学原理》把力学压进一行:
这两行足够把苹果落地、月球绕地球、行星绕太阳放进同一个框架。但麻烦几乎立刻出现:两个天体的问题可以精确解,三个天体一放进来,就没有一般闭合解析解。万有引力三体问题是第一个重大提醒:方程写出来了,不等于世界就被算完了。
之后一百多年里,欧拉、拉格朗日、哈密顿把牛顿力学一层层改写。拉格朗日1788年的《分析力学》把问题改写成变分原理:
这里的L=T-V叫拉格朗日量,q_i是广义坐标。它的好处在于不用盯着每一个力怎么分解,只要写出能量差,运动方程自己出来。后来整个场论都沿着这条路走:先写拉格朗日量,再从变分推出方程。
哈密顿1834年又把力学写成相空间里的一阶方程组:
这里的H是哈密顿量,通常对应总能量。物理内容没变,但方程的形态更适合分析守恒量、相空间结构和量子化。后面路线A的解析求解、路线C的定性分析,都离不开这套写法。
流体力学是这条线上的第二个警告。Navier在1822年、Stokes在1845年先后写出了描述黏性流体的方程。不可压缩情形下,它通常写成:
这里\mathbf{u}是速度场,p是压强,\rho是密度,\nu是运动黏度。形式不长,物理意义也清楚。两百年过去,这个方程在三维情形下解的存在性与光滑性仍然没有答案,是克雷数学研究所七个千禧年问题之一,悬赏一百万美元。方程写得漂亮,跟方程能不能解,是两件事。
量子力学继续强化了这种偏好。海森堡1925年的矩阵力学在物理上是完整的,但它把可观测量写成无穷维矩阵,运算规则离物理学家熟悉的微分方程很远。薛定谔1926年的波动方程一出现,共同体几乎立刻倒向后者:
教科书至今按薛定谔的路子教。原因除了历史偶然,也在于这条方程把量子态如何随时间演化写得太清楚。1928年狄拉克方程接上,把相对论和自旋一起装了进去。
广义相对论继续走同一条路。爱因斯坦1915年给出场方程:
左边是时空几何,右边是物质和能量。一年后,史瓦西找到了第一个精确解。到今天,爱因斯坦方程的精确解也主要出现在高度对称的情形里。真实的双黑洞并合要靠数值相对论硬算,2005年才第一次算通。
到粒子物理的标准模型,做法仍然是先写一个拉格朗日量,再从中导出运动方程。完整展开会很长,压缩写法大概是:
这行东西把规范场、费米子、希格斯场、相互作用和质量来源都塞进去了。半个世纪的高能物理实验,本质上是在检验这一个拉格朗日量。
这条线索走下来,可以看到一个稳定的偏好:物理共同体倾向于把"我们理解了"等同于"我们有一个方程"。这个偏好背后是还原主义的信念,有了基本方程就有了一切,剩下的都是技术细节。这个信念在讲有效理论构造那一节会撞上一堵墙,现在先记住它。
## 2.2 路线A:解析求解
有了方程,第一条路线是直接把它解出来。
最干净的例子还是牛顿二体问题。两个质量m_1,m_2在万有引力下运动,可以化成一个约化质量\mu=m_1m_2/(m_1+m_2)在中心势里运动:
这个方程真能解。轨道是圆锥曲线,可以写成:
e<1是椭圆,e=1是抛物线,e>1是双曲线。开普勒三定律可以从这组方程里算出来,不需要额外假设。这就是解析解最有用的地方:一个表达式里直接装着轨道形状、周期、能量和角动量。
三体问题一上来,局面就变了。三个质点仍然只服从牛顿方程:
方程仍然短,物理也没有换。但一般三体问题没有二体那样的闭合解析解。你可以在特殊构型下找到拉格朗日点、欧拉共线解,也可以用数值积分追踪具体轨道,却没有一个像r(\theta)=p/(1+e\cos\theta)那样把一般解写完的公式。这里第一次看清路线A(解析求解)的边界:方程明确,不等于解析求解可行。
量子力学里也是同一个结构。薛定谔方程本身当然能写出来:
i\hbar\frac{\partial}{\partial t}\Psi=\hat H\Psi
但它有没有解析解,完全取决于哈密顿量\hat H长什么样。一维无限深方势阱可以解,能级是:
E_n=\frac{n^2\pi^2\hbar^2}{2mL^2}
量子谐振子也可以解,能级是:
E_n=\hbar\omega\left(n+\frac{1}{2}\right)
氢原子更重要。库仑势V(r)=-e^2/(4\pi\epsilon_0r)下,薛定谔方程可以分离变量,能级写成:
E_n=-\frac{13.6\ \mathrm{eV}}{n^2}
这些模型构成了量子力学课本的骨架。但它们可解,靠的是高度对称:一维边界、二次势、中心势。一旦你把氢原子换成氦原子,多一个电子,多一个电子-电子相互作用项,闭合解析解就没了。真实分子和真实固体更不用说。
解析求解的第二层是微扰。它处理的是这种情况:我解不了真正的哈密顿量H,但它离一个可解的H_0不远。于是写成:
H=H_0+\lambda V
然后把能量和波函数也展开成级数:
E_n=E_n^{(0)}+\lambda E_n^{(1)}+\lambda^2E_n^{(2)}+\cdots
一阶能量修正是:
E_n^{(1)}=\langle n^{(0)}|V|n^{(0)}\rangle
这算解析解吗?要分清楚。微扰不是精确闭合解,它是解析形式的近似解。每一阶都是公式,能告诉你小参数\lambda怎么影响结果,所以它仍然属于路线A(解析求解)。但只要你截断到有限阶,它就是近似。更麻烦的是,很多物理里的微扰级数根本不收敛,只是渐近展开:前几阶越来越准,后面反而发散。
微扰论在天文学里有过一次教科书级的胜利。1846年,勒维耶从天王星轨道的摄动反推出一颗未知行星的位置,柏林天文台当晚就在预测位置一度以内找到了海王星。同一套方法算水星近日点进动时留下了每世纪43角秒的残差,这个残差一直挂到1915年,被广义相对论一次算平。
量子电动力学把微扰推到了另一个极端。电子反常磁矩可以写成精细结构常数\alpha的级数:
算到第五阶时,要处理12672个费曼图。最后理论与实验在小数点后十位以上仍然吻合,这是全部物理学里最精确的一次对照。可它也说明了另一件事:路线A(解析求解)不是只靠灵感写漂亮公式,高阶解析计算本身会变成重体力活。
变分法是第三种常用打法。它先猜一个带参数的试探波函数\psi_\theta,再最小化能量期望值:
因为这个能量一定不低于真实基态能量,变分法自带一个质量指标:算出来的能量越低越好。整个量子化学行业很大一部分都建立在这套思路上。
这里要留个话头。变分法真正属于路线A(解析求解)的,是猜一个函数形式这一步。至于算出这个形式下的能量,简单情形能纸笔积分,复杂情形只能靠蒙特卡洛,那就已经跨到路线B去了。第四章的神经量子态换掉的是前半步,交出来的却是后半步的产物,一个数字。
所以路线A(解析求解)的成功标准很清楚:拿到一个闭合表达式,或者拿到一个可以逐阶算下去的解析展开。表达式本身就是理解,因为你能从里面读出各个参数怎么起作用。
问题也很清楚。精确可解的模型是少数,三体问题已经把经典力学拦住,多电子问题又把量子力学拦住。微扰展开在弱耦合区很好用,一到强耦合区就可能发散。物理学家对这一点心里非常清楚。
## 2.3 路线B:数值模拟
解不出来就算。这条路线吃到了过去七十年计算能力增长的最大红利。
数值模拟的基本想法很朴素:把连续问题变成有限个数的代数问题。微分方程里有\partial u/\partial t和\partial u/\partial x,计算机不认识这些东西。计算机认识的是网格点上的数值,所以第一步是离散化:
这一步看上去像工程技巧,实际上是一整套数学理论的入口。最早的关键工作之一就是Courant、Friedrichs和Lewy在1928年的论文。他们研究的是差分方程什么时候真的逼近原来的偏微分方程,后来留下了CFL条件。对最简单的一维平流方程
\frac{\partial u}{\partial t}+a\frac{\partial u}{\partial x}=0
一个显式差分格式要稳定,时间步长不能随便取,大致要满足:
|a|\frac{\Delta t}{\Delta x}\leq 1
这句话的物理意思很直接:一个时间步里,真实波传播的信息不能跑出数值格式看得见的网格范围。计算机如果看不到该看的信息,误差就会炸掉。数值模拟从一开始就不是“把方程丢给机器算”,它先要回答稳定性、收敛性、误差估计这些问题。
CFD,也就是计算流体力学,是数值模拟长出完整理论的主战场。流体方程最常见的写法是守恒律:
\frac{\partial U}{\partial t}+\nabla\cdot F(U)=S
U里装的是质量、动量、能量,F(U)是通量,S是源项。有限体积法的思想是把空间切成一个个小控制体,只要求每个小格子里的守恒量怎么变:
U_i^{n+1}=U_i^n-\frac{\Delta t}{\Delta x} \left(F_{i+1/2}-F_{i-1/2}\right)
这里真正难的是格子边界上的通量F_{i+1/2}怎么算。因为压缩流里会有激波,解可以不连续,普通中心差分会在激波附近振荡。Riemann solver就是为这件事服务的:把每个格子边界看成一个局部Riemann问题,左边一个状态U_L,右边一个状态U_R,问中间会长出什么波,再用这个局部解决定通量。
一维Euler方程的守恒变量和通量可以写成:
现代CFD的主线大致沿着这里展开。Courant他们先把差分方程的稳定性问题立起来。von Neumann和Richtmyer在1950年前后用人工黏性处理流体激波。Godunov在1959年把守恒律、激波和Riemann问题接到一个数值格式里。后面Lax-Wendroff、Roe、van Leer、TVD、ENO、WENO一路发展,才有了现代CFD里那套“守恒、稳定、不过度振荡、尽量高阶”的方法论。
CFD之外,数值模拟还有几条大支线。有限元把连续介质切成网格,在每个单元里用简单函数近似解,最后拼成一个大型线性或非线性方程组:
K u=f
这里K是刚度矩阵,u是未知位移、温度或场变量,f是载荷或源项。桥梁、飞机机翼、芯片热场,很多工程仿真都靠这套东西。谱方法则把解展开到一组基函数上,比如傅里叶模:
u(x,t)=\sum_k \hat u_k(t)e^{ikx}
如果问题足够光滑,谱方法的收敛速度非常快。它的问题也很清楚:几何复杂、边界复杂、出现激波时,漂亮的全局展开就不再省心。
另一类方法直接模拟大量微观自由度。分子动力学把每个原子的牛顿方程一步步推进:
m_i\ddot{\mathbf r}_i=-\nabla_i V(\mathbf r_1,\ldots,\mathbf r_N)
蒙特卡洛方法1940年代在Los Alamos成形,核心是用随机采样估计高维积分:
\langle A\rangle \approx \frac{1}{M}\sum_{m=1}^M A(x_m)
今天从格点量子色动力学到统计物理、从金融衍生品定价到贝叶斯推断,都在用这一类思想。N体引力模拟则把星系、暗物质粒子或恒星团当成许多相互作用的粒子,从几百个粒子一路做到上万亿个粒子,宇宙学的大尺度结构就是这么算出来的。
这条路线出过一些很硬的成果。2008年,Zoltán Fodor领导的布达佩斯-马赛-乌珀塔尔合作组在《科学》上发表格点量子色动力学结果,从夸克和胶子的基本理论出发算出质子、中子等轻强子的质量,跟实验值符合到百分之几。这件事的分量在于,强相互作用的低能区没法用微扰论,格点数值模拟是唯一能把标准模型这一部分算通的手段。
宇宙学这一侧,从2005年Volker Springel等人那个用了约一百亿个粒子的Millennium模拟,到后来的IllustrisTNG,规模涨到上千亿粒子并加进了气体和恒星形成。今天比较宇宙学模型和星系巡天数据,中间必然要经过一次大规模模拟,模拟本身已经是理论的一部分。
所以路线B(数值模拟)不是“解析解失败以后把问题交给电脑”。它有自己的硬标准:守恒量不能凭空丢,网格加密之后结果要收敛,时间推进要稳定,误差要能估计,激波附近不能乱振荡,边界条件不能偷偷改变物理问题。
它不给你一个闭合表达式,给你的是一组数字、一张图、一条收敛曲线。路线A(解析求解)追求的是“我能写出解”。路线B(数值模拟)追求的是“我知道这个数字在什么误差范围内可信”。
## 2.4 路线C:定性分析
第三条路线在国内的物理教育里讲得偏少,但它是一个独立传统。
庞加莱在1880年代做的是三体问题。他很清楚这个方程写不出通解,于是换了个问法:不去求解,直接问解在相空间里长什么样。1881年他在《数学纯粹与应用杂志》上发表《论由微分方程定义的曲线》的第一部分,这篇一直写到1886年的长文开创了微分方程的定性理论。
起点是不动点。给一个自治系统\dot{\mathbf x}=\mathbf f(\mathbf x),先找出\mathbf f(\mathbf x^*)=0的点,再把方程在附近展开到一阶:
雅可比矩阵J的本征值就决定了局部图像。二维情形下用迹\tau=\mathrm{tr}\,J和行列式\Delta=\det J就能分完类:\Delta<0是鞍点,\Delta>0且\tau^2>4\Delta是结点,\tau^2<4\Delta是焦点,\tau=0是中心。整套分类不解方程,只算一个矩阵的本征值,而Hartman-Grobman定理保证了在双曲不动点附近,线性化画出的相图跟真实相图之间只差一个连续形变。
高一级的结构是极限环,也就是孤立的周期轨道。van der Pol在1920年代研究真空管振荡电路时写下的方程是标准例子:
\ddot x-\mu(1-x^2)\dot x+x=0
\mu>0时它有且只有一个稳定极限环。你写不出这条闭轨的表达式,但你能证明它存在、唯一、并且吸引周围所有轨道。
庞加莱和Bendixson给出的定理更强:平面上一个有界不变区域里如果没有不动点,那么任何轨道的极限集必定是一条闭轨。推论是二维连续自治系统里做不出混沌,轨道困在平面上,既不能自交又跑不出去,能做的只有趋于不动点或者绕上极限环。混沌需要至少三维,而这个结论完全来自相空间的拓扑,跟方程长什么样无关。
洛伦兹1963年从对流问题里截出的三个方程正好是三维的样本:
取\sigma=10、\beta=8/3、\rho=28,轨道落在一个分形吸引子上,既不重复也不发散。这种解怎么刻画?不写轨道,写不变量。李雅普诺夫指数量的是相邻轨道分离得多快:
洛伦兹吸引子的最大李雅普诺夫指数约0.906,Kaplan-Yorke维数约2.06。这两个数不属于任何一条轨道,属于吸引子整体。1/\lambda_1给出可预报期的量级,今天的集合预报设计就建立在这套理解上:你算不出两周后的具体天气,但你能算出可预报期有多长。
同一条路线上还有几样东西,形式不像相图,问的却是同一类问题。诺特1918年的定理把作用量的连续对称性和守恒量对应起来,时间平移给出能量守恒,转动给出角动量守恒。量纲分析给出标度律。哈密顿系统里的KAM定理说小扰动下绝大多数不变环面会保留下来,相空间不会被搅成一锅粥,太阳系稳定性的长期数值工作就建在这套框架上。
拓扑不变量是这一族里实验精度最高的一个。整数量子霍尔效应的电导写成\sigma_{xy}=(e^2/h)\,C_1,Thouless、Kohmoto、Nightingale和den Nijs在1982年证明陈数C_1必须取整数。整数没有连续变化的余地,所以电导平台的量子化精度能做到十亿分之一量级。这是一个不解薛定谔方程就能断言、而且真被实验验证到这个精度的结果。
可积性理论是这一族里的最后一支。Lax在1968年指出,如果一个非线性方程能写成dL/dt=[M,L],那么算符L的本征值全部是运动常数,于是有无穷多个守恒量。KdV方程正好是这种情况,1967年被逆散射变换完全解出,它的孤立子解今天用在光纤通信里。
路线C(定性分析)的输入输出很有特点:输入一个方程,输出关于同一个方程的解的结构性陈述。方程没换,只是不再要求写出解。
这条路线的成功标准跟前两条也不一样。路线A(解析求解)要的是我能写出解,路线B(数值模拟)要的是我知道这个数字在什么误差范围内可信,路线C(定性分析)要的是我能说清这一整族解长什么样,而且这个陈述不依赖任何一条具体轨道。
代价同样明确。这类结论几乎全部要靠人看出来:哪个量是守恒量,哪个坐标能把方程线性化,哪个拓扑不变量是对的,都没有算法可循。第三章会回到这一点。
## 2.5 路线D:有效理论构造
第四条路线跟前三条都不一样,也是这篇文章的重心所在。
原则上,凝聚态物理的一切都装在这一个哈密顿量里:
电子的动能、电子和离子的吸引、电子之间的排斥,再没有别的了。狄拉克1929年说物理一大部分和全部化学的基本定律已经完全知道,指的就是这个式子。
问题是你从这里看不出超导,看不出超流,看不出分数电荷。这些现象要10^{23}个粒子一起出现才存在,而写下H的人对它们一无所知。
凝聚态最有用的那些方程,都不是从上面这个H推出来的。金兹堡和朗道1950年处理超导时,直接猜了一个自由能:
\psi叫序参量,在1950年它没有任何微观含义,就是一个描述超导程度的复数场。取\alpha=\alpha_0(T-T_c),在T<T_c时极小化给出|\psi|^2=-\alpha/\beta,超导态自动出现。
这个猜出来的自由能能干什么?它给出两个长度,相干长度\xi和穿透深度\lambda。Abrikosov在1957年从中算出,当\kappa=\lambda/\xi>1/\sqrt2时磁场会以量子化涡旋的形式钻进超导体,排成规则格子。这个预言后来被小角中子散射和磁修饰实验证实,Abrikosov在2003年拿了诺奖。一个没有微观根据的唯象方程,预言出了一个全新的物态。
BCS要到1957年才给出微观图像。他们下笔的对象仍然经过了大幅简化,只保留配对散射这一项:
解出来的能隙是
\Delta\approx2\hbar\omega_D\,e^{-1/N(0)V}
这个结果有一个要命的性质。函数e^{-1/x}在x=0处所有阶导数都是零,所以无论你把微扰论对耦合V做到多少阶,算出的能隙都严格为零。超导在微扰展开里根本不存在,只有换一套自由度重新写方程才能看见。路线A(解析求解)再强也走不到这里。
朗道1956到1958年的费米液体理论走的是第三条路子。他不写新的哈密顿量,直接断言相互作用系统的低能激发跟自由费米气的激发一一对应,只是参数变了。能量泛函写成
\delta n是准粒子的占据数变化,f是准粒子之间的相互作用。这个断言可以直接验证:比热应该仍然正比于温度,只是斜率对应有效质量m^*而不是裸质量。液氦3的比热确实线性于温度,测出的m^*是裸质量的几倍,并且随压强单调增大。框架由理论给出,参数由实验定。
哈伯德1963年的模型更极端,把固体里的一切压成两项:
H=-t\sum_{\langle ij\rangle\sigma}\left(c^\dagger_{i\sigma}c_{j\sigma}+\mathrm{h.c.}\right) +U\sum_in_{i\uparrow}n_{i\downarrow}
一个跳跃项,一个在位排斥项。10^{23}个自由度换成了t和U两个参数。
换自由度这一步是发明。库珀对不是电子,朗道费米液体里的准粒子不是原子,分数量子霍尔态里的任意子不对应任何微观粒子。1982年崔琦和施特默看到分数量子霍尔效应,1983年劳克林写下那个试探波函数,其中的元激发带三分之一个电子电荷。这个东西在H里找不到,而1997年Saminadayar和de-Picciotto两个组用散粒噪声实验把e/3直接测了出来。
安德森1972年在《科学》上那篇《More is Different》讲的正是这件事。知道基本定律,并不等于你能重建现象。每上升一个层次都需要一套新概念,而这套概念不能从下一层机械地推出来。
重整化群归在这条路线里,不归在路线C(定性分析)。威尔逊1971年的工作是这条路线的方法论核心,作用是告诉你在给定能标下该写哪个有效方程、哪些项相关、哪些项可以扔掉。他1982年拿诺奖,靠的就是把"该写哪个方程"变成了一套可操作的程序。
这条路线的输入输出是:输入微观方程加实验现象,输出另一个方程。方程换了,自由度也换了。
成功标准跟着一起换了:这个新方程能不能解释一批现象、预言出新现象、并且被实验接住。金兹堡-朗道方程活了下来,因为Abrikosov从里面读出了涡旋格子,而实验真的看到了。
到这里可以回收2.1节那个还原主义的信念。有了基本方程就有了一切,这个说法在路线D(有效理论)面前站不住。凝聚态的中心任务是理解现象,而理解现象需要的那个方程,跟基本方程不在同一层上。
## 2.6 路线E:实验、观测与推断
第五条路线是实验。我把它列成独立路线而不是"回路",因为它有自己完整的方法论和自己的卡点。
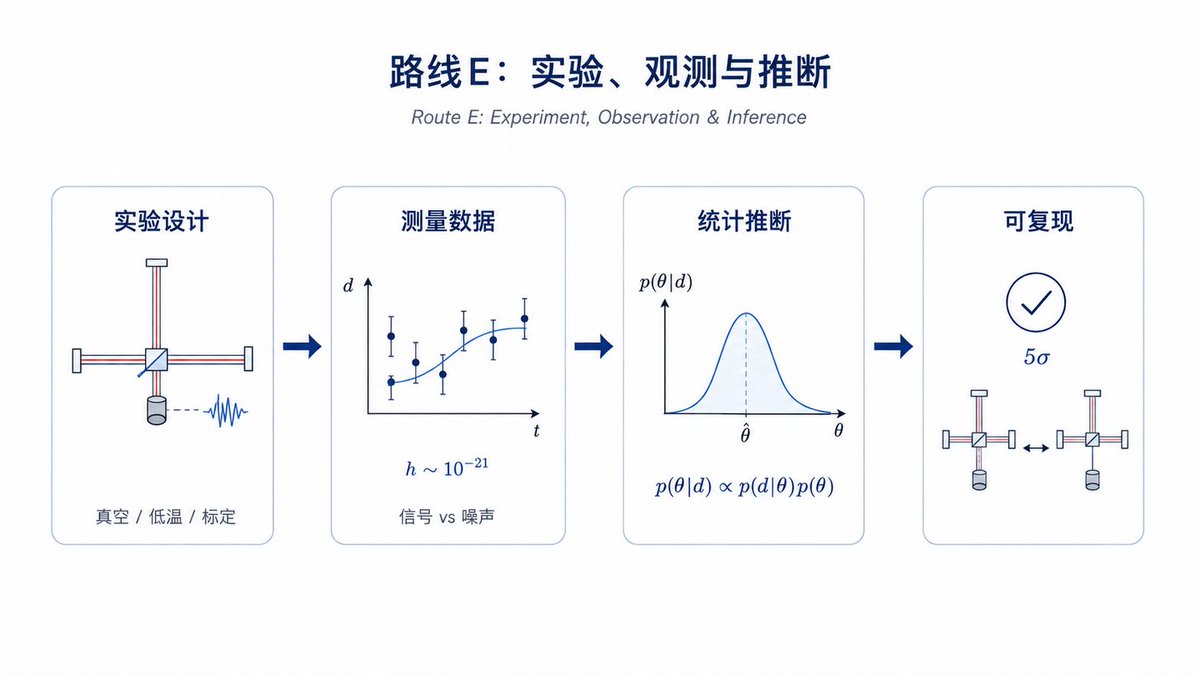
实验设计与控制是一套独立的学问。真空、低温、屏蔽、标定,这些东西决定了你能不能测到那个信号。LIGO测的是一个无量纲的应变
h=\frac{\Delta L}{L}\sim10^{-21}
四公里的臂长对应\Delta L\approx4\times10^{-18}米,大约是质子直径的几百分之一。把这个数从地震、热噪声和激光散粒噪声里挖出来,靠的是四十年的隔振与降噪工程。
数据到手之后是推断。这一层的骨架是贝叶斯公式:
\theta是你想知道的物理参数,d是实测数据,p(d|\theta)是似然。第三章会说明,这条路线最深的卡点就藏在似然这一项里。
实验能做多准,有一个理论下界。Fisher信息定义为
Cramér-Rao不等式说任何无偏估计的方差都不小于1/I(\theta)。实验设计这件事的数学内容,很大程度上就是在给定预算下把Fisher信息做大:该测哪个区间,该积多长时间,该用什么构型。
假设检验是另一半。粒子物理里五个标准差那个门槛,对应的是随机涨落造成假信号的概率约三百五十万分之一。这个数字不从任何物理方程里推出来,它是这个共同体被历史上多次三个标准差的假信号坑过之后定下的规矩。2012年宣布发现希格斯粒子,本质上是两个实验组各自算出的局部显著性都越过了这条线。
还有一个细节叫look-elsewhere effect:在一大段区间里到处找峰,比事先指定一个位置更容易撞上涨落。粒子物理报数时必须同时给局部显著性和全局显著性,就是为了扣掉这一层。这类问题在路线A到D里根本不出现。
推断的结果反过来修正方程。中微子从\nu_\mu变成\nu_\tau的概率是
P(\nu_\mu\to\nu_\tau)=\sin^22\theta\,\sin^2\!\left(\frac{\Delta m^2L}{4E}\right)
只要振荡真的发生,\Delta m^2就不为零,中微子就必须有质量。超级神冈1998年测出大气中微子随L/E的振荡模式,SNO在2001年补上太阳中微子这一侧的证据,标准模型里中微子无质量那一条被实验直接推翻。
还有一层方法论是前四条路线完全没有的:防止研究者自己作弊。误差分成统计误差和系统误差两块,前者靠攒数据压下去,后者靠标定和交叉检验,而且往往是后者主导。一旦系统误差主导,再攒数据也不会让结果变准。
对付研究者偏见的标准手段是盲分析:先把真值藏起来,等整套分析流程冻结之后再解盲。费米实验室的缪子反常磁矩实验做得很彻底,两名合作组之外的员工把40MHz的数字化时钟调偏到一个保密频率上,整套进动分析在时间未校准的数据上完成,直到2021年所有系统误差评估结束、决定发表之后才解盲。这一步跟物理内容毫无关系,跟结论可不可信关系极大。
这条路线还有一个特点:产出周期跟其它四条完全不在一个量级。LIGO从1980年代提出到2015年第一次探测到引力波,中间三十年。希格斯粒子从1964年被预言到2012年被找到,四十八年。这段时间里理论那一侧可以换好几拨人,实验这一侧必须有人一直守着。
这条路线的成功标准是可复现:在同一套系统误差分析下,另一个组用另一台仪器要能测出同一个数。路线A到D争的是推导对不对,路线E(实验与推断)争的是这个数可不可信。
# 三、五条路线各自卡在哪里
## 3.1 两个层次,两种近似
要判断AI能不能帮上忙,首先得把物理学里“卡住”这件事拆开来看。
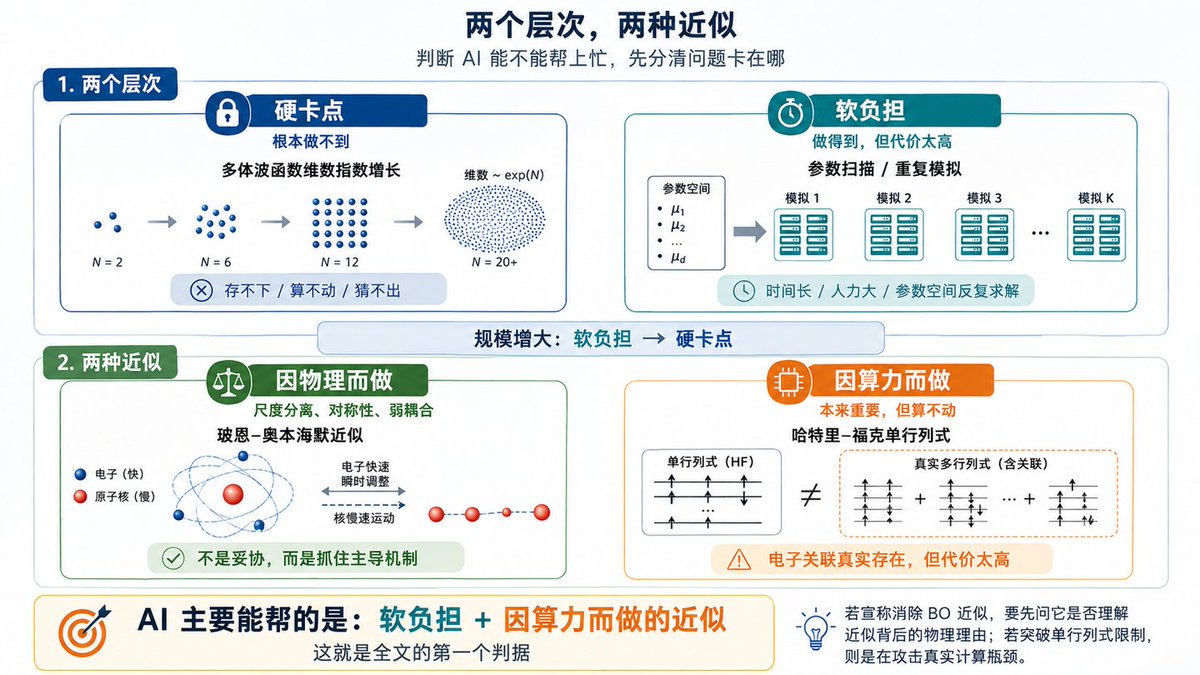
硬卡点,指的是根本做不到:存不下、算不动、猜不出。
多体波函数的维数会随着粒子数指数增长。五十个自旋对应的希尔伯特空间已经是2^{50}维,约10^{15}个复数,存下来要十几个PB。再加五十个自旋,2^{100}约10^{30},比全世界所有存储设备加起来还多好几个数量级。这已经不是“太慢”的问题,而是原则上的不可能。
软负担,指的是理论上做得到,但代价过于高昂:计算时间太长、人力投入太大,或者需要对整个参数空间反复求解。
跑一次有限元模拟并不困难,但如果要在上万个参数点上重复计算,用来做不确定性量化或者参数扫描,往往会耗掉整个课题组几个月的机时。
硬卡点和软负担并不是完全割裂的。随着问题规模不断扩大,软负担最终会积累成硬卡点。理解这种转化机制,是理解AI价值的关键。本章末尾会专门讨论这一点。
不过,即使面对硬卡点,也还需要继续往下分。
物理学家做近似,通常有两种完全不同的动机。
一种是因物理而做。尺度确实可以分离,对称性确实存在,耦合确实足够弱。这样的近似并不是妥协,而是在保留主要物理机制的同时,把问题变得更清楚。
另一种是因算力而做。有些自由度明知道不能丢掉,却因为计算能力有限,不得不人为舍弃。这种近似本质上是一种计算上的妥协。
玻恩-奥本海默近似就是第一种情况。它把电子运动和原子核运动分开处理,理由并不是计算方便,而是质子的质量大约是电子的1836倍,两者对应的时间尺度天然相差几个数量级。做出这个近似之后,我们对体系的主导机制反而看得更清楚。这是因物理而做的近似。
哈特里-福克近似则属于第二种情况。它把多电子波函数限制为单个斯莱特行列式,并不是因为电子关联不存在,而是因为完整处理电子关联的代价实在太高。电子之间的关联是真实存在的物理效应,把它忽略掉,本质上是计算能力不足带来的妥协。
只有后一类近似,才是AI真正能够发挥作用的地方。
这是全文的第一个判据。
如果一篇工作宣称自己“消除了玻恩-奥本海默近似”,那么它很可能没有理解这个近似存在的物理理由。如果一篇工作宣称自己突破了单行列式限制,那么它攻击的则是一个真实存在的计算瓶颈。
这一节的三类东西,连同各自的判断方法,汇总如下。全文后面每一次判定,走的都是这张表。
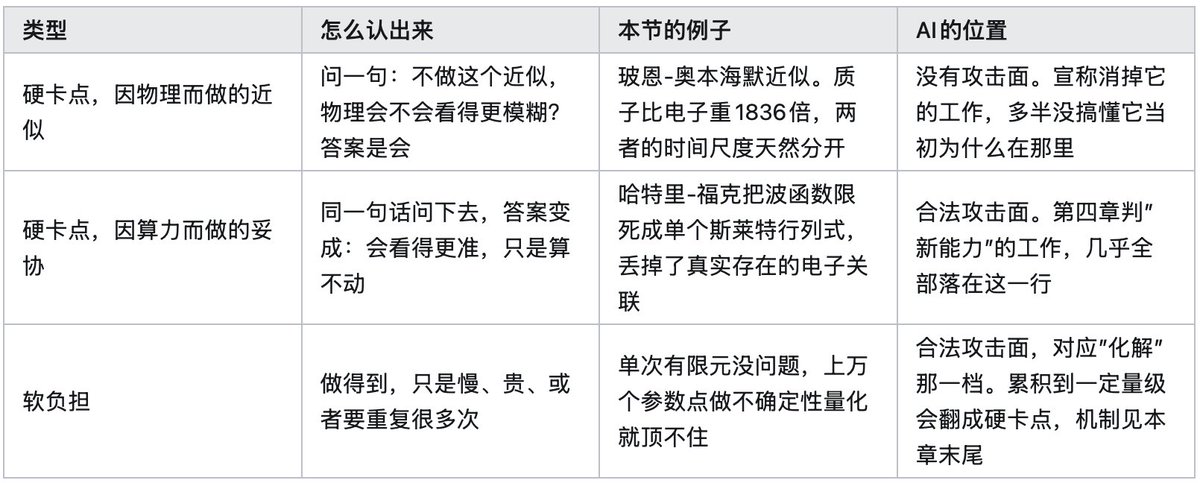
表里最容易被忽略的是第一行。一项工作如果攻的是因物理而做的近似,那么它做得再漂亮,物理上也没有增量,因为被消掉的那个近似本来就不该消。
## 3.2 路线A(解析求解)卡在哪里
讲解析求解那一节停在一个很具体的地方:氢原子有精确解,氦原子没有。
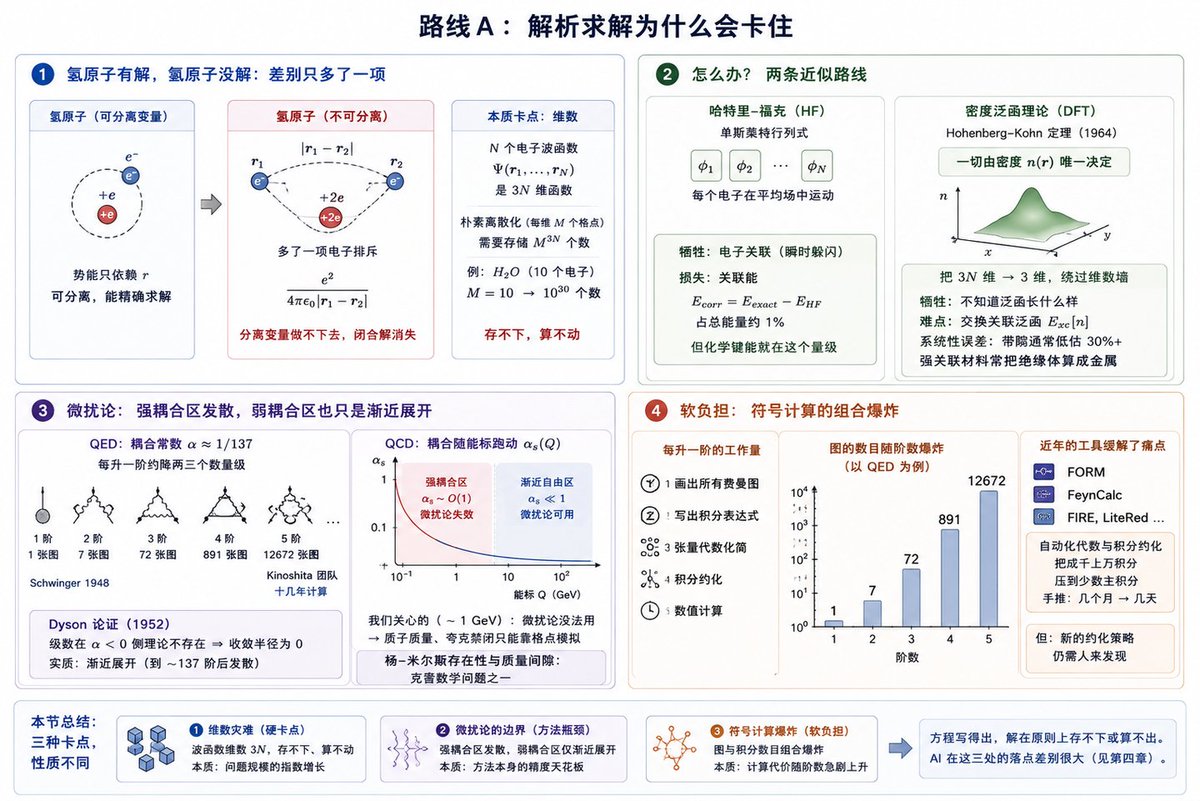
差别只有一项。氢原子里一个电子绕一个核,势能只依赖r,方程可以分离变量。氦原子多一个电子,就多出一项电子之间的排斥
\frac{e^2}{4\pi\epsilon_0|\mathbf r_1-\mathbf r_2|}
这一项把两个电子的坐标锁死在一起,分离变量做不下去。多一个电子,闭合解就没了。
这个卡点的数学形态是维数。N个电子的波函数\Psi(\mathbf r_1,\ldots,\mathbf r_N)是3N个变量的函数。想在计算机里表示它,最朴素的办法是给每个坐标铺M个格点,要存的数就有M^{3N}个。
代进数字看看。一个水分子有十个电子,每个坐标只铺十个格点(这个精度粗糙到根本没法用),要存的数已经是10^{30}个。
这就是Walter Kohn说的指数墙。他在1998年的诺贝尔演讲里下了一个更狠的判断:电子数超过大约一千个之后,多电子波函数就不再是一个合法的科学概念,因为你既写不下它,也没办法用可控的方式去近似它。
这句话定义了路线A(解析求解)的整个处境。方程写得出来,而解这个东西本身在原则上就存不下。
于是有了哈特里-福克和密度泛函理论这些近似。要看清楚的是每一个近似到底拿掉了什么。
哈特里-福克把N电子波函数限制成单个斯莱特行列式,也就是N个单电子轨道的一种反对称组合。物理含义很直白:每个电子只感受到其余电子产生的平均电场,彼此之间不再有瞬时的躲闪。
被拿掉的东西有名字,叫关联能,定义就是精确基态能量减去哈特里-福克能量。
这个量在总能量里只占百分之一左右。听上去无关紧要,问题是化学键的能量尺度也正好在这个量级上。哈特里-福克能拿到百分之九十九的能量,却算不准一个化学反应到底能不能发生。
密度泛函理论换了条路,思路更漂亮。Hohenberg和Kohn在1964年证明,基态的一切性质都由电子密度n(\mathbf r)唯一决定。密度是三维空间上的一个函数,跟电子数无关。3N维的对象换成了三维的对象,指数墙绕过去了。
代价在哪?定理只说存在一个泛函E[n],没说它长什么样。其中最难的一块是交换关联泛函E_{xc}[n],精确形式至今没人知道,实际用的那些(LDA、PBE、SCAN、各种杂化泛函)全是构造加拟合的产物。
这个妥协的位置很明确:把"算不动"换成了"不知道那个函数长什么样"。而且代价能被实验直接抓住。标准泛函系统性低估半导体带隙,误差常在百分之三十以上。过渡金属氧化物这类强关联体系里,实验上明确是绝缘体的材料经常被算成金属。
第二个硬卡点在微扰论那一侧。
微扰论要成立,得有一个小参数。量子电动力学里这个参数是精细结构常数\alpha\approx1/137,每升一阶大约压低两三个数量级,所以算到前几阶就已经极准。
量子色动力学没这个运气。它的耦合常数随能标跑动,能量高的时候很小,这叫渐近自由,微扰论管用。能量降到1 GeV附近,耦合已经接近量级一,展开式里每一项都差不多大,级数失去意义。
麻烦在于我们关心的东西几乎全在这个区间:质子的质量,夸克为什么被永久禁闭在强子内部。所以2.3节那个从第一性原理算质子质量的工作只能上格点数值模拟,路线A(解析求解)在这里没有入口。夸克禁闭至今没有解析证明,与之密切相关的杨-米尔斯存在性与质量间隙,是克雷数学研究所那七个千禧年问题之一。
还有一层更根本的问题,弱耦合区也躲不掉:微扰级数通常根本不收敛。
Dyson在1952年的论证很简洁。假设量子电动力学的级数对\alpha>0收敛,那它在\alpha=0附近就必须收敛,也包括\alpha<0那一侧。但\alpha<0意味着同号电荷相互吸引,真空会自发产生无穷多对正负电子、把能量拉到没有下界,理论根本不存在。所以收敛半径只能是零。
实际发生的是渐近展开:前面若干阶越来越准,到1/\alpha即大约137阶之后开始发散。路线A(解析求解)的主力工具自带一个精度天花板,而这个天花板跟算力无关。它和2.5节BCS能隙里那个e^{-1/N(0)V}是同一件事的两面。
软负担这一侧是符号计算的组合爆炸。
每升一阶,都要把该阶所有可能的中间过程画成费曼图、写成积分、再算掉。图的数目随阶数爆炸:电子反常磁矩第一阶只有1张图(Schwinger在1948年手算出\alpha/2\pi),第二阶7张,第三阶72张,第四阶891张,第五阶12672张。第五阶那批图是Kinoshita一系的团队做了十几年的工作。
这一块近年有了工具。FORM、FeynCalc这类系统能自动做张量代数,分部积分约化把成千上万个积分用恒等式压到少数几个主积分上,原本几个月的手推能压到几天。但工具执行的是既定的约化规则,找出新的约化策略仍然靠人。
把这一节的账理一下。路线A(解析求解)有三个卡点,性质完全不同:波函数存不下是维数问题,属于算不动。微扰级数在强耦合区发散、在弱耦合区也只是渐近,属于方法本身的边界。符号计算的组合爆炸是软负担。
第四章会看到,AI在这三处的落点差别极大。
## 3.3 路线B(数值模拟)卡在哪里
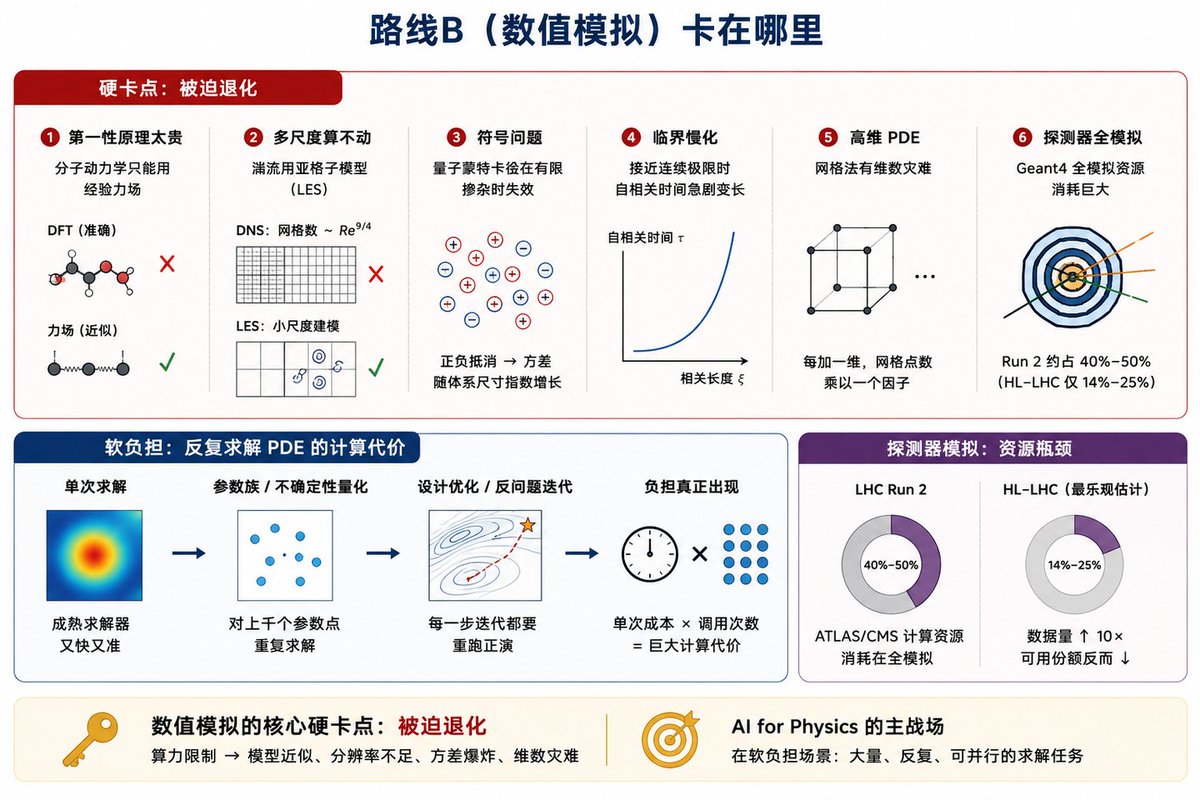
数值模拟的硬卡点集中在"被迫退化"这件事上。
第一性原理电子结构太贵,所以分子动力学退到经验力场。这是一次典型的因算力而做的妥协:明知道力场参数是拟合出来的、在新化学环境下不可靠,还是得用,因为密度泛函理论算不动纳秒量级的轨迹。
多尺度全解析算不动,所以湍流用亚格子模型。直接数值模拟要求网格分辨到柯尔莫哥洛夫尺度,所需网格点数随雷诺数的九分之四次方增长。飞机机翼上的雷诺数在千万量级,直接数值模拟需要的算力比现在的超算高好几个数量级。所以大涡模拟把小尺度打包成模型,模型的形式仍然是半经验的。
费米子符号问题让量子蒙特卡洛在有限掺杂的哈伯德模型上失效,采样权重正负抵消,统计误差随体系尺寸指数增长。临界慢化让格点模拟在接近连续极限时的自相关时间急剧变长。高维偏微分方程(福克-普朗克方程、哈密顿-雅可比-贝尔曼方程)的网格法有维数灾难,每加一维网格点数乘以一个因子,五维以上基本没法用规则网格。
软负担这一侧有一块容易漏掉,偏偏它又对应着AI for Physics文献量最大的一部分:反复求解偏微分方程的计算代价。
这里要把话说准。单次求解一个二维泊松方程或者热传导方程,成熟求解器又快又准,没有多少负担。负担出现在另一种场景:你要对一整族参数反复求解。做不确定性量化要跑上千次不同参数的正演,做设计优化要在参数空间里迭代搜索,反问题的每一步迭代也要重跑正演。
这时候,单次成本乘以调用次数,负担才真正出来。同一个求解器,在这两种用法下完全不是一回事。
探测器全模拟是另一块。Geant4的全模拟在LHC的Run 2期间占掉ATLAS和CMS大约百分之四十的计算资源,ATLAS一侧的说法接近百分之五十。到高亮度LHC,就算按最乐观的计算模型,能留给模拟的份额也只有百分之十四到二十五。数据量要涨一个量级,可用份额却在缩,这条路按现有方式走不通。
## 3.4 路线C(定性分析)卡在哪里
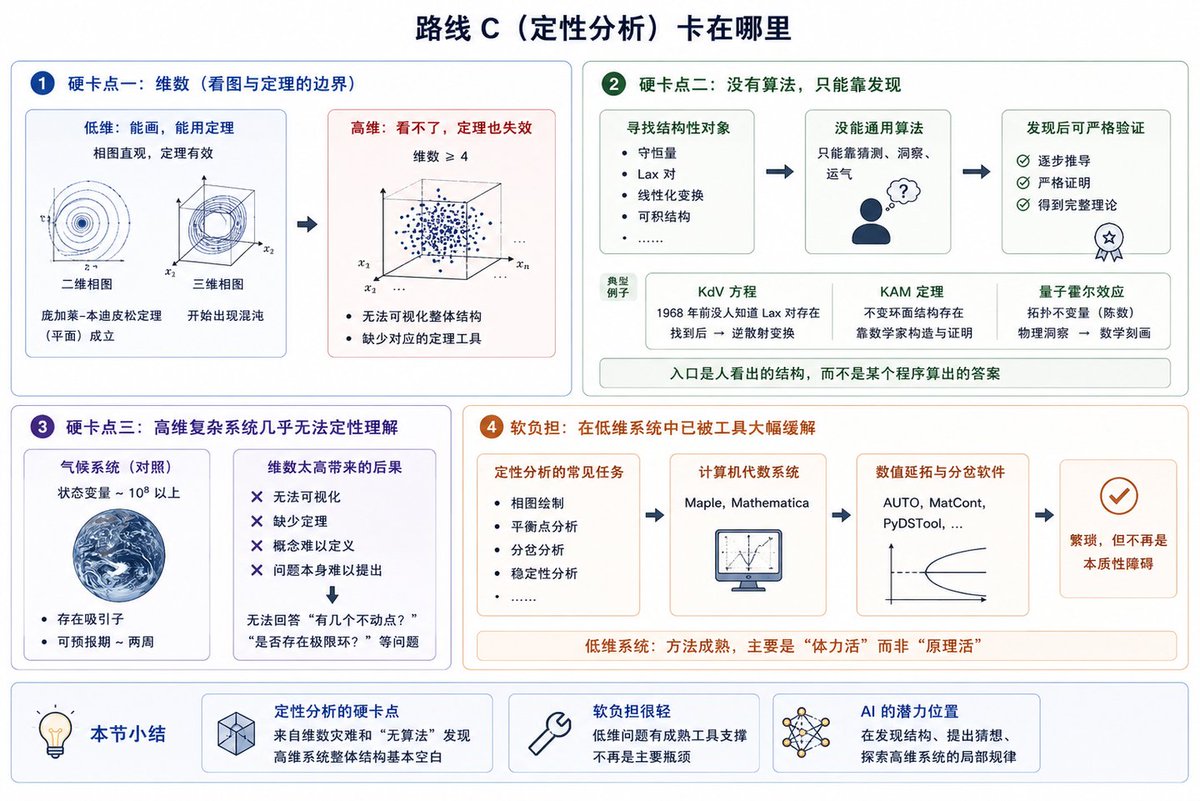
定性分析的硬卡点,主要来自维数,以及人类看图和想象高维结构的能力边界。
相图只在二维、三维画得出来。庞加莱-本迪克松定理只在二维平面上成立,一到三维混沌就出现了,那条定理的结论直接失效。高维系统的整体结构基本是空白。原因有两条:既没有对应的定理,人也看不了五十维的图。
另一类硬卡点是"没有算法"。找守恒量没有算法,找Lax对没有算法,找把非线性系统变线性的坐标变换没有算法。这些全靠猜,靠的是某个人某天看出了一个结构。可积系统的每一个例子背后都有一段这样的故事。
上一章讲定性分析时点到的那些结构,每一个都有这个毛病。KdV方程的Lax对在1968年之前没人知道存在,找到之后一整套逆散射变换才建立起来,但入口是一个人看出的代数结构,不是某个通用程序跑出来的答案。KAM定理的不变环面、量子霍尔的陈数,情况都一样:写出来之后每一步都可以验证,写出来之前没有路径可循。
高维那一侧,可以拿气候系统作对照。全球大气的状态变量有上亿个,我们知道这个系统有吸引子,也知道可预报期是两周量级,但对这个吸引子的整体几何结构几乎说不清。
那些在二维、三维里能问的问题,比如有几个不动点、有没有极限环、分岔发生在哪,到了上亿维连问法都很难成立。
软负担在这条路线上很轻。低维系统的相图绘制和分岔分析是繁琐工作,但计算机代数系统和数值延拓软件(AUTO、MatCont)已经把它做得相当自动化了。
## 3.5 路线D(有效理论)卡在哪里
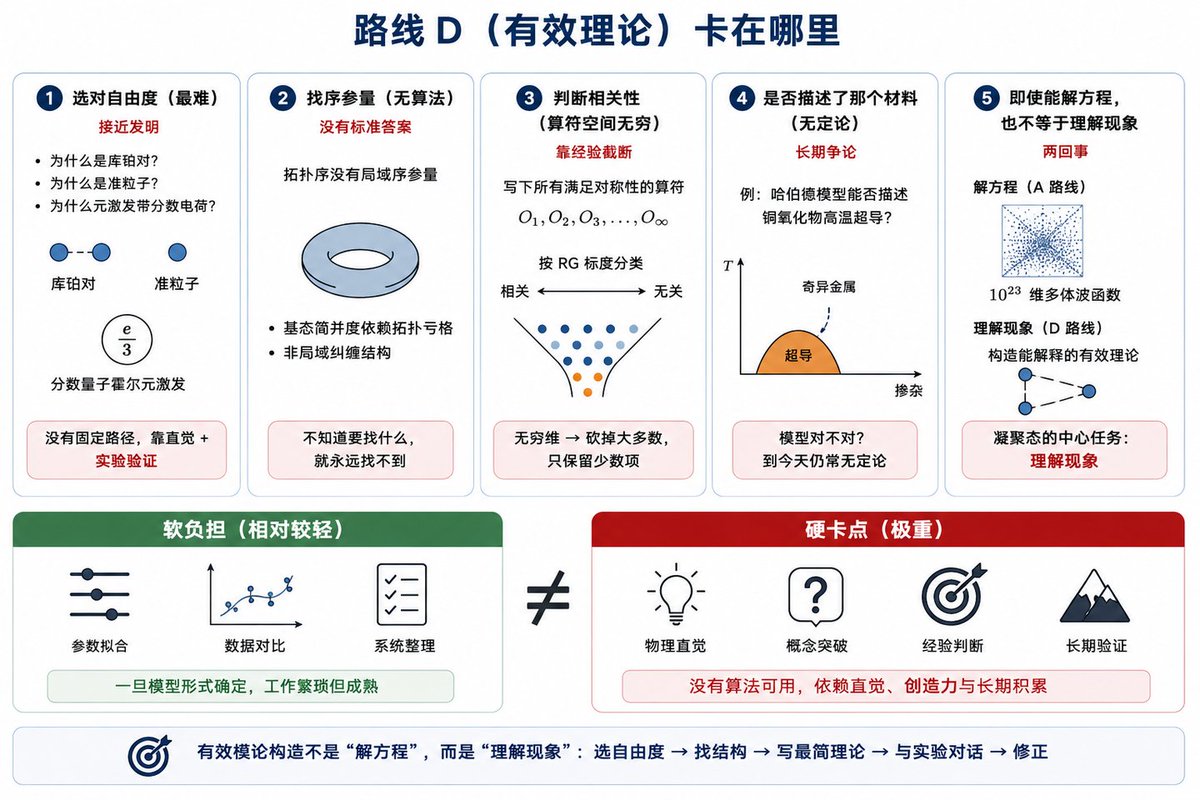
有效理论构造的硬卡点,是五条路线里最难啃的一块。
选对自由度是最难的一步,而这一步接近发明。为什么是库珀对,不是三电子束缚态?为什么是准粒子,不是原子?为什么分数量子霍尔态里的元激发带分数电荷?这些问题没有固定推导路径,靠的是物理直觉和事后的实验验证。
找序参量同样没有算法。拓扑序花了几十年才被认识清楚,正是因为它没有局域序参量。文小刚在1989到1990年提出这个概念的时候,遇到的困难是朗道范式里所有的工具都用不上:没有对称性破缺,没有局域序参量,两个态的区别要靠基态简并度对拓扑亏格的依赖、以及非局域的纠缠结构来刻画。这类东西你不知道要找什么,就永远找不到。
判断相关性是第三层困难。有效理论的写法原则上是把所有满足对称性的算符都写出来,再按重整化群标度看哪些相关、哪些无关。问题是算符空间是无穷维的,实际操作里要靠经验砍到几项。
第四层困难是判断一个有效模型是否真的描述了那个材料。哈伯德模型能不能描述铜氧化物高温超导,这个问题吵了快四十年,到今天仍然没有定论。
这条路线上最关键的一点在这里。即使路线A(解析求解)完全成功,真的解出了10的23次方维的多体波函数,你也得不到BCS理论。解出方程和理解现象是两回事,而凝聚态的中心任务是后者。
软负担在这条路线上反而很轻。有效模型的形式一旦定下来,参数拟合是繁琐但成熟的工作。这条路线的形状跟路线B(数值模拟)恰好相反:软负担轻,硬卡点极重。
## 3.6 路线E(实验与推断)卡在哪里
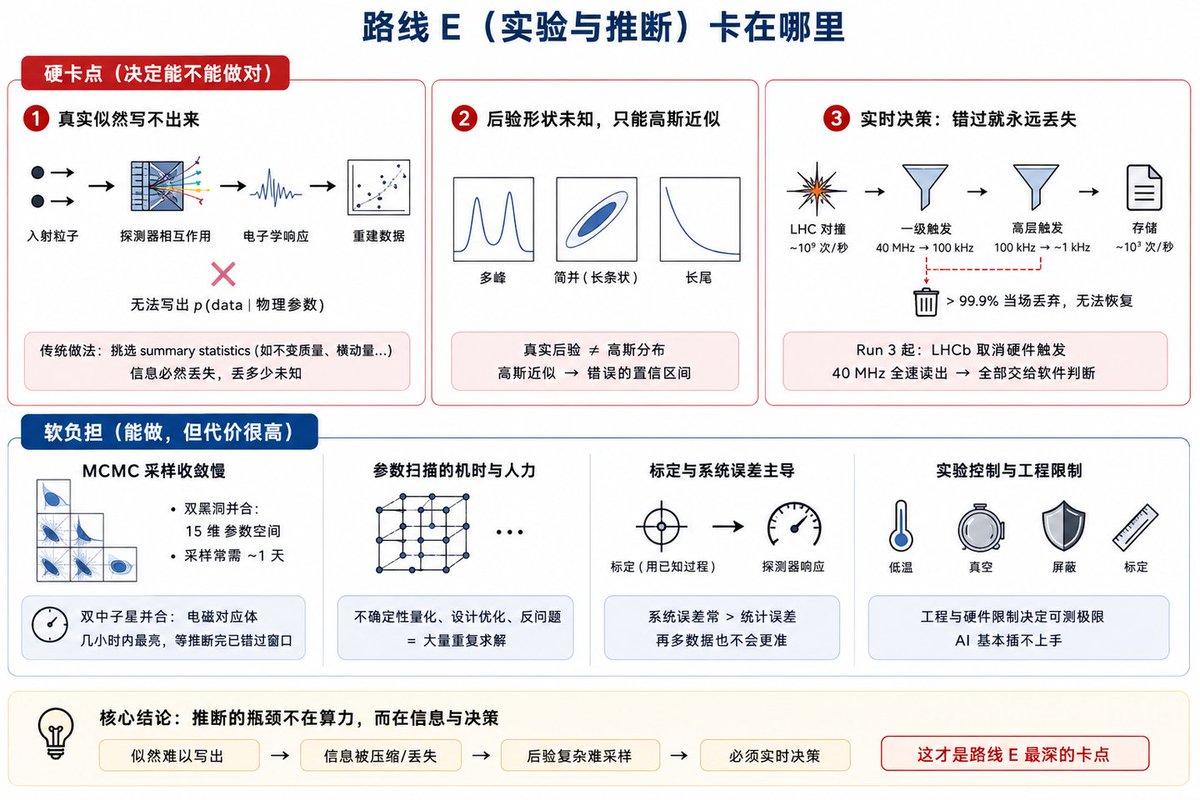
实验与推断的硬卡点,第一条是真实似然写不出来。
任何一个复杂实验,从入射粒子到最终读出的电子学信号,中间经过几十道随机过程。原则上你有一个模拟器能把整条链跑一遍,但你写不出"给定物理参数,观测到这组数据的概率密度"这个函数。写不出似然,标准的贝叶斯推断和最大似然估计就都用不了。
传统的绕法是手工挑一组summary statistics(把高维数据压成几个数,比如不变质量、横动量),在这几个数上做推断。这一步一定丢信息,丢多少通常不知道。
第二条是后验形状未知,只能用高斯近似传播误差。真实的后验分布可能有多峰、有强简并、有长尾,全按高斯处理会给出错误的置信区间。
第三条是实时决策。LHC每秒产生4000万次束团交叉,在设计亮度下对应每秒约十亿次质子对撞。ATLAS和CMS的一级触发把40MHz压到100kHz,高层触发再压到大约每秒一千个事例。剩下的百万分之一之外的数据,当场丢掉,永远拿不回来。丢错了就是丢错了。
LHCb在Run 3索性把硬件触发整个拆掉,探测器按40MHz全速读出,全部交给软件判断。这是把一个硬卡点用工程手段推后了一步,代价是软件层的实时处理压力全部落到了算法上。
软负担这一侧,MCMC采样的收敛时间是老问题。双黑洞并合的参数空间有十五个维度,传统方法下采样常常要跑到一天量级。对双中子星来说,这个延迟很致命:并合后的电磁对应体在几小时内最亮,等推断跑完,最有价值的观测窗口已经过去了。实验参数扫描的人力与机时是另一块。
还有一层负担落在标定上。任何一个探测器都要先用已知过程标定自己的响应,这一步的系统误差常常比统计误差还大。LHC的不少测量到今天仍然是系统误差主导的,也就是说再多攒数据也不会让结果变准。这一类负担AI基本插不上手,它属于硬件和标定流程的问题。
## 3.7 算不动,还是猜不出
把五条路线的硬卡点摆在一起,会看到它们分成截然不同的两类。
算不动(路线A、B、E,也就是解析求解、数值模拟、实验与推断):要处理的对象是一个高维函数。波函数、势能面、后验分布、场组态。维数灾难使它存不下、采不了、积不出。困难是定量的,本质上是资源问题。
猜不出(路线C、D,也就是定性分析和有效理论构造):要找的是一个结构。自由度、守恒量、序参量、相图拓扑。困难在于"什么算好结构"需要判断力,而且答案必须是人能理解的形式。
这只是一次归纳,不另立分类体系。全文的骨架自始至终是路线A到E。但这次归纳会在第四章反复用到。
还有一件事要说在前面:软负担和硬卡点之间的转化机制。
单次求解偏微分方程做得到,跑一万次做不确定性量化就做不到。单次密度泛函理论计算做得到,跑纳秒级的分子动力学(需要上百万步,每步一次力的计算)就做不到。单次探测器模拟做得到,跟上LHC的数据率就做不到。
所以"快四个数量级"不是简单的量变。它把一个硬卡点降级成了软负担。这个机制是第四章"化解外溢为新能力"的全部内容。
这两类困难还有一个操作上的区别。算不动的问题,你能写出一个明确的目标:把这个高维积分算准,把这个基态能量压低,把这个后验估准。目标一旦能写成数字,梯度下降就有地方使劲。
猜不出的问题写不出这种目标。什么叫一个好的序参量,什么叫一个好的自由度,标准里包含了简洁性、可解释性、能不能接上别的已知理论。这些条件互相之间还会打架,压根不构成一个可优化的函数。第四章判定路线D(有效理论)帮不上忙,根子就在这里。
还有一个连带推论,关于可解释性。在路线A(解析求解)、B(数值模拟)、E(实验与推断),可解释性是可选评价指标。没有人要求机器学习势函数必须可解释,只要它在验证集上准、在外推区间有不确定性估计就行。在路线C(定性分析)、D(有效理论),可解释性本身就是产出的一部分:说不出理由的模型在那里等于没有产出,因为那两条路线要的就是一个人能理解的结构。
整章的账,汇总成一张表。
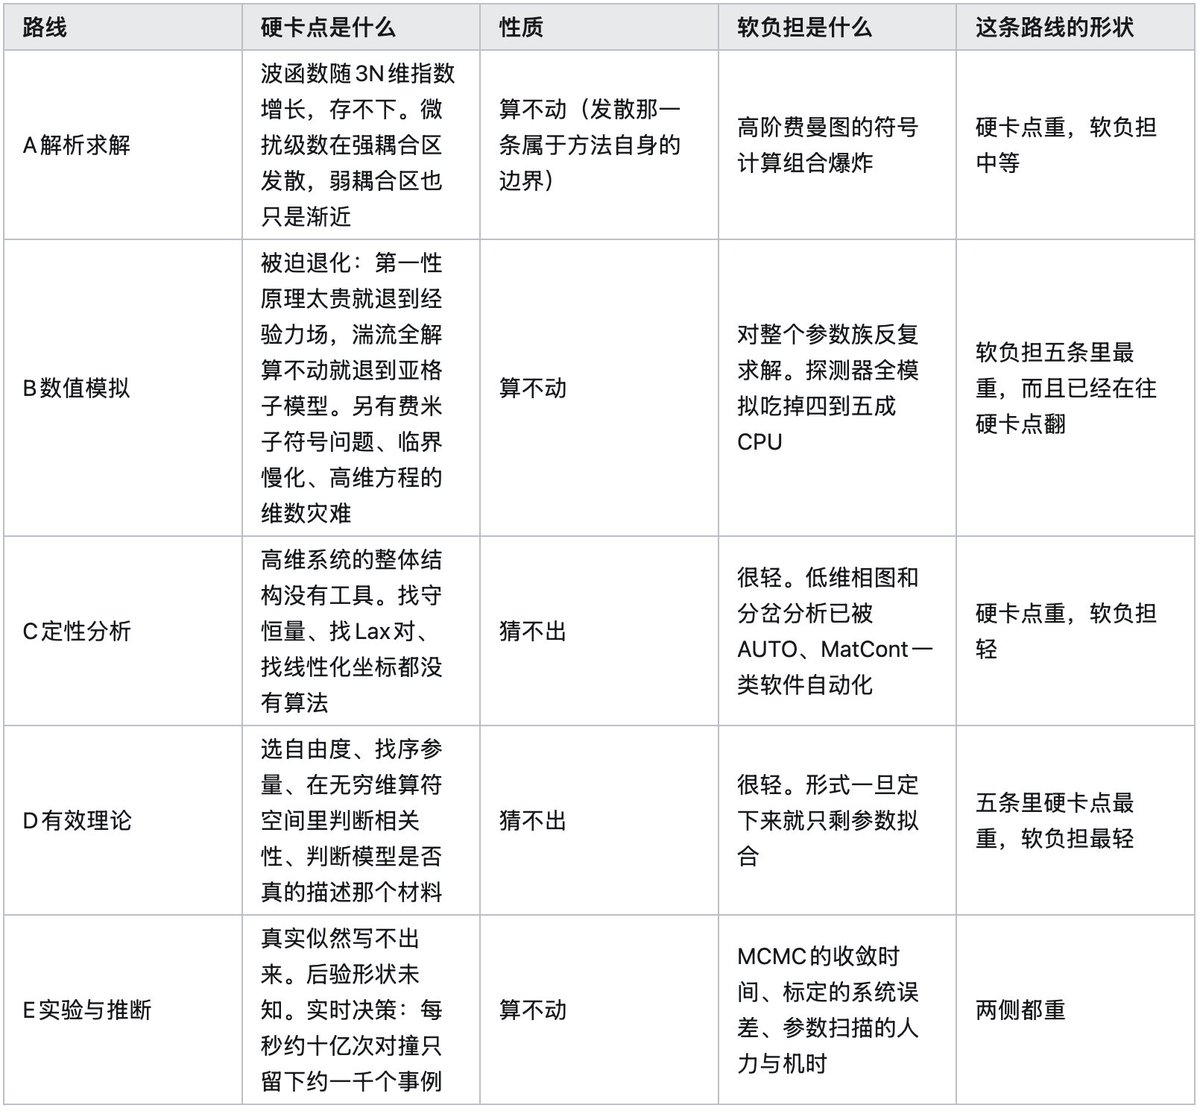
这张表里最该看的是"性质"那一列。它预告了第四章的全部结论:算不动的三条路线,AI都有斩获。猜不出的两条,至今是空的。
第二该看的是最后一列里B和D的对照。路线B(数值模拟)软负担最重,所以AI的成绩在那里最密集。路线D(有效理论)软负担最轻、硬卡点最重,所以AI在那里连"化解"的空间都没有。这两条路线的形状恰好相反,而AI的成绩分布跟着形状走,跟硬卡点的深浅没有关系。
# 四、AI落在哪里
下面严格按路线A到E逐条走。每条路线先说清AI在那条路线上一共有几类工作,再逐类用化解、新能力、帮不上忙三档评判。每一节列出的是那条路线上的全部主要方向,不是从中挑几个顺手的。
## 4.1 路线A(解析求解):AI能不能多写出几个公式
物理学家最想要的,说到底还是一个公式。
2.2那个二体问题的解就是最好的样本。r(\theta)=p/(1+e\cos\theta),短短一行,轨道是圆是椭圆还是双曲线,周期跟半长轴什么关系,能量和角动量从哪里进来,全装在里面。你不用跑任何程序,盯着这个式子看就能想明白。
路线A(解析求解)的卡点,说白了就是这样的式子太少。氦原子多一个电子,式子就没了。强耦合区微扰展开一发散,连逐阶往下算的余地都没有。
所以这一节要问的问题很直白:AI能不能帮我们多写出几个这样的式子?
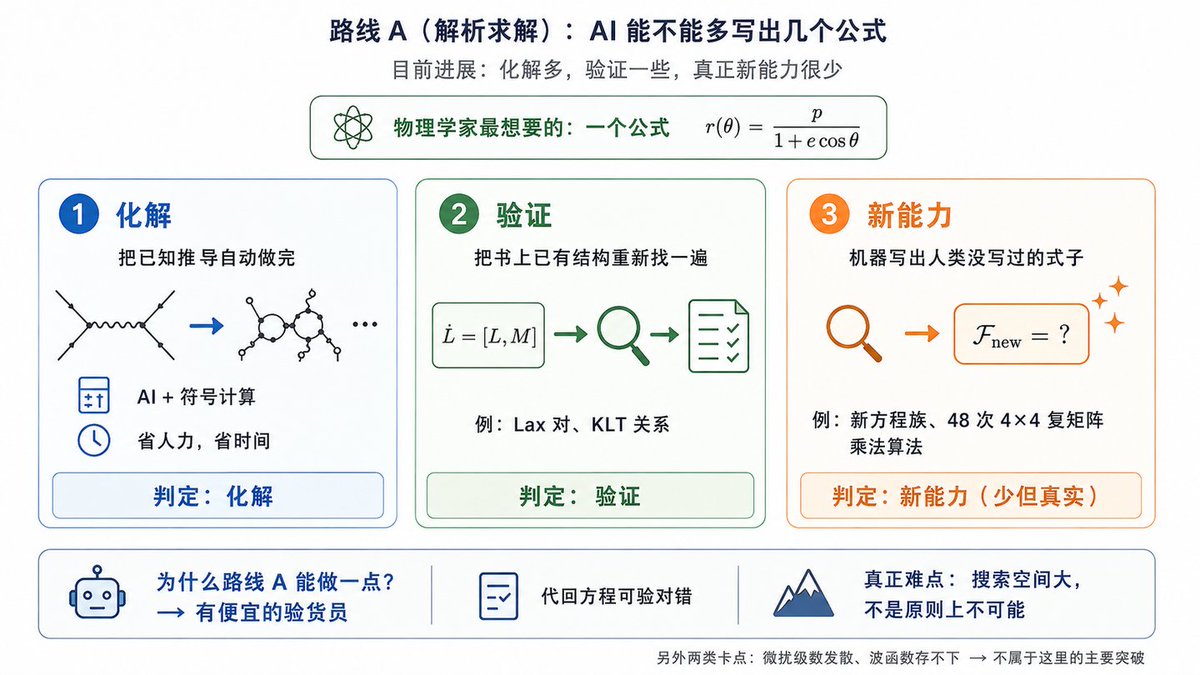
能,但目前只走到很浅的地方。已有的工作分三层,一层比一层薄。
最下面一层,是替人把已经知道该怎么做的推导做完。
3.2讲过,反常磁矩算到第五阶要对付12672张图。每张图化成一个积分,成千上万个积分之间躺着大量恒等式,可以互相消掉,最后压到几个主积分上。规则全写在书里,难的是先用哪一条、后用哪一条。有点像解魔方,每一步怎么转都合法,难在找出还原的那个顺序。
2019年,Guillaume Lample和François Charton拿做翻译用的那类网络去学符号积分和解常微分方程,在一批题目上赢过了商业代数系统。这条路后来接进了粒子物理。2024年,Tianji Cai、Garrett Merz和François Charton等人用transformer预测平面N=4超杨-米尔斯理论振幅表达式里的整数系数,准确率超过98%。
这一层的产出确实是符号表达式,货真价实的解析结果。可它算的是人早就知道该怎么算的东西,振幅那篇重现的也是已知阶数。
判定:化解。省的是人的工夫。
往上一层,是把已经有人找到过的结构重新找一遍。
Lax对是可积性理论的钥匙,而上一章说过,找它没有算法。2025年有一组人训练网络从稀疏数据里反推Lax对,试的是平流方程、KdV、mKdV、Boussinesq-Burgers和非线性薛定谔方程。这几个方程的Lax对,书上早就写着。
同一类的还有用符号回归重新推出KLT关系、从数据里提取多圈费曼积分的symbol alphabet。方法都很漂亮,找到的东西你翻书就有。
判定:验证。跟路线C(定性分析)那边的处境一模一样。
再往上才是真东西:写出人类没写过的式子。这一层很薄,但不是空的。
Subhash Kantamneni、Ziming Liu和Max Tegmark在2024年做了一件思路很干净的事。他们让机器去调一族偏微分方程的系数,目标函数只有一条,让守恒量的个数尽可能多。守恒量越多,方程就越可能可积,也就越可能有闭合解。
跑出来四族方程,其中三族文献里查不到。人再接手验证和分析,论文展开讲的那一族长这样:
u_t=(u_x+a^2u_{xxx})^3
两句保留意见得说在前面。论文摘要的严谨措辞是这三族"至少有一个守恒量",比标题里的"可积"要弱不少。再者这是Tegmark组的活儿,AI Feynman和AI Poincaré都出自这里,他们对"AI发现物理"的口径一向偏松。
上面是物理的情况,数学那边的证据硬得多。
2025年5月,DeepMind的AlphaEvolve找到了一个只用48次标量乘法完成4×4复矩阵相乘的算法。Strassen在1969年给出的记录,在这个设定下五十六年没人动过。这套系统还被拿去试了五十多个数学开放问题,约四分之三的情形重现了已知最优,少数刷新了纪录。
判定:新能力。目前只有零星几个点,但那确实是人类此前不知道的符号结果。
路线A(解析求解)的成绩就这么薄。不过它薄的理由,跟路线C(定性分析)、D(有效理论)那两条完全不是一回事,这一点值得单说。
C和D那边卡在没法给机器一个目标。什么算好的序参量,标准里混着简洁、好懂、能不能接上别的理论,这些东西写不成一个损失函数。
路线A(解析求解)手里有一样它们没有的东西:一个便宜的验货员。一个解写得对不对,代回方程一验就知道。守恒量有几个,数得出来。矩阵乘法算法对不对,跑一遍就知道。
Tegmark那套东西跑得起来,就因为"守恒量个数"是个能算的数。AlphaEvolve跑得起来,就因为算法正确与否机器能自动核。有了验货员,机器就可以放开了乱猜,猜错的当场扔掉。
所以路线A(解析求解)真正难的地方在搜索空间。符号是离散的、组合的,梯度下降在这里使不上劲,只能一个一个试。这是个工程难题,不是一堵原理上的墙。第六章会回到这一点。
还剩一件事要交代。3.2给路线A(解析求解)列了三个卡点,这一节只碰到了一个。
符号计算的组合爆炸,最下面那一层在攻。微扰级数发散,至今无人问津,因为Dyson那个论证给的是收敛半径为零,而收敛半径不会因为算力变大就改变。
剩下那个"波函数存不下",物理学家的回应是干脆放弃公式,转去求一个足够准的数。神经量子态就是这么来的:网络表示波函数,蒙特卡洛算能量,最后交给你一个数字加一根误差棒。网络里那几百万个权重,没人能从中读出一行式子。
这条路等于承认了解析解拿不到。所以它归在路线B(数值模拟),4.3再讲。
## 4.2 路线B(数值模拟)之一:机器学习解偏微分方程
先说体量。AI for Physics的论文里,这一块最多,多到别的方向加起来也未必赶得上。
原因不难猜。几乎每个物理子领域最后都要解偏微分方程,流体、电磁、输运、弹性、等离子体、地震波、气象海洋,全都是。凡是有一大群人反复做同一件苦活的地方,就会有一大群人想用机器学习去省它。
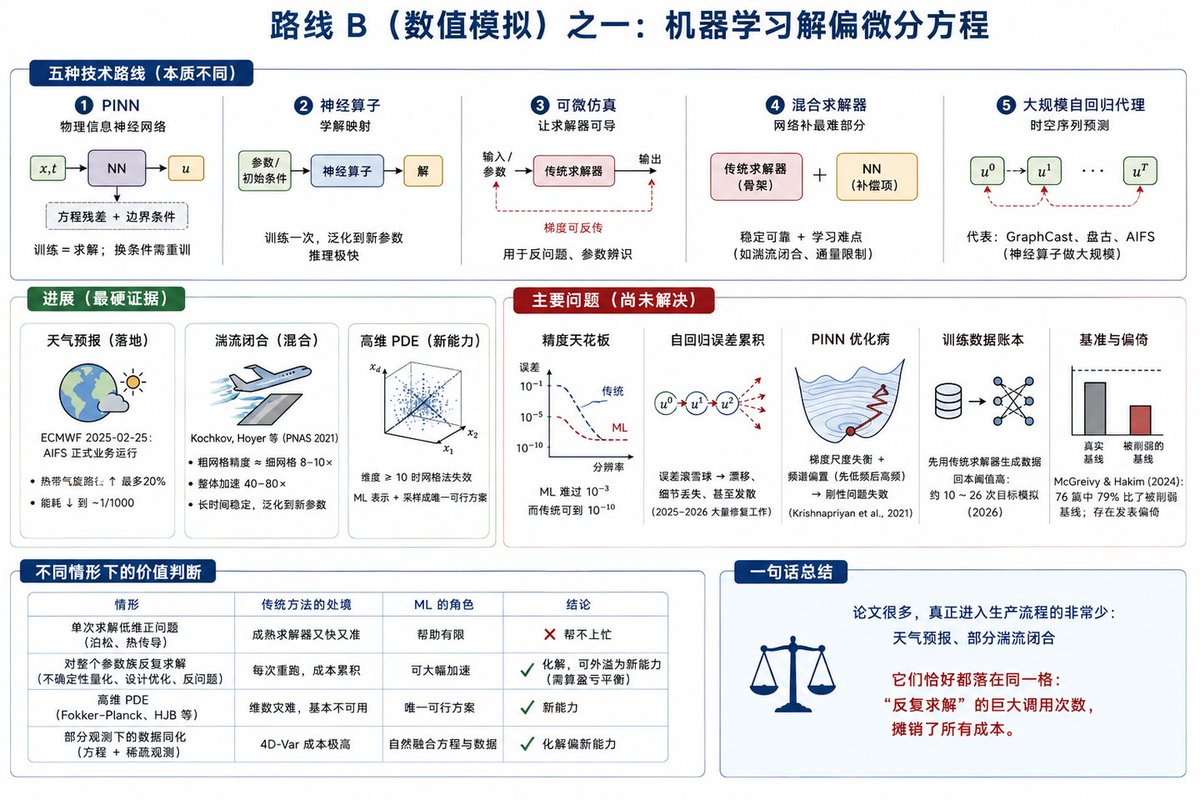
麻烦在于这一块内部差别极大,外面看是一团,进去才发现是五种完全不同的东西。
PINN(physics-informed neural network)把方程的残差直接写进损失函数,网络一边拟合数据一边被逼着满足方程。它的特点是训练本身就是求解:网络训完了,解也就出来了。换一个初始条件或者边界条件,得重训一遍。
神经算子学的是另一样东西,"参数或初始条件到解"这整条映射。傅里叶神经算子和DeepONet是两个代表。训练一次很贵,之后每来一组新参数就是一次前向推理,几乎不要钱。
可微仿真不换求解器,只是把传统求解器改写成处处可导的形式,让梯度能穿过整条模拟链。这样一来,反问题和参数辨识可以直接用梯度下降做。
混合求解器的骨架仍然是传统方法,网络只负责最难啃的那一小块,比如湍流的亚格子应力、激波格式里的通量限制器。
大规模自回归代理是这几年最出风头的一类,GraphCast、盘古、AIFS都属于这一支,本质上是神经算子做到了很大的规模。
这五种被文献混着叫,读者也就跟着混。它们能兑现什么其实差得很远,下面分亮暗两面来看。
进展这一侧,有三个证据最硬。
第一个是天气,这也是这一支落地最实的地方。5.3会细讲GraphCast,这里先说更能说明问题的一件事:欧洲中期天气预报中心在2025年2月25日让自己的机器学习模式AIFS正式投入业务运行,跟物理模式并排跑,24小时值班。热带气旋路径这类指标上最多好20%,出一次预报的能耗降到约千分之一。
这件事的分量不在精度上,在于最保守的那类机构接受了它。天气预报是有人拿命做决策的行业,业务化的门槛跟发论文完全是两回事。
第二个证据来自混合求解器。Dmitrii Kochkov、Stephan Hoyer等人2021年在《美国国家科学院院刊》上做二维湍流,让网络去学粗网格上的修正项。结果是粗网格算出的精度相当于8到10倍细的网格,整体快40到80倍。更要紧的是它长时间跑不发散,而且换一个训练时没见过的雷诺数和强迫方式仍然管用。
把骨架留给几十年验证过的传统方法,只让网络啃最难那一小块,这条路子到今天仍是最稳的。
第三个证据在高维。福克-普朗克方程、哈密顿-雅可比-贝尔曼方程到了十维以上,规则网格根本铺不开,网络表示解函数加蒙特卡洛采样是目前唯一能动的路子。这一格后面还会再碰到。
说完了亮的,该说暗的。这一支的问题有五个,每一个都还没解决。
最硬的一条是精度封顶。传统求解器能一路收敛到机器精度,误差压到10的负10次方量级,网络到10的负3次方左右就很难再往下走。对很多用途这够了,可一旦你要算特征值、做长期积分、或者拿结果去做灵敏度分析,这个天花板就致命。更别扭的是,ML硬件正在往低精度跑(bf16、fp8),跟科学计算要的方向正好相反。
接着是自回归的误差滚雪球。大模型做时间演化,都是把上一步的预测喂回去当下一步的输入。误差在这个回路里被反复放大,跑长了会漂移、会把细节抹平、严重时直接发散。2025到2026年冒出一大批专门治这个病的工作,光是名字就有JAWS、RNO、ENMA、AFNO好几个,这本身就说明病还没治好。
PINN还有一种专属的优化病。Aditi Krishnapriyan等人2021年做了一件挺打击人的事:他们证明PINN在刚性输运问题上会失败,即使那个方程的解本身光滑得不能再光滑。失败的原因不在网络表达力不够,在于PINN那个损失函数的地形太难走。方程残差项和边界条件项的梯度量级差得太远,网络又天生先学低频、后学高频。换句话说,毛病长在方法的骨子里。
训练数据这笔账也常被忽略。神经算子的训练数据是拿传统求解器算出来的,也就是说你为了省下未来的求解,先得多做几千次求解。2026年一份稀薄气体动理学的工作把这笔账算了出来:光训练成本要跑约10次目标模拟才回本,把生成数据的成本也算进去要约26次。低于这个次数,老老实实用传统求解器更划算。
第五条毛病出在基准本身。Nick McGreivy和Ammar Hakim在2024年查了所有声称胜过标准数值方法的流体类偏微分方程论文,76篇里有60篇,也就是百分之七十九,比的是一个被削弱过的基线。他们还找到了系统性的结果选择偏倚和发表偏倚。这意味着这一整支报出来的加速比,作为一个整体不可信。
把亮的暗的放在一起,判定就没法只给一个。上面那三个证据其实落在不同的格子里:天气和湍流闭合是同一类,都属于要反复求解成千上万次的场景,高维方程则是另一类。同一套方法换个情形,落点差得很远。
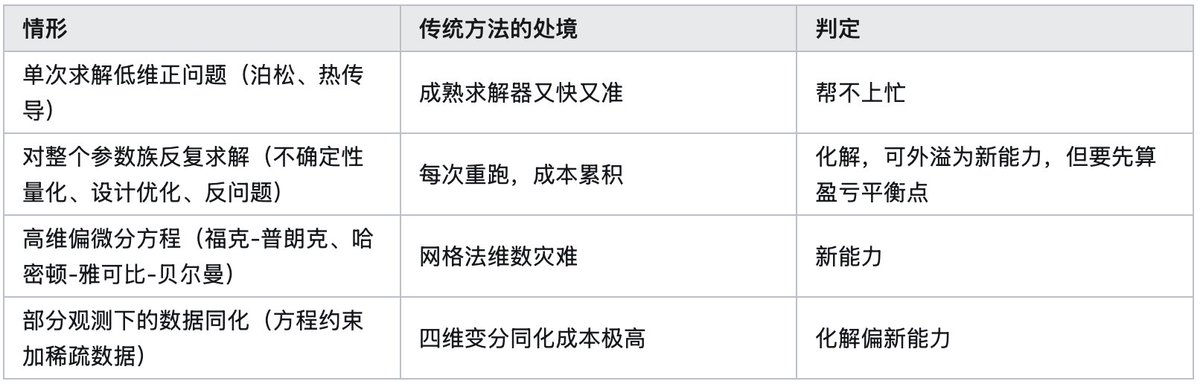
第一格里根本没有妥协可消。一个二维泊松方程用多重网格法解,误差可控、成本极低、几十年工程验证。在这里机器学习要赢极难,输了也很正常,而这一格的负面结论不该外推到另外三格去。
第四格是数据同化:手上有个方程约束,同时有一批稀疏、带噪、只覆盖局部的观测,要把两者拼成一个完整的场。传统的四维变分同化要反复跑正演和伴随模式,贵得吓人。把方程残差写进损失、同时拟合观测,PINN这一类方法做起来相当自然。
这张表可以直接拿去读文献:一篇论文说自己比传统求解器快多少倍,先问它做的是哪一格。
把机器学习解偏微分方程这一支的真实状态说一句。论文成千上万,真正进了生产流程的只有两处,天气预报和一部分湍流闭合。而这两处恰好都落在第二格里:全世界每天都要出预报、每个机翼设计都要跑成千上万次流场,调用次数大到足以摊销一切。
## 4.3 路线B(数值模拟)之二:把高维对象交给网络
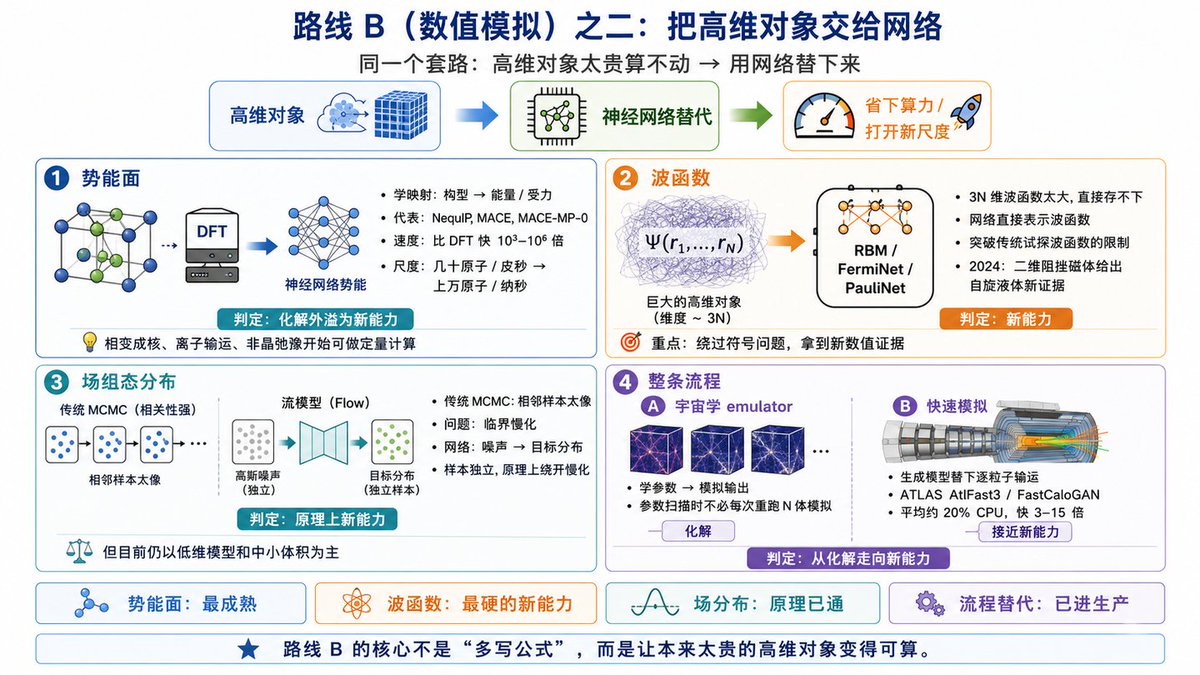
这一节的四件事共用一个套路:手上有个高维对象贵得算不动,就训一个网络把它替下来。替下来的东西各不相同,省下的力气也各不相同。
先说势能面,这是整个AI for Physics里落地最彻底的一块。
问题上一章说过:密度泛函理论准但贵,经验力场便宜但不准,中间空着。机器学习势函数学的就是"给定原子构型,输出能量和受力"这个映射,训练数据来自密度泛函理论。
Simon Batzner等人2022年的NequIP和Ilyes Batatia等人同年的MACE,把等变性(旋转、平移、置换下的对称性)直接焊进消息传递网络,几百到几千个构型就能训到接近密度泛函理论的精度。往后是通用势函数,剑桥Gábor Csányi组的MACE-MP-0在约160万个体相晶体构型上训练,覆盖89种元素,拿来就能用,不必为每个新体系重训。
速度上,每一步比密度泛函理论快三到六个数量级,具体倍数看体系规模和硬件。经典力场相对密度泛函理论的加速区间本来就在10的3次方到10的6次方,机器学习势函数把这个区间的大部分拿了回来,同时保住了不少第一性原理精度。
判定:化解外溢为新能力,机制就是软负担累积到一定量级会翻成硬卡点那一条。原本只能算几十个原子、几皮秒的第一性原理分子动力学,现在能算上万个原子、纳秒量级。相变的成核要在长时间尺度上等一个稀有事件,锂离子电池电解质的离子输运需要纳秒量级的统计,非晶材料的结构弛豫更是要跑到微秒。这几类问题过去只能拿经验力场做定性讨论,现在能在接近第一性原理的精度上做定量计算。
网络也能替下波函数。
多体波函数是3N个变量的函数,3.2那堵指数墙就是冲它来的。既然存不下,那就别存了,改用一个网络表示它:输入所有粒子的位置或所有自旋的朝向,输出一个数,要用的时候现算。
Giuseppe Carleo和Matthias Troyer在2017年第一次把这条路走通,用受限玻尔兹曼机表示自旋系统的波函数。分子那边后来有DeepMind的FermiNet和Frank Noé组的PauliNet,两者都把电子交换的反对称性直接焊进网络结构。
这一步的分量要回到变分法那一节才看得清。传统变分法必须先猜一个试探波函数的形式,而哈特里-福克那个形式窄得离谱,等于假设每个电子只感受得到平均电场。网络没有这层束缚。
真正让我改口的是2024年的一个结果。有一类材料叫阻挫磁体,里面的自旋都想跟邻居反着排,几何上偏偏排不开,像三个人围一张桌子玩剪刀石头布,谁也赢不了所有人。这类系统降到绝对零度,自旋可能还在涨落,不冻结成任何有序图案。这种状态叫量子自旋液体,它到底存不存在、长什么样,凝聚态争了几十年。
难就难在算不了。传统的量子蒙特卡洛在这里失灵,采样权重有正有负、互相抵消,也就是3.3那个符号问题。
Ao Chen和Markus Heyl在2024年的《自然物理》上给出一套训练深度神经网络波函数的新办法,把二维阻挫磁体的基态能量压到了所有已知方法之下,并给出支持无能隙自旋液体相存在的证据。一个争了几十年的问题,第一次拿到来自数值的新证据。
判定:新能力。
第三样被替下来的东西更抽象一点,是场组态的分布。
格点场论要算路径积分,做法是把场所有可能的样子按权重加起来。可能的样子有无穷多种,实际只能随机抽几十万个有代表性的来平均。
抽样靠马尔可夫链,一个样本在上一个的基础上小改一步得来。麻烦就出在这里:相邻的样本长得太像,越接近想要的连续极限越像。抽一万个,真正管用的可能只有几十个。这就是3.3那个临界慢化。
Michael Albergo等人从2019年起换了个思路。训一个网络,把高斯噪声捏成想要的那个分布,然后一次生成一个样本,样本之间互不相干,再配一道校正手续保证结果无偏。
样本独立,就不存在相邻样本相像这回事,临界慢化在原理上被整个绕开。2020年这套做法推广到了规范场。同一个思路用在分子上叫Boltzmann generator,直接抽构象,不用等分子动力学慢慢跑。
判定:原理上是新能力,但要限定清楚。这条路至今仍以低维模型和中小体积为主,真正生产级的四维格点量子色动力学还没换掉传统方法。瓶颈在原理上是拆掉了,可它还没变成人人都在用的工具。
还有一类替下来的是整条流程。
宇宙学的emulator把大规模N体模拟的输出对参数的依赖学下来,做参数扫描时不必每次重跑模拟。它之所以必要,是因为要把巡天数据和宇宙学模型对上,得在参数空间里跑MCMC,每走一步都要一个理论预言,而每个预言背后本来是一次大规模模拟。判定为化解。
探测器快速模拟这一格要特殊对待。它要对付的是3.3那个份额缩水问题:数据量涨一个量级,能分给模拟的计算份额反而在缩。生成模型把量能器簇射的模拟从逐粒子输运变成一次采样,速度提升在两到三个数量级。
这一格已经在生产里跑着了。ATLAS的快速模拟工具AtlFast3把量能器里强子、光子和电子的簇射交给两个部件分担,一个是参数化的FastCaloSimV2,另一个是用生成对抗网络的FastCaloGAN。Run 3期间它已正式投入生产,平均一个事例只花全模拟20%的CPU,比Geant4快3到15倍。FastCaloGAN也是大型高能物理实验里最早进入生产的生成模型工具之一。
这一格因为赶数据率的压力顶在头上,已经很接近新能力。
## 4.4 路线C(定性分析):目前主要是验证
定性分析这条路线上,AI的工作数量不少,产出的性质却相当一致。
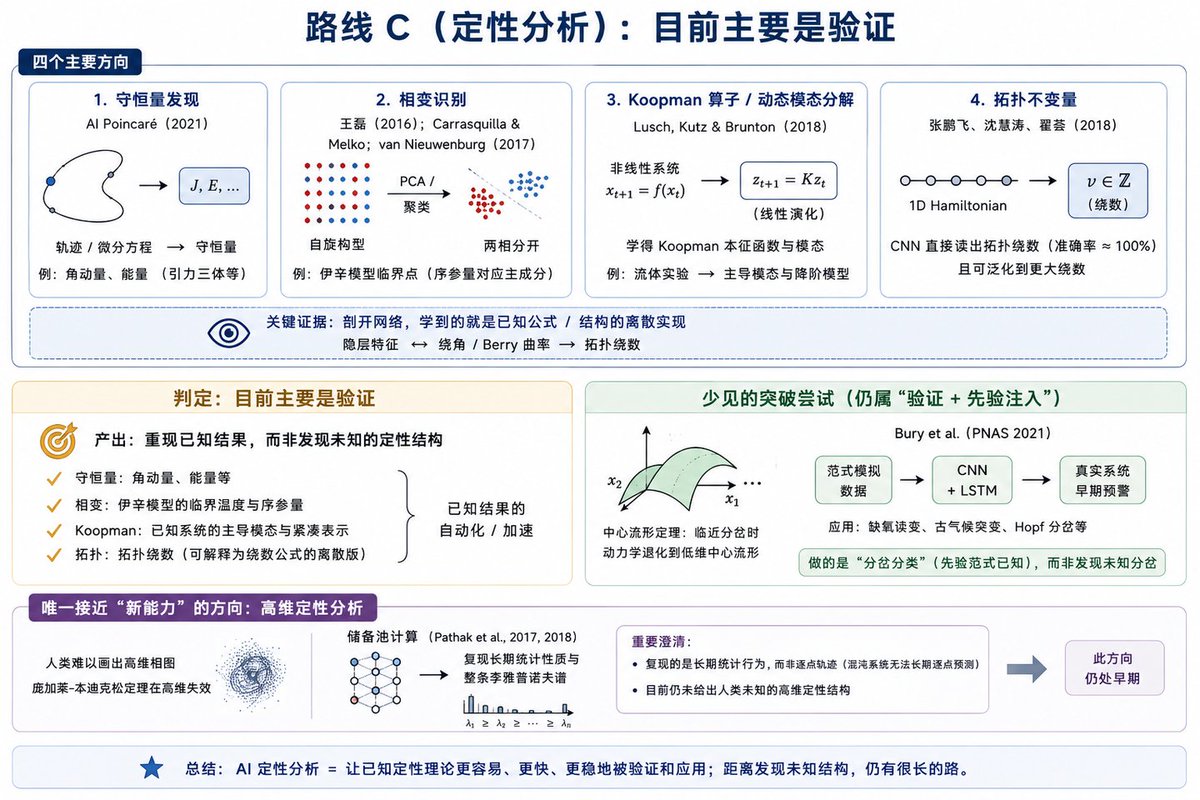
守恒量这一支起步最早。Ziming Liu和Max Tegmark 2021年在《Physical Review Letters》上的AI Poincaré从轨迹数据里自动识别守恒量,在五个哈密顿系统上测试,包括引力三体问题。第二版改成从微分方程出发,还能保证找出来的几个量彼此函数独立。
相变识别那一支的起点是王磊2016年在《Physical Review B》上的工作。他拿主成分分析去处理伊辛模型的自旋构型,聚类就自动把两个相分开了,而且第一主成分对应的正是序参量。第二年Juan Carrasquilla和Roger Melko、以及Evert van Nieuwenburg等人在《Nature Physics》上各发一篇,把这条路推到了监督学习和"用混淆来学"两种做法上。
Koopman算子和动态模态分解这一支在工程上落地得更实。它要找的是一组新坐标,让非线性动力学在这组坐标下变成线性的,之后就能拿线性理论去处理。Bethany Lusch、Nathan Kutz和Steven Brunton 2018年在《Nature Communications》上用改造过的自编码器直接学Koopman本征函数,还用一个辅助网络对付了连续谱这种麻烦情形。从流体实验数据里提取主导模态、给出降阶模型,这套东西在流动控制和结构健康监测里已经在用。
方法都很漂亮。产出呢,主要还是已知结果的重现。AI Poincaré找到的是角动量和能量,无监督相分类划出的是伊辛模型的临界温度,Koopman交出的是对已知系统的一份紧凑描述。
最能说明问题的是拓扑不变量那一支。张鹏飞、沈慧涛和翟荟2018年在《Physical Review Letters》上训网络从一维手征对称绝缘体的哈密顿量直接读出拓扑绕数,准确率接近100%,连训练集里没出现过的更大绕数也照样算对。
关键在于他们没有停在这里,而是把网络剖开看了一遍。中间隐层的输出对应的正是绕角,换一类模型则对应Berry曲率,也就是说网络学到的东西就是绕数公式的离散版本。这是一个很硬的旁证:网络在这里学到的就是那个已知公式,而这一点是打开网络看到的,不是从产出反推出来的。
判定:目前主要是验证。
说句公道话,AI Poincaré的产出不止于此,它同时给出了近似守恒律的失效时标和周期轨道的识别,后者不算已知结果的简单重现。
还有一件工作值得单说,因为它是这条路线上少见的、把定性理论本身当先验硬编码进去的做法。Thomas Bury等人2021年在《美国国家科学院院刊》上用CNN加LSTM做临界转变的早期预警,理论根据正是2.4讲过的中心流形定理:系统临近分岔时,动力学会退化到一个低维中心流形上,拓扑等价于该分岔的范式。
既然如此,网络只要在几种范式的模拟数据上训练,就能迁移到完全不同的真实系统去。他们测的是地中海沉积物里记录的缺氧转变、冰芯里的古气候突变,以及热声系统的Hopf分岔。
这件工作交出的东西仍然是"这个系统正在接近某一类分岔",分岔的分类是现成的,所以判定不变。但它示范了一条路子:把定性理论已经证明的结构当成网络的先验塞进去,别指望网络从零学出来。
唯一可能的出口是高维定性分析。人画不出五十维的相图,庞加莱-本迪克松定理在高维失效,这一格里传统方法本来就没有工具。
这个方向目前最实的证据来自储备池计算。Jaideep Pathak等人2017年在《Chaos》上、2018年在《Physical Review Letters》上的两篇工作表明,一个训练好的储备池能从数据中复现混沌吸引子的统计性质和整条李雅普诺夫谱,包括Kuramoto-Sivashinsky方程这种时空混沌系统。
这里要说清楚:它复现的不是逐点轨迹。混沌系统里,逐点轨迹本来就无法长期预测。它复现的是长期统计行为,而长期统计行为正是定性理论要的那种答案。这是这条路线上目前最接近"新能力"的一格,虽然还没有走到给出人类未知的高维结构。
## 4.5 路线D(有效理论):AI帮不上忙
有效理论构造这条路线,是全文判断最硬的一处,也最容易引来争议。
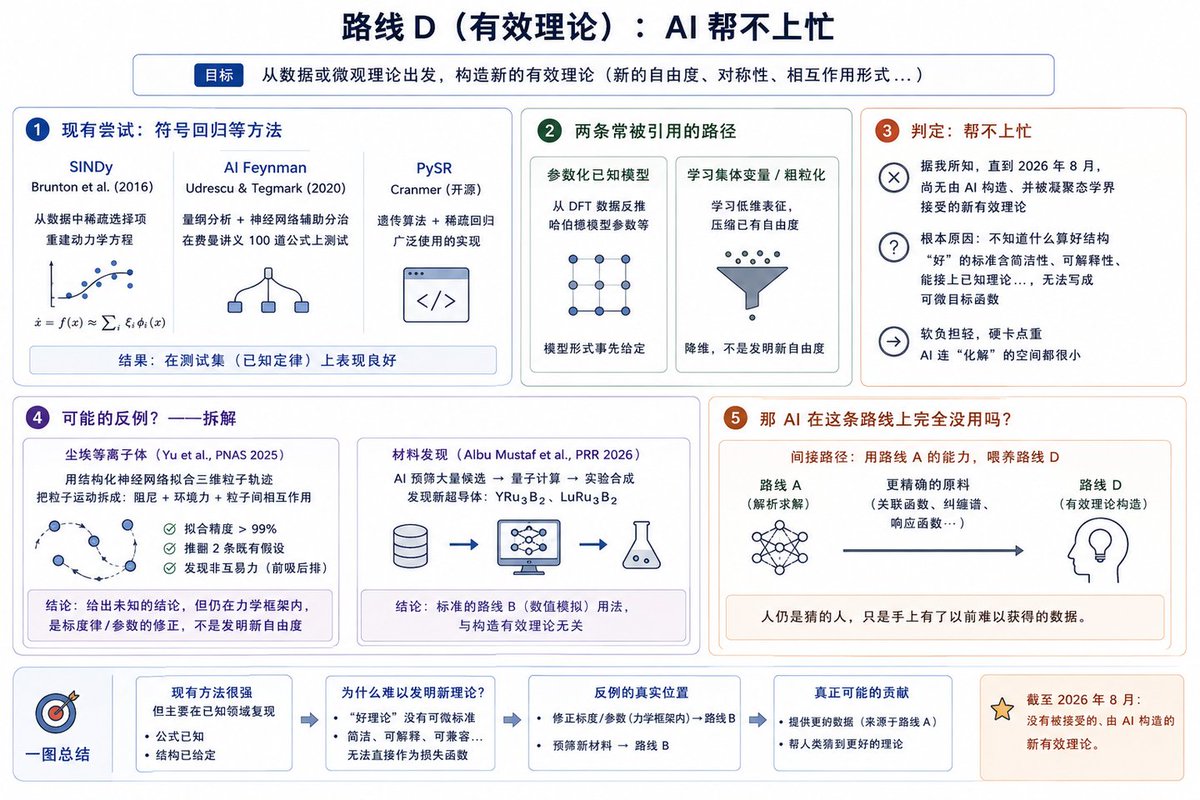
符号回归是主要的尝试方向。Steven Brunton等人2016年在《美国国家科学院院刊》上的SINDy从数据里稀疏地选出动力学方程的项。Silviu-Marian Udrescu和Max Tegmark 2020年在《Science Advances》上的AI Feynman用量纲分析加神经网络辅助的分治法,在费曼物理学讲义的一百道公式上做测试。Miles Cranmer的PySR是目前用得最广的开源实现。
这些方法在测试集上表现很好。问题在于,测试集的内容通常是已知定律。
另外两条常被引用的路径也要拆开看。从密度泛函理论数据反推哈伯德模型参数,做的是参数化一个已知模型,模型的形式是人事先写好的。学习集体变量和粗粒化坐标做的是降维,把已有的自由度压缩,而不是发明新的自由度。
判定:帮不上忙。据我所知,直到2026年8月,还没有一个由AI构造、并被凝聚态学界接受的新有效理论。
这个判定的理由更接近原理问题,不能只靠“再等几年”来搪塞。这条路线的卡点在于不知道什么算好结构,跟“高维对象存不下”是两码事。神经网络的威力建立在一个前提上:有一个可微的目标函数,能沿着梯度往下走。"这个有效理论好不好"没有现成的可微目标函数,因为好的标准里包含简洁性、可解释性、能不能接上别的已知理论,这些东西写不成损失函数。跟上一章的结论呼应,这条路线软负担轻、硬卡点重,所以AI连"化解"的空间都很小。
这里要正面处理一个会被拿来当反例的工作。2025年,Emory大学的Wentao Yu、Eslam Abdelaleem、Ilya Nemenman和Justin Burton在《美国国家科学院院刊》上发表了一项尘埃等离子体研究。他们用结构化神经网络拟合三维粒子轨迹,把粒子运动显式拆成阻尼、环境力和粒子间相互作用三部分,拟合精度超过百分之九十九。结果推翻了两条既有假设:电荷随粒径的标度关系,以及相互作用力随距离衰减的形式对粒径的依赖。他们还给出了非互易力的定量刻画:前面的粒子吸引后面的,后面的却排斥前面的。
这项工作确实给出了此前未知的结论,但它拟合的是力学框架内的相互作用,产出是修正过的标度律和参数。它证明的恰好是我的论点:AI能在已知结构里修正参数和标度,发明新自由度是另一回事。
材料这一侧的对照更明显。2026年,Rose Albu Mustaf等人在《Physical Review Research》上用机器学习筛出两个新超导体YRu3B2和LuRu3B2。做法是用算法从巨大的候选组合里预筛,再对最有希望的做量子力学计算和实验合成。这是标准的路线B(数值模拟)用法,成绩是真的,跟构造有效理论没有关系。
那AI在这条路线上完全没用吗?有一条现实路径,但它是间接的:用路线A(解析求解)的能力去喂路线D(有效理论)。神经量子态在中等体系上能算出更精确的关联函数、纠缠谱、响应函数,这些正是猜有效理论所需要的、以前很难拿到的原料。人还是那个猜的人,只是手上的实验数据多了一批。
## 4.6 路线E(实验与推断):已经进了生产流程的一格
实验与推断这条路线上,AI的成绩数量最多,而且有好几项已经进了生产流程。基于模拟的推断(SBI)直接瞄准上一章说的那个最深的卡点:真实的似然写不出来。Kyle Cranmer、Johann Brehmer和Gilles Louppe 2020年在《美国国家科学院院刊》上的综述把这条线索理清楚了:既然似然写不出来但模拟器跑得动,那就训练一个神经网络,直接从模拟数据里学出后验分布。似然必须可写这个前提被取消了,手工挑summary statistics那一步也跟着取消了。判定:新能力,这是一次方法论层面的解锁,跟速度快慢没有关系。
这件事的影响面比它看上去大。宇宙学的参数推断、系外行星大气的反演、中微子实验的振荡参数拟合,这些方向此前都要先把数据压成几个统计量再做推断,而压缩必然丢信息这件事上一章已经说过。基于模拟的推断把整条链条改成端到端学习,原始数据里的信息可以整体用上。
引力波参数估计是同一套技术最漂亮的落地。Maximilian Dax、Stephen Green等人2021年在《Physical Review Letters》上的DINGO用神经后验估计处理GWTC-1的八个事例,跟标准推断代码的结果高度一致,每个事例的推断时间从一天量级降到20秒。2025年他们在《Nature》上又推进了一步。DINGO-BNS针对双中子星并合,全部17个参数一秒出结果,比最快的传统方法(约一小时)快三个数量级。更关键的是,它能在并合发生之前用部分旋进信号做推断并持续更新,定位精度比低延迟近似方法高约百分之三十。
这一条我倾向于判化解偏新能力。把时间从一天压到20秒是化解。在并合之前给出后验分布,让电磁望远镜提前转过去,这个能力传统方法根本不提供。
LHC的触发与事例重建判定为化解,赶数据率的部分接近新能力。逻辑跟探测器模拟一样:不丢数据本来就做不到,AI让能保住的比例提高。贝叶斯优化做实验设计判定为化解,它在自动化实验平台上省的是机时和人力。
托卡马克的强化学习控制是另一个新能力的例子。Jonas Degrave等人2022年在《Nature》上报告了DeepMind和洛桑联邦理工瑞士等离子体中心在TCV装置上的工作:一个神经网络直接从传感器读数统一指挥控制线圈,免去为每种位形手工设计控制器。实验实现的位形包括负三角形变、雪花位形,以及在同一真空室里同时维持两团独立等离子体的"液滴"。判定:新能力。传统做法要为每一种位形单独设计一套控制器,参数整定靠专家经验,换个位形就得重来一遍。
把成绩摆完,得说一句不太舒服的话。这条路线上AI该解决的基本都解决了,可物理本身并没有跟着往前走。LHC那边,希格斯是2012年的事,十四年过去,超出标准模型的粒子一个也没找到。超对称在最直接的几条搜索道里连影子都没有。触发和重建做得再漂亮,也变不出不存在的粒子。
LIGO那边数字更好看。2026年5月发布的GWTC-5.0把探测总数推到390个,光O4b那一段就新增161个,而且全是双黑洞并合。2025年1月的GW250114是迄今最响的事例,比GW150914响约三倍,它对广义相对论和黑洞的Kerr性质做了单事例最严格的检验:基频测到2%精度,衰减时间测到9%,全都跟广义相对论符合。霍金的面积定理也在这个事例上被验证,两个黑洞初始总面积约24万平方公里,并合后约40万平方公里。390个事例,没有一个偏离广义相对论。
最能说明问题的是缪子反常磁矩。二十年来它是新物理最大的一个迹象,实验值和标准模型预言差了四个多标准差。费米实验室2025年6月给出最终结果,精度做到十亿分之127。然后这个迹象消失了。同一年的理论组更新把领先阶强子真空极化那一项换成格点QCD的结果,标准模型预言整体上移,跟实验之间的张力就没有了。
要注意消掉它的是什么。新数据没有推翻这个迹象,把它抹平的是一次计算精度的提升,而那次计算属于路线B(数值模拟)。
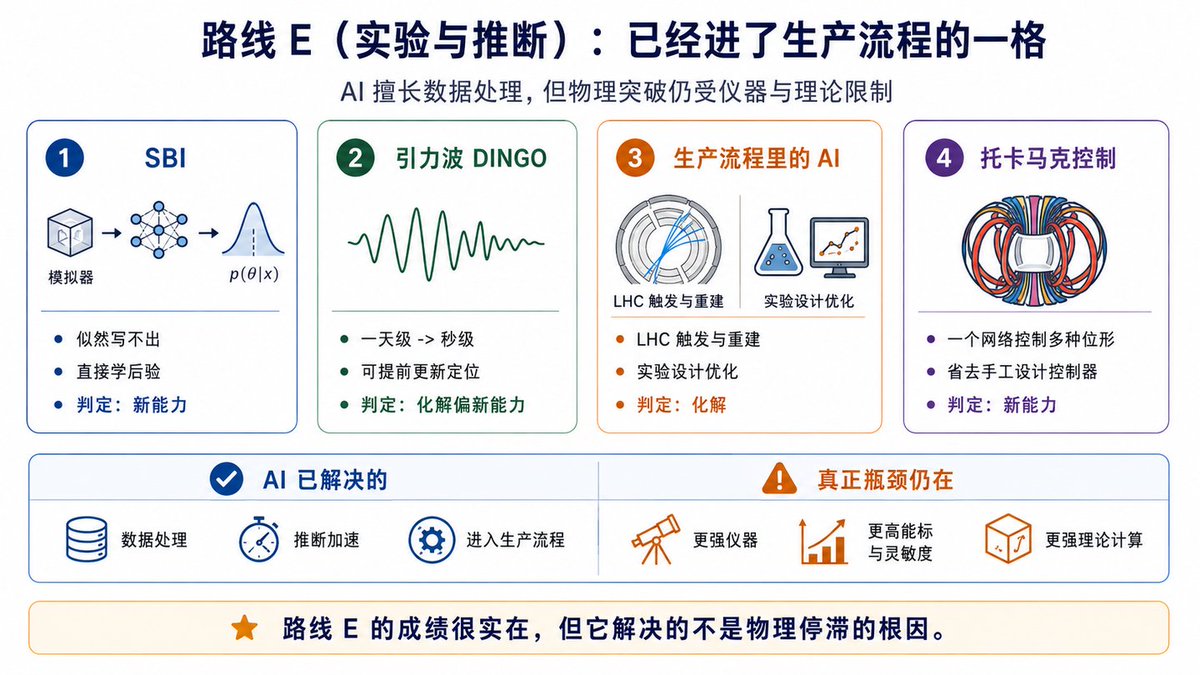
三件事放在一起,路线E(实验与推断)的处境就清楚了。AI拿下的是数据处理那一环,而数据处理从来不是物理停滞的原因。真正的瓶颈在另外两处,AI在这两处都插不上手。一处是仪器本身:想看到更高能标,得造更大的对撞机,想看到更弱的信号,得造更灵敏的干涉仪,那是钱、工程和几十年时间的事。另一处有时落在理论计算这一侧,缪子g-2就是活例子。
第二处反倒有点意思,因为它恰好是路线B(数值模拟)使得上劲的地方。4.3讲的格点场论流模型,攻的正是格点计算里的临界慢化。这条路要是真走通,它对物理结论的影响,可能比路线E(实验与推断)上任何一项数据处理的改进都大。
## 4.7 这一章的总结
五条路线走完,成绩的分布并不均匀,而且不均匀得很有规律。
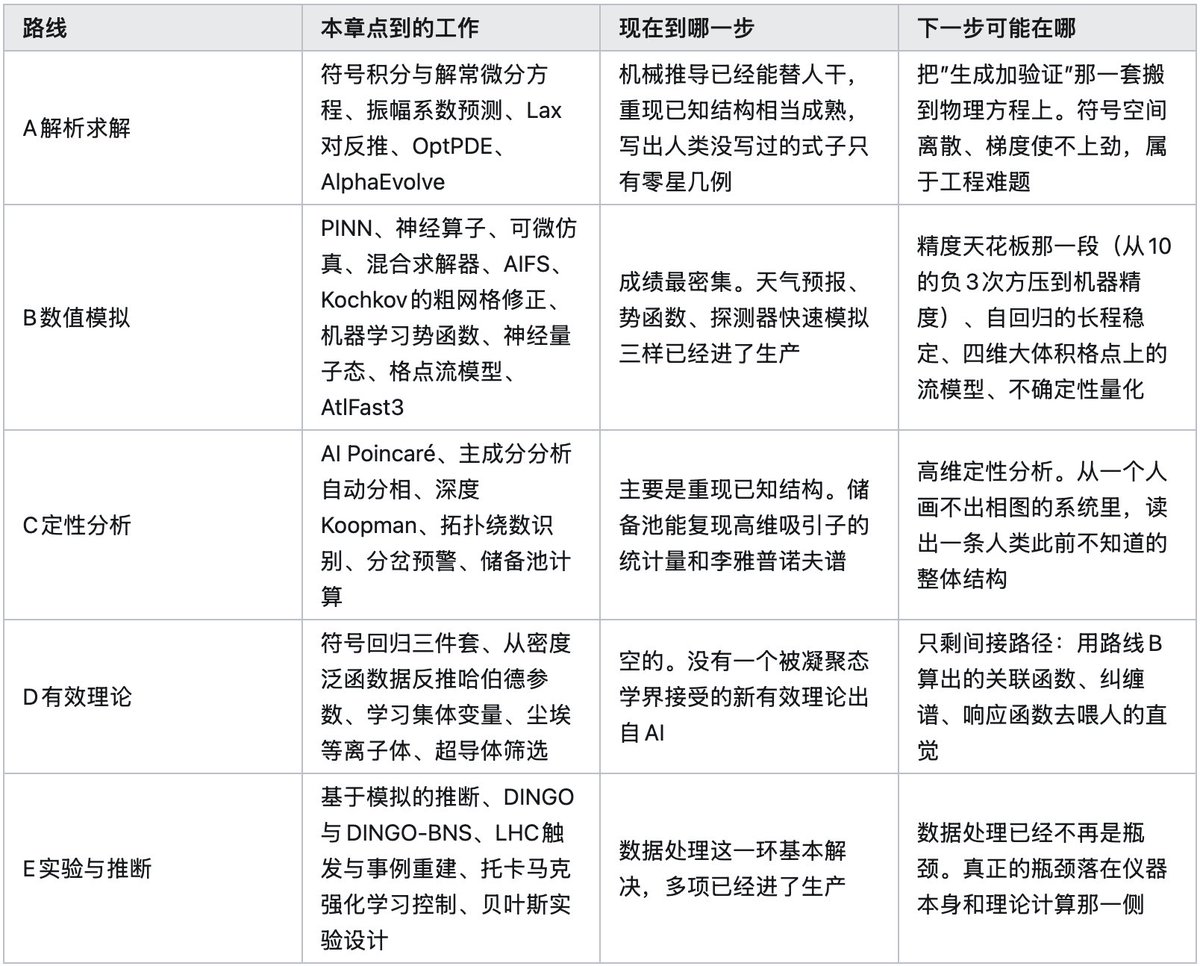
第三列竖着读,已经进生产的全在路线B(数值模拟)和E(实验与推断)。天气预报、势函数、探测器快速模拟、引力波参数估计、托卡马克控制,这几样都不再是论文里的演示,是每天有人在用的工具。路线A(解析求解)和C(定性分析)各有零星战果,路线D(有效理论)连零星都没有。
第四列竖着读,规律更有意思。路线A、B、E的突破口全是工程问题:把已有的方法搬过去、把精度再压几个数量级、造更大的仪器。这些事难,但难在哪儿是清楚的。路线C和D的突破口不一样,那是从没有到有,今天没有人知道该怎么让机器提出一个好的序参量,也没有人知道该怎么让它给出一句关于五十维相图的正确陈述。
这里还藏着一个例外值得记住。路线A(解析求解)的困难按3.7的分类明明是"算不动",成绩却薄得像"猜不出"那一档。原因4.1说过:它要的产出是一个人能读的符号表达式,而神经网络的产出是几百万个权重。凡是要交出一个数的地方,AI大举进入,凡是要交出一个人能读的东西的地方,不管那是公式、结构性陈述还是新方程,AI都很吃力。
化解与新能力落在同一条连续谱上,只是位置不同。转化的临界点在于软负担何时已经把某类问题彻底挡在门外。势函数快四个数量级本身是化解,但因为纳秒级模拟此前完全不可及,它跨过了那个临界点。
由此可以给一个很实用的诊断办法:判断一项AI for Physics工作的价值,先问它对应的是硬卡点还是软负担,再问那个负担有没有大到已经变成卡点。这两问能过滤掉相当一部分看上去很漂亮的工作。
还有一个能自查的办法:把一项工作的成绩换算成"它让什么问题从做不到变成了做得到"。换算得出来的,多半在新能力那一档。换算不出来、只能说成"原来要三天现在要三分钟"的,属于化解。这个换算做起来比直接看加速比诚实得多。
还得交代一句取材。这一章点名的工作大约五十项,而这个领域一年的论文量是几千篇,光机器学习解偏微分方程那一支就够写好几百篇综述。所以上面那张表的第二列是样本,不是清单。每条路线上我挑的都是最能支撑或者最能动摇那条判定的几项。
没被点到的方向绝大多数并非被忽略,而是它们跟已点名的那几项落在同一格,重复列出来并不改变结论。真要动摇某一格的判定,得拿出一项落在别的格子里的工作。
# 五、上面的路线总图装不下的东西
把AI for Physics的内容按路线A到E套完一遍之后,还剩下一批装不进去的。更好的做法是把它们列出来,并说明为什么装不下。
判定边界是这样的:软负担必须附着在某条路线的具体方法论步骤上。不附着的,归本章。
## 5.1 横跨多条路线:物理基础模型
物理基础模型这一支的想法是:既然语言模型能在一个模型里装下大量语言任务,物理能不能也用一个模型覆盖很多系统。
Polymathic AI这个团队是主要推动者。2023年的Multiple Physics Pretraining(McCabe等,arXiv:2310.02994)给出了归一化和嵌入方案,让一个模型同时学多种物理动力学。2024年的The Well是配套数据集,约15TB,覆盖从中子星并合到声波传播到大气分层的多种场景。2025年11月的Walrus(arXiv:2511.15684)是13亿参数的时空Transformer,用自回归方式预测物理场演化。
The Well这个数据集本身值得单说。它把多个来源的模拟数据统一成同一套格式,从中子星并合到声波传播到大气分层都在里面,总量约15TB。它的价值不在算法上,在于让跨物理系统的预训练第一次有了可比的基准。此前每个组用自己的数据,谁也没法跟谁比。
另一条线索是GPhyT,出自Florian Wiesner等人的《Towards a Physics Foundation Model》(arXiv:2509.13805)。这篇的主张更激进:Transformer能从上下文推断支配动力学,对完全没见过的物理系统零样本泛化。训练数据1.8TB,论文报告在多个物理域上最高比专用架构好29倍,50步rollout保持稳定。
这一支为什么装不下这张地图?因为它同时占着路线A(解析求解)和路线B(数值模拟)。按路线归位会把它切碎,而"跨系统通用"恰恰是它的主张本身。
现状评估要说清楚。Walrus自己把适用域限定在流体和类流体系统,证据集中在连续介质那一块。GPhyT仍是预印本,评测基于二维模拟数据。
跨路线的泛化,比如从流体迁移到量子多体,至今没有人验证过。
我对这一支的判断偏保留。语言模型的成功建立在一个条件上:所有自然语言共享同一套统计结构,所以预训练能迁移。物理系统之间共享什么,目前并不清楚。
流体和类流体之间迁移得动,很可能是因为它们背后本来就是同一族方程。跨到量子多体或者格点场论能不能迁移,现在没有证据。
这一支的天花板在哪里,现在还太早。
## 5.2 不附着于任何路线:科研劳动
第二类装不下的东西是AI在科研劳动本身上的应用。
文献处理、代码生成、审稿辅助,这些工作省的是研究者的时间,跟五条路线的方法论没有直接关系。它们的负担落在科研的劳动分工上,不落在某个具体的方法论步骤上。
文献处理这一块的实际效果我自己有体感。做一次跨子领域的文献梳理,过去要花两三周,现在把范围界定清楚之后一两天能拿到一份可用的初稿。剩下的工作是核对每一条引用是不是真的说了那句话,这一步省不掉,而且比想象的费时间。
代码这一块的收益更直接。数值模拟的后处理脚本、数据管线、可视化,这些工作占掉研究生大量时间,智力含量又不高,现在的模型做得相当好。
奥赛题是这一类里最有讨论价值的。2025年的Physics Supernova(arXiv:2509.01659)在国际物理奥林匹克2025年的理论卷上拿到23.5分(满分30),在406名选手中排第14,超过了人类金牌得主的中位数,三道题全部进前百分之十。它的系统设计里加了图像分析工具(读电路图和示意图)和答案复核工具。
要注意两点。它做的只有理论卷,没有实验卷。更重要的是,奥赛题的解法空间是已知的,出题人知道答案,评分标准是事先定好的。
2025年12月的PhysMaster(arXiv:2512.19799)把目标定得更高,直接以自主AI物理学家为名,覆盖高能理论、凝聚态理论到天体物理,论文声称能把数月的劳动压缩到数小时,并能自主探索开放问题。这些是论文自述的主张,尚无第三方复现,写的时候要标清楚。
这里有一个必要的区分。在有标准答案的封闭问题上表现优异,跟在开放问题上产生新结构,是两种不同的能力。奥赛题的解法空间是已知的,路线D(有效理论)的解法空间是要被发明的。前一种能力增长得很快,后一种至今没有证据。
## 5.3 绕开根部:端到端
第三类是从实验数据直接出结果,中间不经过显式方程的做法。
天气预报是最成熟的例子。DeepMind的Remi Lam等人2023年发在《科学》上的GraphCast,跑在0.25度的经纬网格上,一台TPU一分钟出十天预报,在1380个验证指标里有百分之九十超过欧洲中期天气预报中心的确定性业务模型HRES。华为的盘古气象和后来的一批模型走的是同一条路。
这些模型内部没有纳维-斯托克斯方程,训练数据是几十年的ERA5再分析资料。传统数值天气预报要在超算上解一整套流体和热力学方程,一次业务预报占掉的机时是GraphCast的几个数量级。
这一类为什么装不下?第二章那棵树以"有方程"为根,五条路线全都长在这个根上。端到端的做法把根绕开了。它可能很有用,但不在这张地图的坐标系里。
值得记一笔的是,气象界对这件事的态度在分化,而且争论有具体内容。
支持一方指出,GraphCast这类模型已经进了欧洲中期天气预报中心的业务对照,实际预报技巧摆在那里,可复核。质疑一方的核心论据落在训练数据的来源上:ERA5再分析资料本身是用传统数值模式同化观测生成的,所以这些模型学的是一个由方程生成的数据分布。一旦气候统计漂移到训练分布之外,外推能力没有保证。
这个质疑目前既没有被证伪也没有被证实,因为够长的检验窗口还没过去。它跟下一章谈成绩可靠性时要说的是同一件事。
## 5.4 为什么装不下
三类东西装不进来,共同点是它们各自沿着另一条轴在切。
第二章那棵树按方法论切,问的是"你打算用什么方式逼近答案",五条路线就是五种方式。物理基础模型那一支按工具形态切:一个基础模型是一个单位,它内部并不区分自己此刻是在解方程还是在做定性分析。
科研劳动那一类按劳动分工切,问的是"这件事该由谁来做",跟怎么做无关。文献综述从研究生改成模型来写,方法论一步没变,变的是谁在熬夜。端到端那一类则否定了切法的前提,整棵树以有方程为根,而端到端把根绕开了。
不同的切法之间不该硬塞。一个分类体系如果什么都能装,通常说明它什么都没说。落到操作上,判据就是本章开头那一句:一项工作消解的负担,如果附着在某条路线的具体方法论步骤上,它进地图,否则出地图。
更值得说的是反过来的一面。这三类各自对主框架提了一个问题,而且三个问题都不轻。
物理基础模型问的是这张地图的分辨率还能维持多久。哪天要是真有一个模型能跨路线泛化,同一套权重既算流体又算多体波函数、还能给出关于解的结构性陈述,那么按方法论分路线就不再有分辨力,因为模型自己不认这个分法。目前它离这一步还远,证据集中在流体那一块,但这是主框架未来最可能的挑战者。
科研劳动问的是这张地图有没有答错问题。物理学的产出速度究竟受什么限制?如果瓶颈更多落在人力和注意力上,而不在方法论的硬卡点上,那么科研劳动那一类对物理学的实际推动,可能超过第四章列出的多数工作,而这张地图完全看不见它。
端到端问的是第二章那个根本身是不是必然。物理学以方程为根,这是历史选择还是逻辑必然?2.1讲过共同体对"有方程可解"的偏好有多强,而端到端提供了一个反例的雏形:不写方程,也能出一份每天有人用的预报。第六章会回到这一点。
还有一件事得记在旁边。这三类都在快速增长,而路线A到E的格局这几年基本没怎么动。一个分类体系最危险的地方,常常是它装不下的那部分恰好增长最快。这张地图能不能撑住,五年后回头看比现在争论有用。
把话说回来,装不进来并不降低这三类东西的价值。科研劳动那一类对科研效率的实际影响,很可能比第四章列的多数工作都大。这张地图回答的是AI消解了物理学的哪些结构性困难,它回答不了AI让物理学家的日子好过了多少。两个问题都成立,只是不该混在一起答。
# 六、这个领域的形状
## 6.1 三个问题
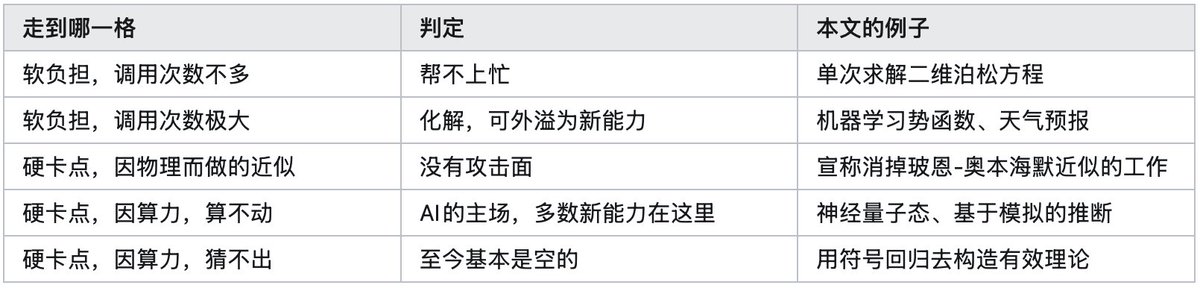
全文的东西可以压成三个问题。按顺序问下来,答到哪一步就停在哪一格,一项AI for Physics的工作值多少钱基本就定位了。
五个终点各自意味着什么,连同本文举过的例子,列在下面。
三问怎么答,各有一个具体办法。
问一的办法是:不用AI,这件事做得到吗?做得到只是慢、贵、繁琐,那是软负担。这一问排最前面,因为文献的大多数落在软负担那一侧,而软负担的价值是真实的,只是要按"化解"来估值,别按"突破"来估值。答完还得追加半句:这个软负担有没有大到已经把整类问题挡在门外。单次求解一个流场做得到,嵌进一个要跑上万次的形状优化循环就做不到了,同一件事,调用次数一变,档位就从化解跳到新能力。
问二的办法是:不做这个近似,物理会看得更模糊,还是更准?玻恩-奥本海默把电子和原子核分开处理,理由是质子重1836倍、时间尺度天然分开,做了这个近似之后你看得更清楚,所以动它没有意义。哈特里-福克把波函数限死成单个斯莱特行列式,丢掉的电子关联是真实存在的物理,扔掉它纯粹因为算力不够,那才是合法攻击面。
问三的办法是:目标能不能写成一个数字?把这个积分算准、把这个能量压低、把这个后验估准,这些都能,机器就有地方使劲。而"什么算好的序参量"里混着简洁、好懂、能不能接上别的已知理论,这些条件写不成损失函数。第四章那张表里成绩的分布,基本就是这条线的投影。
举个例子走一遍。一篇工作说它用神经算子把某个二维流动问题的求解速度提高了一千倍。第一问的答案是软负担,第二问跳过,第三问的答案是算不动那一类,看上去平平无奇。关键全在追加的那半句:如果这个流动问题只需要算一次,那一千倍什么也没改变,成熟求解器本来就够快。如果它嵌在一个要跑上万次的反问题迭代里,那一千倍把一件做不了的事变成了能做的事。
同一篇工作,同一个数字,价值差着一个量级。判据必须落到使用情形上,落到方法名字上没有用。
再走一个反向的例子。一篇工作说它用符号回归从数据里自动发现了一条物理定律。第一问的答案是硬卡点,第二问不适用,因为这里没有什么近似需要消解,第三问的答案是猜不出,警报就响在这里。一旦落进这一格,接下来该问的是:它发现的那条定律,人类此前知道吗?多数情况下答案是知道,那么这项工作的价值是方法验证,不是新发现。这一问筛掉的东西相当多。
还得说清楚这三问的限度。它们判的是一项工作攻的位置对不对,判不了它攻得漂不漂亮。一项落在正确格子里的工作可能做得很糙,一项落在"帮不上忙"格子里的工作也可能技术上极为精致。这三问是估值工具,不是评审意见。
即便如此,它们不需要专业背景就能用。我自己拿这三问筛过不少论文和创业项目的介绍材料,命中率相当高,尤其是第一问,光它一条就能挡掉一大半把化解说成突破的说法。
## 6.2 成绩有多可靠
上面那些判定成立的前提,是文献里报告的成绩大体可信。这个前提要打折扣。
一项成绩从产生到被你读到,中间要过四道关口:喂进去的数据对不对,模型在训练区间之外还灵不灵,报出来的数带不带误差棒,以及拿谁当对照。每一道都可能失真,而失真的方式各不相同。
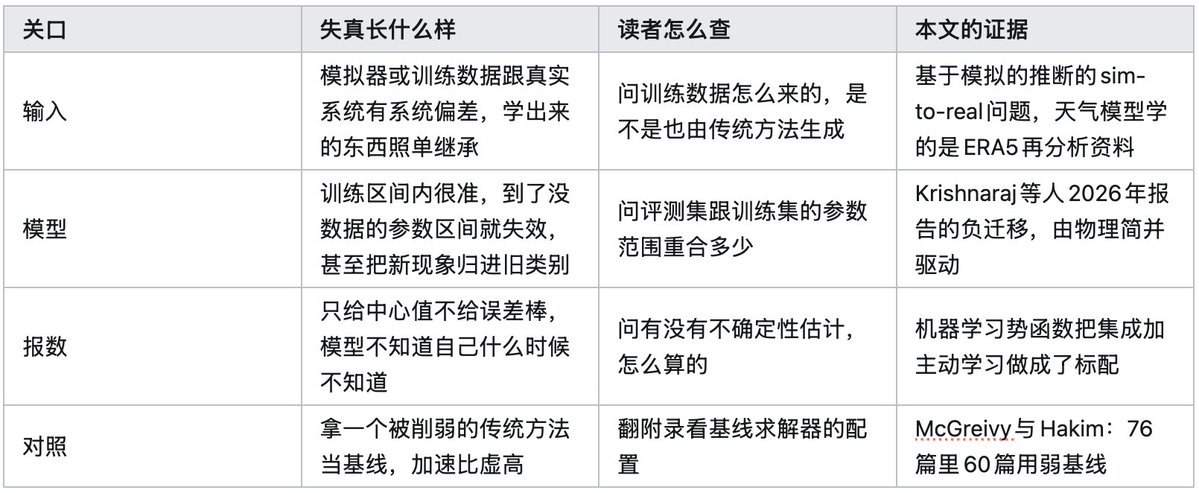
输入这一关最隐蔽。基于模拟的推断有个前提,模拟器本身得是对的,一旦它跟真实实验有系统偏差,训练出来的后验会以很高的置信度给出错误答案。这个问题叫sim-to-real gap,粒子物理和引力波都在做,目前没有通用解法。
天气那一支撞的是同一堵墙的另一面,讲端到端那一节已经说过它的训练数据从哪来。这一关真正难办的地方在于,输入端的偏差不会在验证集上暴露,因为验证集通常跟训练集同源。
模型这一关的问题是外推。机器学习本质上擅长内插,在训练数据覆盖的区域里表现好,而物理研究要的往往是外推,去到没有数据的参数区间。
这一条现在有了很锋利的实证。2026年6月,Veena Krishnaraj等人在《宇宙学与天体粒子物理学杂志》上报告了一个负迁移的例子:在标准宇宙学模型模拟上预训练的网络,迁移到标准模型之外的物理时,反而把新现象归进了已有类别,在大质量中微子的效应和已知参数变化之间分不清。作者的结论值得记住,这种负迁移并不随机,它由模型内部的物理简并驱动。换句话说,先验知识本身成了发现新物理的障碍,迁移学习把计算成本降了十倍以上,代价是模型戴着旧物理的眼镜看新数据。
报数这一关是四道里唯一有成熟解法的。一个模型能不能进生产流程,分水岭往往就在这里,机器学习势函数之所以能成为材料模拟的日常工具,很大程度上是因为这一支很早就把不确定性估计做成了标配。
具体做法值得别的方向抄:用集成模型估计不确定性,也就是训练几个初始化不同的网络,看它们在同一个构型上的预测分歧有多大,分歧大的构型自动送去做第一性原理计算,算完加进训练集再训一轮。这套主动学习的闭环让模型知道自己什么时候不知道。做不到这一点的方法,物理学家不敢用,一个不给误差棒的预测在物理里等于没有预测。
对照这一关最好查,也最普遍。讲机器学习解偏微分方程那一节给过数字,76篇里有60篇比的是被削弱过的基线。好在这一关的检查成本最低:翻到论文附录,看它把基线求解器配成了什么样,用的哪一档网格、哪一种预条件、跑在什么硬件上。这几项但凡含糊,加速比就得打问号。
四道关口的顺序有意义:越靠前的关口,出了问题越难被发现。基线不公平,翻一翻附录就能查出来。模拟器误设或者训练数据本身带着旧物理的印记,可能整个领域一起错好几年,而且错得很自洽。
## 6.3 哪些格子会先被填满
回到开头那个不均匀的分布。
AI的成绩精确落在两个地方:因算力而做的妥协最深处,以及软负担最重处。势函数、代理模型、快速模拟、基于模拟的推断、实时控制,全部符合这个描述。这不是巧合,这是神经网络这个工具的能力边界跟物理学卡点结构的一次对齐。
路线D(有效理论)是最有说服力的反例。它的硬卡点是全部五条路线里最深的,AI在那里却帮不上忙。原因就在于那个卡点跟算力无关。选自由度、找序参量、判断什么算好结构,这些事情的困难不在于计算量,在于没有可优化的目标。
顺着这个逻辑往下推,可以对未来给出一些不算激进的判断。
高维偏微分方程、部分观测下的数据同化、参数族反复求解这三格,会先被填满,因为它们的性质跟已经成功的那几格完全相同。这里的问题是工程问题,是数据、算力、基准规范的问题。
反过来,路线C(定性分析)里的高维那一格是值得盯着的空白。储备池计算已经证明机器学习能抓住混沌吸引子的统计结构。如果有人能在一个人类从未画出过相图的高维系统里,给出一个人能理解的结构性陈述,那会是这条路线上第一个真正的新能力。目前还没有。
路线A(解析求解)那一格值得单独盯着,理由跟别处不同。它有一个别的路线没有的东西:便宜的验货员。解写得对不对,代回去一验就知道,守恒量有几个数得出来,算法对不对跑一遍就知道。
有验货员,机器就能放开了乱猜,猜错的当场扔掉,AlphaEvolve和OptPDE都是这么跑起来的。所以这一格的障碍是搜索空间离散、梯度使不上劲,属于工程难题。它薄,但不是没门。
路线D(有效理论)那一格,我判断它会空得更久。这里需要的东西超出了当前范式:一个能对"什么算好结构"做出判断的系统,而这个判断标准本身没法写成损失函数。有人会说大语言模型可能提供另一条路,因为它们的训练目标里本来就包含了大量人类关于"什么算好解释"的判断。这个想法值得试,但PhysMaster这一类工作目前给出的证据还停留在论文自述阶段。
还有一件事值得记在旁边。2025年,Los Alamos的Duc Truong和新墨西哥大学的Dimiter Petsev等人在《Physical Review Materials》上发表了THOR,用张量列车交叉插值算统计物理里的高维构型积分,比分子动力学的间接算法快约400倍。这套方法里没有神经网络。
THOR攻击的是同一个维数灾难。这说明我在第四章判为"AI新能力"的那些格子,有一部分功劳应该记在"高维数值方法"这个更大的类别上,神经网络只是其中一种实现。这对全文的判据是个有益的压力测试:真正被消解的是维数灾难,谁来消解是次要的。
# 七、小结
AI在物理里的成绩分布看上去古怪,是因为大多数人按物理子领域去看它。换成方法论视角,分布立刻清楚:凡是要处理一个高维函数的地方,AI进去了。凡是要发明一个人能理解的结构的地方,AI还在门外。
这条界线照出来的其实是物理学自己。
物理学有两类困难,长期混在一起说,都叫难。一类难在算不动,波函数存不下,路径积分采不了,后验分布积不出。另一类难在不知道该找什么,什么是好的序参量,哪个自由度该拿来当主角,五十维的相图整体长什么样。
过去没人需要把这两类分得太清楚,因为没有一个工具能精确地只解决其中一类。AI是第一个。它在前一类上大举推进,在后一类上原地不动,这个反差等于替物理学的困难做了一次普查:哪些只是资源问题,哪些是判断力问题。
对一个正在选题的人来说,这个结论比"AI能不能做物理"有用得多。如果你手上的困难能写成一个数字,那就去看看AI那一侧有没有现成的东西可用,多半省得下时间。如果你手上的困难是"我不知道该找什么",那么这件事到今天为止,仍然只能靠你自己。
这张地图最可能错在两处。一处是有效理论那一格全空这个判断,只要出现一个由AI构造、被凝聚态学界接受的新有效理论,这一格就得重写,而这也是全文我最没把握的一条。另一处是把功劳记在AI头上这个归因,THOR那个例子已经提醒过,真正被消解的是维数灾难,谁来消解是次要的,如果张量网络或者量子计算在同样的格子里给出同样的成绩,全文的主语就该换掉。
还有一层是时效。第四章那些判定是2026年夏天的一张快照,而成绩最密集的那几格变化很快。五年后这一章还剩多少站得住,我没有把握。
这条界线不会自己移动。要让它移动,需要的是一个我们目前还不知道怎么写的目标函数。单纯把模型做大,解决不了这个问题。
## 作者其它文章(选)
- 什么是MoE和MMoE模型?
- 自动驾驶的十年:那些空头支票是怎么开出来的
- 量子力学研究史(中):场、无穷大与标准模型
- FDE介绍和入门:一个被AI重新激活的老岗位
- 大数据概念兴衰史
- 量子力学研究史(上):从黑体辐射到希尔伯特空间
- 纳维-斯托克斯方程:一个方程背后的多重难题
- 算法交易是怎么吃掉华尔街的
- 顶尖VC 2026年以来动向观察
- 美国数学教育和研究现状
- 一篇文章讲清楚美国的移民系统
- 一文讲清楚美国医疗系统
- 细说美国的华人老钱家族
- 美国的犹太人和华人分别抢到了什么资源?详细分析
- 一篇文章看懂美国教育全生态
- AI圈大V名单(名单不断扩充中)
- 什么是控制论?控制论是AI的上辈子吗?
- 祖父积分学概论
- 教宗良十四世论人工智能(精华版)
- 什么是希尔伯特的第六问题?这个问题重要吗?
## 本文参考文献
综述与全景
- Machine learning and the physical sciences - Carleo等,Rev. Mod. Phys. 91, 045002 (2019)
- Physics-informed machine learning - Karniadakis等,Nat. Rev. Phys. 3, 422 (2021)
- Scientific discovery in the age of artificial intelligence - Wang等,Nature 620, 47 (2023)
- Artificial Intelligence for Science in Quantum, Atomistic, and Continuum Systems - Xuan Zhang等,arXiv:2307.08423
- Interpretable Machine Learning in Physics: A Review - Wetzel等,arXiv:2503.23616
- From AI for Science to Agentic Science - Jiaqi Wei等,arXiv:2508.14111
- A Living Review of Machine Learning for Particle Physics - Feickert与Nachman
路线A:解析求解
- OptPDE: Discovering Novel Integrable Systems via AI-Human Collaboration - Kantamneni, Liu与Tegmark,arXiv:2405.04484(2024),四族方程中三族为文献所无
- AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms - DeepMind(2025),4×4复矩阵乘法48次标量乘法
- Deep Learning for Symbolic Mathematics - Lample与Charton,arXiv:1912.01412(2019)
- Transforming the Bootstrap: Using Transformers to Compute Scattering Amplitudes in Planar N=4 Super Yang-Mills - Cai, Merz, Charton等,arXiv:2405.06107(2024)
- Simplifying Polylogarithms with Machine Learning - Dersy, Schwartz与Zhang,arXiv:2206.04115(2022)
- Lax-Pair-FIND: Discovering Lax pair from scarce data via deep learning - Chaos 35, 113120 (2025)
- Nobel Lecture: Electronic structure of matter, wave functions and density functionals - Walter Kohn (1998),指数墙与"波函数不再是合法科学概念"的论证
- Inhomogeneous Electron Gas - Hohenberg与Kohn, Phys. Rev. 136, B864 (1964)
- Divergence of Perturbation Theory in Quantum Electrodynamics - Freeman Dyson, Phys. Rev. 85, 631 (1952)
- Revised and Improved Value of the QED Tenth-Order Electron Anomalous Magnetic Moment - Aoyama, Hayakawa, Kinoshita与Nio,第五阶12672张费曼图
- Quantum Mechanics of Many-Electron Systems - Dirac, Proc. R. Soc. A 123, 714 (1929)
- Solving the quantum many-body problem with artificial neural networks - Carleo与Troyer, Science 355, 602 (2017)
- Ab initio solution of the many-electron Schrödinger equation with deep neural networks - Pfau等(FermiNet), Phys. Rev. Research 2, 033429 (2020)
- Deep-neural-network solution of the electronic Schrödinger equation - Hermann, Schätzle与Noé(PauliNet), Nat. Chem. 12, 891 (2020)
- Empowering deep neural quantum states through efficient optimization - Chen与Heyl, Nature Physics (2024)
- Flow-based generative models for Markov chain Monte Carlo in lattice field theory - Albergo, Kanwar与Shanahan, PRD 100, 034515 (2019)
- Equivariant Flow-Based Sampling for Lattice Gauge Theory - Kanwar等, PRL 125, 121601 (2020)
路线B:数值模拟
- Über die partiellen Differenzengleichungen der mathematischen Physik - Courant, Friedrichs与Lewy,Math. Ann. 100, 32 (1928)
- A method for the numerical calculation of hydrodynamic shocks - von Neumann与Richtmyer,J. Appl. Phys. 21, 232 (1950)
- Difference method for numerical calculation of discontinuous solutions of the equations of hydrodynamics - Godunov,Mat. Sb. 47, 271 (1959)
- Systems of conservation laws - Lax与Wendroff,Comm. Pure Appl. Math. 13, 217 (1960)
- Approximate Riemann solvers, parameter vectors, and difference schemes - Roe,J. Comput. Phys. 43, 357 (1981)
- Physics-informed neural networks - Raissi, Perdikaris与Karniadakis, J. Comput. Phys. 378, 686 (2019)
- Fourier Neural Operator for Parametric Partial Differential Equations - Li等,arXiv:2010.08895
- Learning nonlinear operators via DeepONet - Lu, Jin与Karniadakis, Nat. Mach. Intell. 3, 218 (2021)
- Machine learning-accelerated computational fluid dynamics - Kochkov, Hoyer等, PNAS 118, e2101784118 (2021),粗网格学修正,快40到80倍且长时间稳定
- ECMWF's AI forecasts become operational - ECMWF(2025年2月25日),AIFS投入业务运行
- AIFS Single 1.1.0: an update to ECMWF's machine-learned weather forecast model - Geosci. Model Dev. 19, 4703 (2026)
- Characterizing possible failure modes in physics-informed neural networks - Krishnapriyan等, NeurIPS (2021),PINN在刚性问题上的优化失败
- Weak baselines and reporting biases lead to overoptimism in machine learning for fluid-related PDEs - McGreivy与Hakim, Nat. Mach. Intell. (2024)
- AtlFast3: Fast Simulation in ATLAS for LHC Run 3 and Beyond - ATLAS合作组,EPJ Web Conf.(2025),FastCaloGAN在Run 3投入生产
- E(3)-equivariant graph neural networks for data-efficient and accurate interatomic potentials - Batzner等(NequIP), Nat. Commun. 13, 2453 (2022)
- MACE: Higher Order Equivariant Message Passing Neural Networks - Batatia等,arXiv:2206.07697
- Optimizing the ATLAS Geant4 detector simulation software - ATLAS合作组,探测器模拟的CPU占比
- Summary of the trigger systems of the LHC experiments - ALICE/ATLAS/CMS/LHCb触发系统,40 MHz到1 kHz
路线C:定性分析
- Mémoire sur les courbes définies par une équation différentielle - Poincaré, J. Math. Pures Appl. 7, 375 (1881)
- Deterministic Nonperiodic Flow - Lorenz, J. Atmos. Sci. 20, 130 (1963)
- Invariante Variationsprobleme - Emmy Noether, Nachr. Ges. Wiss. Göttingen (1918),诺特定理原文
- The formation of a blast wave by a very intense explosion - G. I. Taylor, Proc. R. Soc. A 201, 175 (1950),点爆炸标度律与Trinity当量估计
- Quantized Hall Conductance in a Two-Dimensional Periodic Potential - Thouless, Kohmoto, Nightingale与den Nijs(TKNN), PRL 49, 405 (1982)
- Method for Solving the Korteweg-deVries Equation - Gardner, Greene, Kruskal与Miura, PRL 19, 1095 (1967),逆散射变换
- Integrals of nonlinear equations of evolution and solitary waves - Peter Lax, Comm. Pure Appl. Math. 21, 467 (1968),Lax对
- Existence of collisional trajectories of Mercury, Mars and Venus with the Earth - Laskar与Gastineau, Nature 459, 817 (2009)
- Stability of the solar system - Scholarpedia,内太阳系李雅普诺夫时间约五百万年
- Machine Learning Conservation Laws from Trajectories - Liu与Tegmark(AI Poincaré), PRL 126, 180604 (2021)
- Using machine learning to replicate chaotic attractors and calculate Lyapunov exponents from data - Pathak等, Chaos 27, 121102 (2017)
- Model-Free Prediction of Large Spatiotemporally Chaotic Systems from Data - Pathak等, PRL 120, 024102 (2018)
- Discovering Phase Transitions with Unsupervised Learning - 王磊, Phys. Rev. B 94, 195105 (2016),主成分分析自动分相,第一主成分对应序参量
- Machine learning phases of matter - Carrasquilla与Melko, Nat. Phys. 13, 431 (2017)
- Machine Learning Topological Invariants with Neural Networks - 张鹏飞、沈慧涛与翟荟, PRL 120, 066401 (2018),剖开网络确认它学到的是绕数公式
- Deep learning for universal linear embeddings of nonlinear dynamics - Lusch, Kutz与Brunton, Nat. Commun. (2018)
- Deep learning for early warning signals of tipping points - Bury等, PNAS 118, e2106140118 (2021),以中心流形定理为先验
- AI Poincaré 2.0: Machine Learning Conservation Laws from Differential Equations - Liu, Madhavan与Tegmark,arXiv:2203.12610
路线D:有效理论构造
- On the Theory of Superconductivity - Ginzburg与Landau (1950),金兹堡-朗道自由能
- Theory of Superconductivity - Bardeen, Cooper与Schrieffer, Phys. Rev. 108, 1175 (1957)
- Nobel Lecture: Type-II superconductors and the vortex lattice - Abrikosov, Rev. Mod. Phys. 76, 975 (2004),涡旋格子的预言与实验证实
- The theory of a Fermi liquid - 朗道费米液体理论与液氦3的比热
- Electron correlations in narrow energy bands - Hubbard, Proc. R. Soc. A 276, 238 (1963)
- Anomalous Quantum Hall Effect - Laughlin, PRL 50, 1395 (1983),分数电荷的试探波函数
- Observation of the e/3 Fractionally Charged Laughlin Quasiparticle - Saminadayar等, PRL 79, 2526 (1997)
- Direct observation of a fractional charge - de-Picciotto等, Nature 389, 162 (1997)
- More Is Different - Anderson, Science 177, 393 (1972)
- Discovering governing equations from data by sparse identification - Brunton, Proctor与Kutz(SINDy), PNAS 113, 3932 (2016)
- AI Feynman: A physics-inspired method for symbolic regression - Udrescu与Tegmark, Sci. Adv. 6, eaay2631 (2020)
- Physics-tailored machine learning reveals unexpected physics in dusty plasmas - Yu, Abdelaleem, Nemenman与Burton, PNAS 122, e2505725122 (2025)
路线E:实验、观测与推断
- Measurement of the anomalous precession frequency of the muon in the Fermilab Muon g-2 Experiment - Muon g-2合作组, PRD 103, 072002 (2021),硬件盲法的具体做法
- Evidence for Oscillation of Atmospheric Neutrinos - 超级神冈合作组, PRL 81, 1562 (1998)
- Measurement of the Rate of interactions Produced by 8B Solar Neutrinos at SNO - SNO合作组, PRL 87, 071301 (2001)
- The frontier of simulation-based inference - Cranmer, Brehmer与Louppe, PNAS 117, 30055 (2020)
- Real-Time Gravitational Wave Science with Neural Posterior Estimation - Dax, Green等(DINGO), PRL 127, 241103 (2021)
- Real-time inference for binary neutron star mergers using machine learning - Dax等(DINGO-BNS), Nature (2025)
- Magnetic control of tokamak plasmas through deep reinforcement learning - Degrave等, Nature 602, 414 (2022)
- Measurement of the Positive Muon Anomalous Magnetic Moment to 127 ppb - Muon g-2合作组(2025年6月),最终结果
- Fermilab's final word on muon g-2 - CERN Courier,格点QCD使标准模型预言上移、张力消失
- GWTC-5.0: Observations from the Second Part of the Fourth LIGO-Virgo-KAGRA Observing Run - arXiv:2605.27225(2026),累计390个事例
- Black Hole Spectroscopy and Tests of General Relativity with GW250114 - arXiv:2509.08099(2025),单事例最严格的广义相对论检验
物理基础模型与科研劳动
- Multiple Physics Pretraining for Physical Surrogate Models - McCabe等,arXiv:2310.02994
- Walrus: A Cross-Domain Foundation Model for Continuum Dynamics - Polymathic AI,arXiv:2511.15684
- Towards a Physics Foundation Model - Wiesner等(GPhyT),arXiv:2509.13805
- Physics Supernova: AI Agent Matches Elite Gold Medalists at IPhO 2025 - arXiv:2509.01659
- PhysMaster: Building an Autonomous AI Physicist - arXiv:2512.19799
成绩可靠性与其它
- Transfer learning beyond the standard model - Krishnaraj等,JCAP 2026(06), 026 (2026)
- Machine-learning-guided discovery of kagome superconductors YRu3B2 and LuRu3B2 - Mustaf等,Phys. Rev. Research 8, 023308 (2026)
- Breaking the curse of dimensionality: Solving configurational integrals for crystalline solids by tensor networks - Truong等,Phys. Rev. Materials 9, 083802 (2025)
## 相关链接
- [snowboat](https://x.com/snowboat84)
- [@snowboat84](https://x.com/snowboat84)
- [9.5K](https://x.com/snowboat84/status/2085946919277461512/analytics)
- [什么是MoE和MMoE模型?](https://x.com/snowboat84/status/2085586981459828939)
- [自动驾驶的十年:那些空头支票是怎么开出来的](https://x.com/snowboat84/status/2085206937462002072)
- [量子力学研究史(中):场、无穷大与标准模型](https://x.com/snowboat84/status/2084791538933194873)
- [FDE介绍和入门:一个被AI重新激活的老岗位](https://x.com/snowboat84/status/2084428243512537562)
- [大数据概念兴衰史](https://x.com/snowboat84/status/2083346249663844656)
- [量子力学研究史(上):从黑体辐射到希尔伯特空间](https://x.com/snowboat84/status/2083063168981737698)
- [纳维-斯托克斯方程:一个方程背后的多重难题](https://x.com/snowboat84/status/2082618473776329127)
- [算法交易是怎么吃掉华尔街的](https://x.com/snowboat84/status/2082257654353895482)
- [顶尖VC 2026年以来动向观察](https://x.com/snowboat84/status/2081903835833147732)
- [美国数学教育和研究现状](https://x.com/snowboat84/status/2080872418999156980)
- [一篇文章讲清楚美国的移民系统](https://x.com/snowboat84/status/2057980486501433383)
- [一文讲清楚美国医疗系统](https://x.com/snowboat84/status/2055081426744422697)
- [细说美国的华人老钱家族](https://x.com/snowboat84/status/2062326581776011623)
- [美国的犹太人和华人分别抢到了什么资源?详细分析](https://x.com/snowboat84/status/2063049247805837815)
- [一篇文章看懂美国教育全生态](https://x.com/snowboat84/status/2054359249917210633)
- [AI圈大V名单(名单不断扩充中)](https://x.com/snowboat84/status/2069206740546343372)
- [什么是控制论?控制论是AI的上辈子吗?](https://x.com/snowboat84/status/2064496706042069340)
- [祖父积分学概论](https://x.com/snowboat84/status/2056533111983493136)
- [教宗良十四世论人工智能(精华版)](https://x.com/snowboat84/status/2059434342745866391)
- [什么是希尔伯特的第六问题?这个问题重要吗?](https://x.com/snowboat84/status/2077249534049259588)
- [Machine learning and the physical sciences](https://journals.aps.org/rmp/abstract/10.1103/RevModPhys.91.045002)
- [Physics-informed machine learning](https://www.nature.com/articles/s42254-021-00314-5)
- [Scientific discovery in the age of artificial intelligence](https://www.nature.com/articles/s41586-023-06221-2)
- [Artificial Intelligence for Science in Quantum, Atomistic, and Continuum Systems](https://arxiv.org/abs/2307.08423)
- [Interpretable Machine Learning in Physics: A Review](https://arxiv.org/abs/2503.23616)
- [From AI for Science to Agentic Science](https://arxiv.org/abs/2508.14111)
- [A Living Review of Machine Learning for Particle Physics](https://arxiv.org/abs/2102.02770)
- [OptPDE: Discovering Novel Integrable Systems via AI-Human Collaboration](https://arxiv.org/abs/2405.04484)
- [AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms](https://deepmind.google/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/)
- [Deep Learning for Symbolic Mathematics](https://arxiv.org/abs/1912.01412)
- [Transforming the Bootstrap: Using Transformers to Compute Scattering Amplitudes in Planar N=4 Super Yang-Mills](https://arxiv.org/abs/2405.06107)
- [Simplifying Polylogarithms with Machine Learning](https://arxiv.org/abs/2206.04115)
- [Lax-Pair-FIND: Discovering Lax pair from scarce data via deep learning](https://pubs.aip.org/aip/cha/article/35/11/113120/3372350/)
- [Nobel Lecture: Electronic structure of matter, wave functions and density functionals](https://www.nobelprize.org/prizes/chemistry/1998/kohn/lecture/)
- [Inhomogeneous Electron Gas](https://journals.aps.org/pr/abstract/10.1103/PhysRev.136.B864)
- [Divergence of Perturbation Theory in Quantum Electrodynamics](https://journals.aps.org/pr/abstract/10.1103/PhysRev.85.631)
- [Revised and Improved Value of the QED Tenth-Order Electron Anomalous Magnetic Moment](https://arxiv.org/abs/1712.06060)
- [Quantum Mechanics of Many-Electron Systems](https://royalsocietypublishing.org/doi/10.1098/rspa.1929.0094)
- [Solving the quantum many-body problem with artificial neural networks](https://www.science.org/doi/10.1126/science.aag2302)
- [Ab initio solution of the many-electron Schrödinger equation with deep neural networks](https://journals.aps.org/prresearch/abstract/10.1103/PhysRevResearch.2.033429)
- [Deep-neural-network solution of the electronic Schrödinger equation](https://www.nature.com/articles/s41557-020-0544-y)
- [Empowering deep neural quantum states through efficient optimization](https://www.nature.com/articles/s41567-024-02566-1)
- [Flow-based generative models for Markov chain Monte Carlo in lattice field theory](https://journals.aps.org/prd/abstract/10.1103/PhysRevD.100.034515)
- [Equivariant Flow-Based Sampling for Lattice Gauge Theory](https://journals.aps.org/prl/abstract/10.1103/PhysRevLett.125.121601)
- [Über die partiellen Differenzengleichungen der mathematischen Physik](https://eudml.org/doc/159283)
- [A method for the numerical calculation of hydrodynamic shocks](https://doi.org/10.1063/1.1699639)
- [Difference method for numerical calculation of discontinuous solutions of the equations of hydrodynamics](https://www.mathnet.ru/eng/sm4873)
- [Systems of conservation laws](https://doi.org/10.1002/cpa.3160130205)
- [Fourier Neural Operator for Parametric Partial Differential Equations](https://arxiv.org/abs/2010.08895)
- [Learning nonlinear operators via DeepONet](https://www.nature.com/articles/s42256-021-00302-5)
- [Machine learning-accelerated computational fluid dynamics](https://www.pnas.org/doi/10.1073/pnas.2101784118)
- [ECMWF's AI forecasts become operational](https://www.ecmwf.int/en/about/media-centre/news/2025/ecmwfs-ai-forecasts-become-operational)
- [AIFS Single 1.1.0: an update to ECMWF's machine-learned weather forecast model](https://gmd.copernicus.org/articles/19/4703/2026/)
- [Characterizing possible failure modes in physics-informed neural networks](https://proceedings.neurips.cc/paper/2021/file/df438e5206f31600e6ae4af72f2725f1-Paper.pdf)
- [Weak baselines and reporting biases lead to overoptimism in machine learning for fluid-related PDEs](https://www.nature.com/articles/s42256-024-00897-5)
- [AtlFast3: Fast Simulation in ATLAS for LHC Run 3 and Beyond](https://cds.cern.ch/record/2924894)
- [E(3)-equivariant graph neural networks for data-efficient and accurate interatomic potentials](https://www.nature.com/articles/s41467-022-29939-5)
- [MACE: Higher Order Equivariant Message Passing Neural Networks](https://arxiv.org/abs/2206.07697)
- [Optimizing the ATLAS Geant4 detector simulation software](https://iopscience.iop.org/article/10.1088/1742-6596/3206/1/012035)
- [Summary of the trigger systems of the LHC experiments](https://iopscience.iop.org/article/10.1088/1361-6471/adaadc)
- [Mémoire sur les courbes définies par une équation différentielle](https://eudml.org/doc/235914)
- [Deterministic Nonperiodic Flow](https://journals.ametsoc.org/view/journals/atsc/20/2/1520-0469_1963_020_0130_dnf_2_0_co_2.xml)
- [Invariante Variationsprobleme](https://eudml.org/doc/59024)
- [The formation of a blast wave by a very intense explosion](https://royalsocietypublishing.org/doi/10.1098/rspa.1950.0049)
- [Quantized Hall Conductance in a Two-Dimensional Periodic Potential](https://journals.aps.org/prl/abstract/10.1103/PhysRevLett.49.405)
- [Method for Solving the Korteweg-deVries Equation](https://journals.aps.org/prl/abstract/10.1103/PhysRevLett.19.1095)
- [Integrals of nonlinear equations of evolution and solitary waves](https://onlinelibrary.wiley.com/doi/10.1002/cpa.3160210503)
- [Existence of collisional trajectories of Mercury, Mars and Venus with the Earth](https://www.nature.com/articles/nature08096)
- [Stability of the solar system](http://www.scholarpedia.org/article/Stability_of_the_solar_system)
- [Machine Learning Conservation Laws from Trajectories](https://journals.aps.org/prl/abstract/10.1103/PhysRevLett.126.180604)
- [Using machine learning to replicate chaotic attractors and calculate Lyapunov exponents from data](https://pubs.aip.org/aip/cha/article/27/12/121102/135382/)
- [Model-Free Prediction of Large Spatiotemporally Chaotic Systems from Data](https://journals.aps.org/prl/abstract/10.1103/PhysRevLett.120.024102)
- [Discovering Phase Transitions with Unsupervised Learning](https://link.aps.org/doi/10.1103/PhysRevB.94.195105)
- [Machine learning phases of matter](https://www.nature.com/articles/nphys4035)
- [Machine Learning Topological Invariants with Neural Networks](https://link.aps.org/doi/10.1103/PhysRevLett.120.066401)
- [Deep learning for universal linear embeddings of nonlinear dynamics](https://www.nature.com/articles/s41467-018-07210-0)
- [Deep learning for early warning signals of tipping points](https://www.pnas.org/doi/10.1073/pnas.2106140118)
- [AI Poincaré 2.0: Machine Learning Conservation Laws from Differential Equations](https://arxiv.org/abs/2203.12610)
- [On the Theory of Superconductivity](https://link.springer.com/chapter/10.1007/978-3-540-68008-6_4)
- [Theory of Superconductivity](https://journals.aps.org/pr/abstract/10.1103/PhysRev.108.1175)
- [Nobel Lecture: Type-II superconductors and the vortex lattice](https://link.aps.org/doi/10.1103/RevModPhys.76.975)
- [The theory of a Fermi liquid](https://iopscience.iop.org/article/10.1088/0034-4885/22/1/310)
- [Electron correlations in narrow energy bands](https://royalsocietypublishing.org/doi/10.1098/rspa.1963.0204)
- [Anomalous Quantum Hall Effect](https://journals.aps.org/prl/abstract/10.1103/PhysRevLett.50.1395)
- [Observation of the e/3 Fractionally Charged Laughlin Quasiparticle](https://arxiv.org/abs/cond-mat/9706307)
- [Direct observation of a fractional charge](https://www.nature.com/articles/38241)
- [More Is Different](https://www.science.org/doi/10.1126/science.177.4047.393)
- [Discovering governing equations from data by sparse identification](https://www.pnas.org/doi/10.1073/pnas.1517384113)
- [AI Feynman: A physics-inspired method for symbolic regression](https://www.science.org/doi/10.1126/sciadv.aay2631)
- [Physics-tailored machine learning reveals unexpected physics in dusty plasmas](https://www.pnas.org/doi/10.1073/pnas.2505725122)
- [Measurement of the anomalous precession frequency of the muon in the Fermilab Muon g-2 Experiment](https://link.aps.org/doi/10.1103/PhysRevD.103.072002)
- [Evidence for Oscillation of Atmospheric Neutrinos](https://journals.aps.org/prl/abstract/10.1103/PhysRevLett.81.1562)
- [Measurement of the Rate of interactions Produced by 8B Solar Neutrinos at SNO](https://journals.aps.org/prl/abstract/10.1103/PhysRevLett.87.071301)
- [The frontier of simulation-based inference](https://www.pnas.org/doi/10.1073/pnas.1912789117)
- [Real-Time Gravitational Wave Science with Neural Posterior Estimation](https://journals.aps.org/prl/abstract/10.1103/PhysRevLett.127.241103)
- [Real-time inference for binary neutron star mergers using machine learning](https://www.nature.com/articles/s41586-025-08593-z)
- [Magnetic control of tokamak plasmas through deep reinforcement learning](https://www.nature.com/articles/s41586-021-04301-9)
- [Measurement of the Positive Muon Anomalous Magnetic Moment to 127 ppb](https://muon-g-2.fnal.gov/result2025.pdf)
- [Fermilab's final word on muon g-2](https://cerncourier.com/fermilabs-final-word-on-muon-g-2/)
- [GWTC-5.0: Observations from the Second Part of the Fourth LIGO-Virgo-KAGRA Observing Run](https://arxiv.org/abs/2605.27225)
- [Black Hole Spectroscopy and Tests of General Relativity with GW250114](https://arxiv.org/abs/2509.08099)
- [Multiple Physics Pretraining for Physical Surrogate Models](https://arxiv.org/abs/2310.02994)
- [Walrus: A Cross-Domain Foundation Model for Continuum Dynamics](https://arxiv.org/abs/2511.15684)
- [Towards a Physics Foundation Model](https://arxiv.org/abs/2509.13805)
- [Physics Supernova: AI Agent Matches Elite Gold Medalists at IPhO 2025](https://arxiv.org/abs/2509.01659)
- [PhysMaster: Building an Autonomous AI Physicist](https://arxiv.org/abs/2512.19799)
- [Transfer learning beyond the standard model](https://iopscience.iop.org/article/10.1088/1475-7516/2026/06/026)
- [Machine-learning-guided discovery of kagome superconductors YRu3B2 and LuRu3B2](https://journals.aps.org/prresearch/abstract/10.1103/lpqj-7hyg)
- [Breaking the curse of dimensionality: Solving configurational integrals for crystalline solids by tensor networks](https://journals.aps.org/prmaterials/abstract/10.1103/xrbw-xr49)
- [Upgrade to Premium](https://x.com/i/premium_sign_up)
- [12:31 PM · Aug 8, 2026](https://x.com/snowboat84/status/2085946919277461512)
- [9,561 Views](https://x.com/snowboat84/status/2085946919277461512/analytics)
---
*导出时间: 2026/8/8 19:21:49*