从 RL 到蒸馏,再到软蒸馏:Why RL Matters?
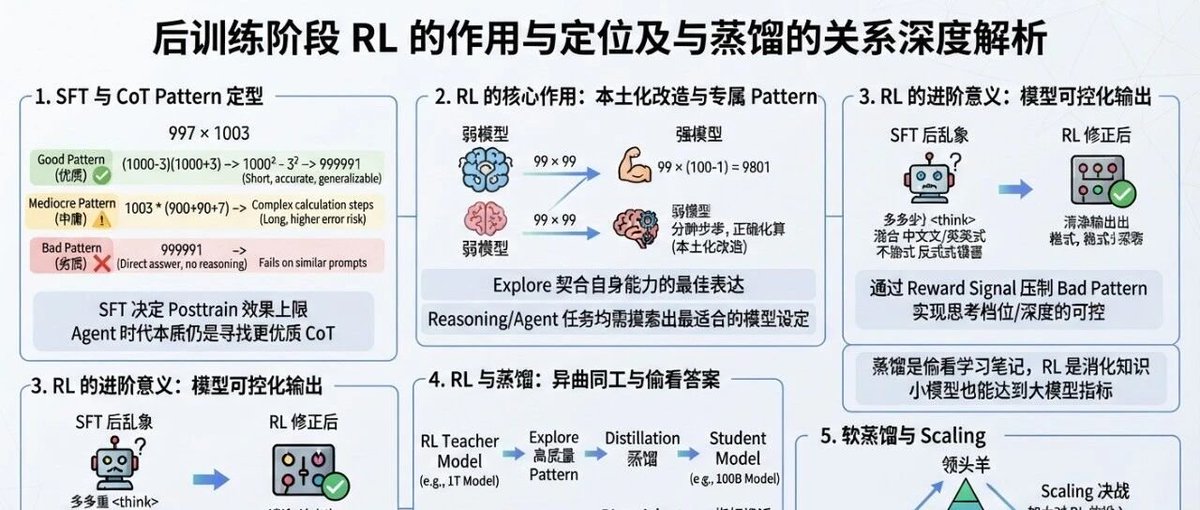
本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。
本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。
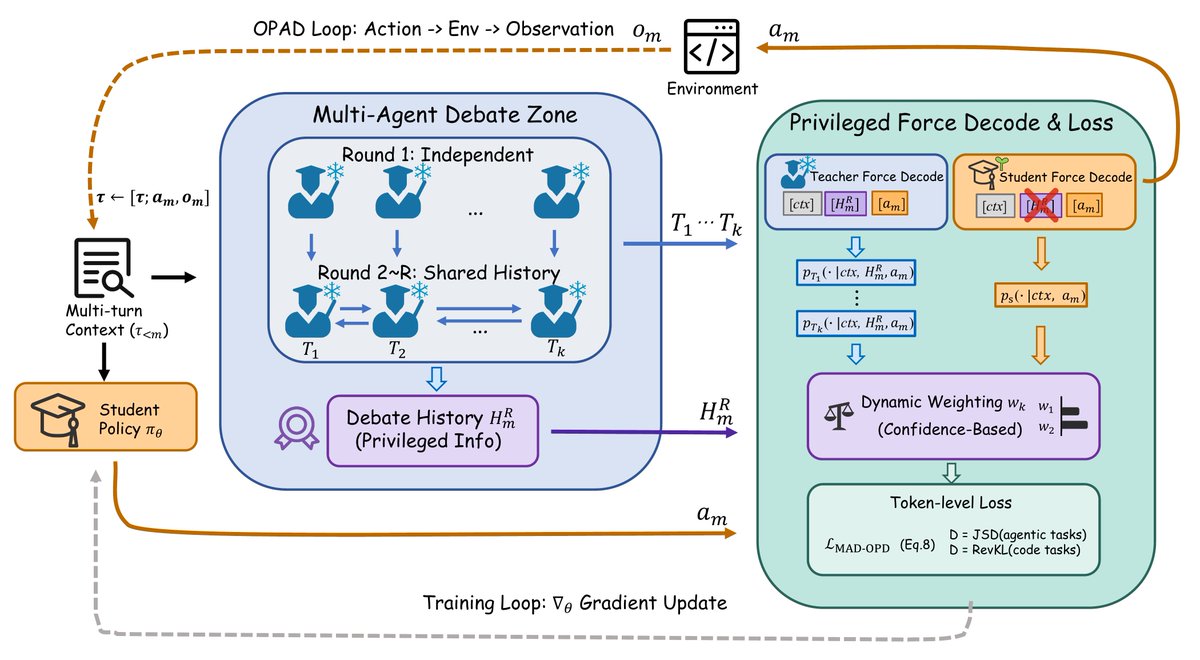
文章介绍了一种名为 MAD-OPD 的新算法,旨在解决 OPD(On-Policy Distillation)中单教师模型存在盲点导致学生模型学习受限的问题。通过引入多智能体辩论机制,让多个教师围绕学生状态互相纠错并达成共识,再进行蒸馏。实验表明,该方法在 14B+8B 到 4B 的蒸馏任务中,不仅提升了代码生成能力,还在 Agentic 任务中实现了小模型反超大教师的突破。