从 RL 到蒸馏,再到软蒸馏:Why RL Matters?
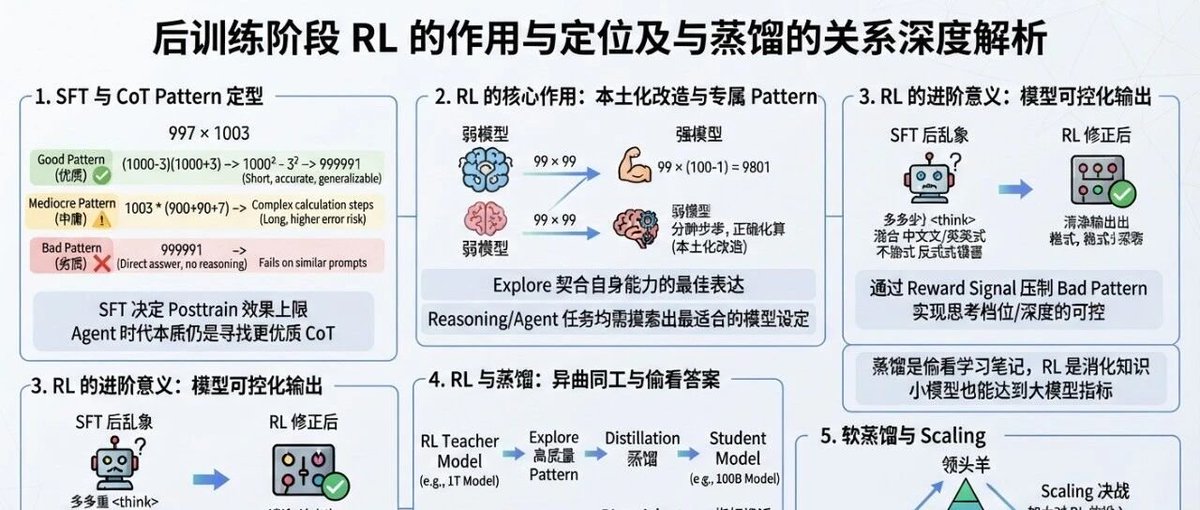
本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。
本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。
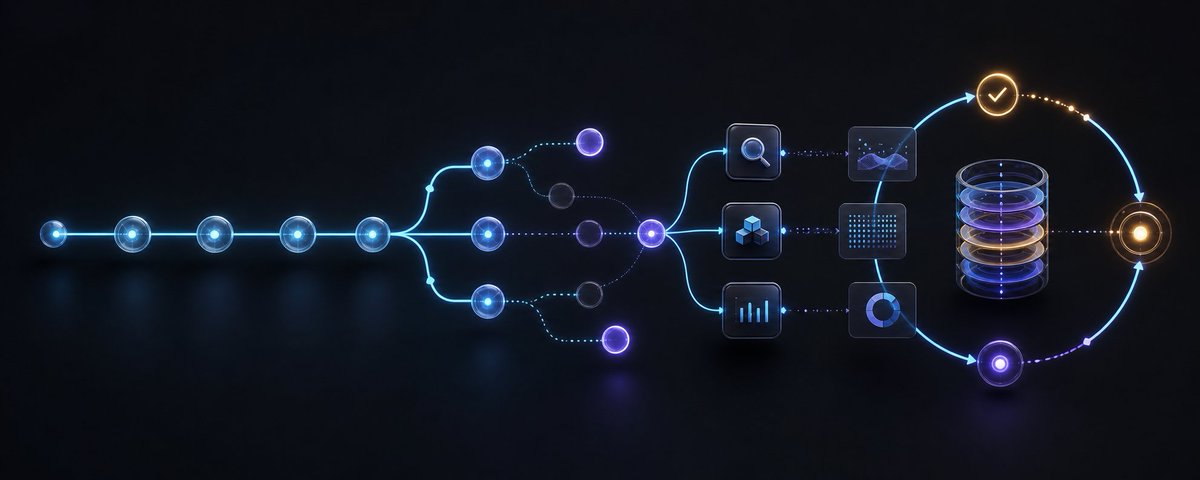
本文通过 Python 演示了如何搭建一个具备规划、工具调用、验证和复盘能力的完整 LLM Agent。教程详细拆解了 Plan-and-Solve、ReAct、Verification、Self-Refine 和 Reflexion 五个核心模块,强调了结构化数据控制流程的重要性,并提供了工程落地的具体代码实现与原则。
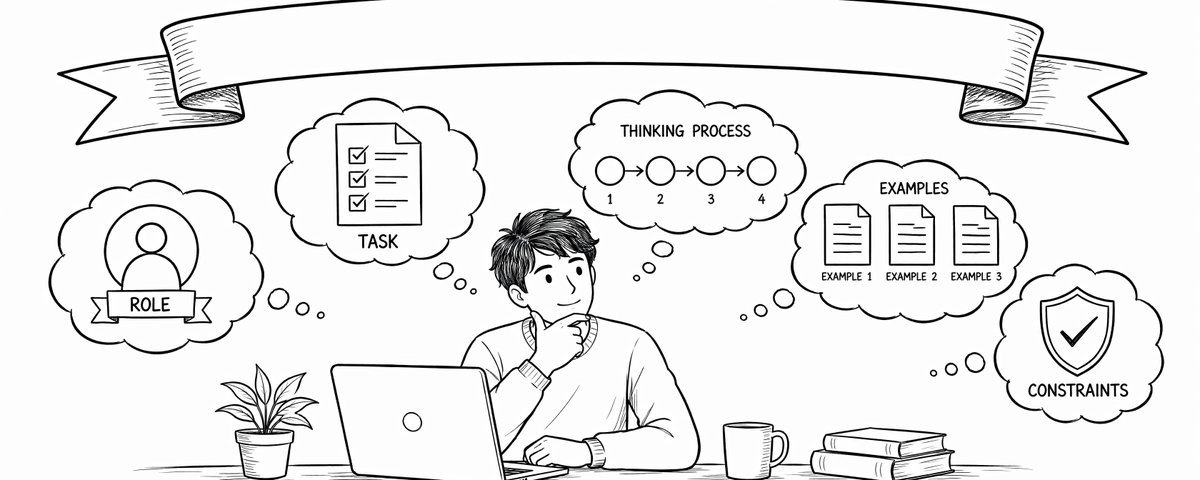
本文是一份面向全员(美术、运营、产品、策划、财务、客服)的提示词工程实战培训手册。文章不仅解析了角色设定、格式控制、思维链、少样本示例和负面约束五大核心技巧,还提供了周报生成、会议纪要、竞品调研等可直接套用的Prompt模板,并整理了李继刚、宝玉等国内知名创作者的实践思路,旨在通过“少理论,多模板”的方式提升AI办公效率。
文章揭示了AI时代提示词工程的核心不仅是技巧,而是“表达需求的能力”。作者提出了一套系统化的四阶段方法论:需求结构化(COSTAR模版)、推理路径设计(CoT与Few-Shot)、结果校验(自我一致性与ReAct)以及迭代反馈(Reflexion)。通过这套闭环思维,用户可以将简单的问答转化为高质量的决策方案。
文章深入探讨了 AI Agent 面临的记忆系统瓶颈:无限记忆增长(UMG)导致检索效率低下和噪声干扰,以及虚假记忆传播(FMP)利用思维链错误放大幻觉。作者指出现有的 RAG 系统因读写混合而加剧了该问题,并提出可以借鉴强化学习(RL)机制,根据任务验证结果对记忆进行奖惩打分,从而过滤无效记忆。