Wiki 知识库

全部文档 / 作者: Lotte / 标签: Agent

4 篇
清除

Your users are already evaluating your AI

文章介绍了在 LLM/Agent 产品中,除了搭建在线评估器之外,更应优先捕获用户评判信号(signals of judgment)。用户在使用过程中已通过行为在'评判'AI 输出质量,只需在应用中埋点捕获。信号分为四类:显式评分(点赞/星级,明确但稀少)、行为信号(复制、重新生成、放弃等,覆盖率高)、会话信号(改写问题、纠正、要求转人工等)和结果信号(草稿被原样发送、工单保持关闭等,最强但最难实现)。文章还讨论了信号解读方法:负信号值得逐条排查,正信号只看趋势;以及自我选择、幸存者偏差、界面曝光、群体差异等固有偏差,提醒不要单以正信号为优化目标。
技术 › LLM Lotte 2026-09-1711.5 KB 8.9K 63 86

如何构建可持续维护的评估集

本文介绍了如何为AI Agent构建可长期维护的评估(eval)指标体系。指标分三类:目标指标、护栏指标和运营指标,三者结合使用。候选指标来源于错误分析和产品目标与硬约束。并非所有候选都值得跟踪:一次性问题用prompt修改解决即可,只有需要持续追踪的泛化问题才建指标;每个指标必须与具体决策挂钩,否则就是噪音。从零开始时,可先阅读30-50条trace并用自由文本笔记聚类失败模式。此外需定期重跑错误分析、退役失效指标,并警惕Goodhart定律导致的过拟合。

技术 › LLM Lotte 2026-08-198.4 KB 89.1K 476 83

AI 工程评估方法详解:Manual、Code 与 LLM-as-a-judge

文章阐述了 AI 工程闭环中评估环节的重要性,详细介绍了手动评估、基于代码的确定性评估以及 LLM-as-a-judge 三种主要方法。作者建议从手动审查开始建立直觉,逐步定义并自动化具体的失败模式。文章还探讨了基于参考与无参考评估的区别,并强调应结合多种方法,优先使用二值评分以确保评估的清晰性与可靠性。

技术 › LLM Lotte 2026-05-208.8 KB 40.9K 417 83

Designing eval datasets for LLM applications

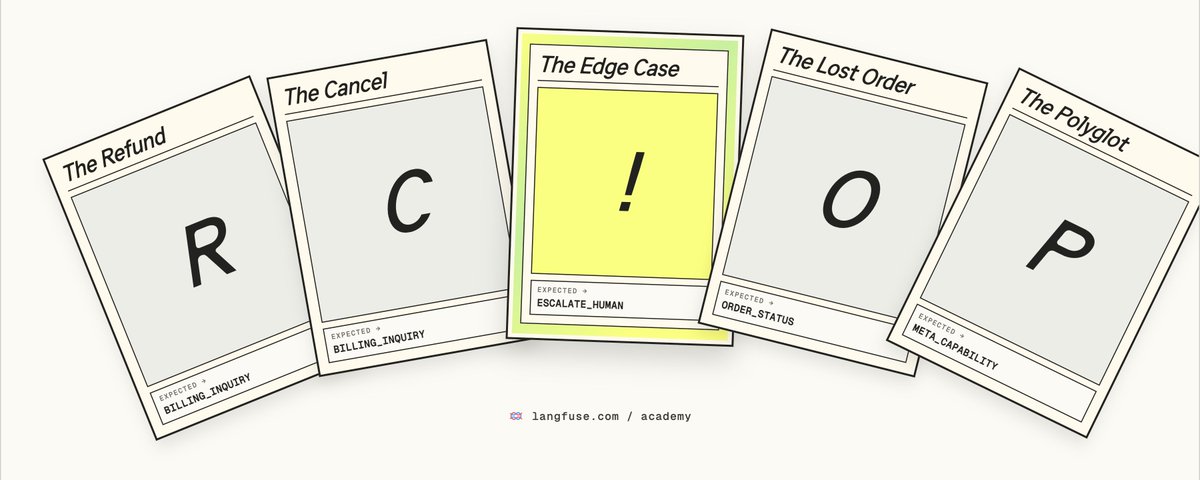
本文是 Langfuse Academy 系列的一部分,深入探讨了 AI 工程生命周期中的数据集设计。文章解释了数据集如何连接生产监控与开发迭代,详细介绍了数据集项的三个核心字段(输入、期望输出、元数据)及不同的评估模式。此外,文章还分享了构建高质量数据集的最佳实践,包括如何定义范围、确定规模,以及如何从生产 Trace、手工编写和合成数据中起步。

技术 › LLM Lotte 2026-05-186.3 KB 39.8K 321 80