How we built our knowledge base
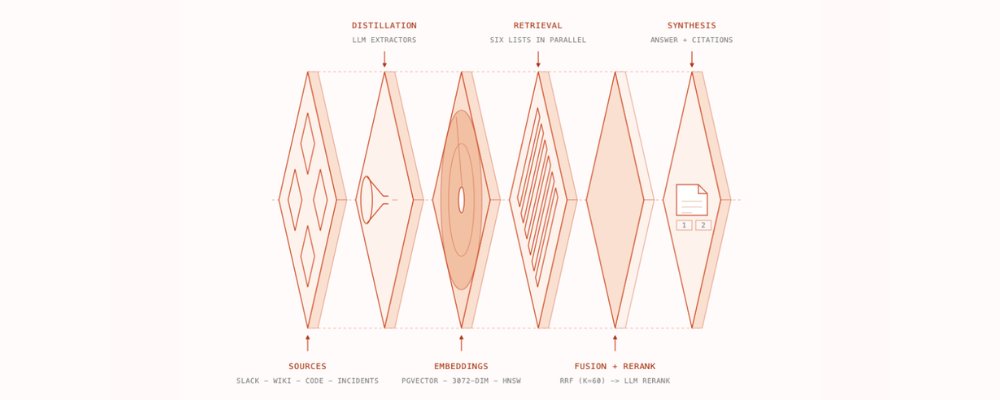
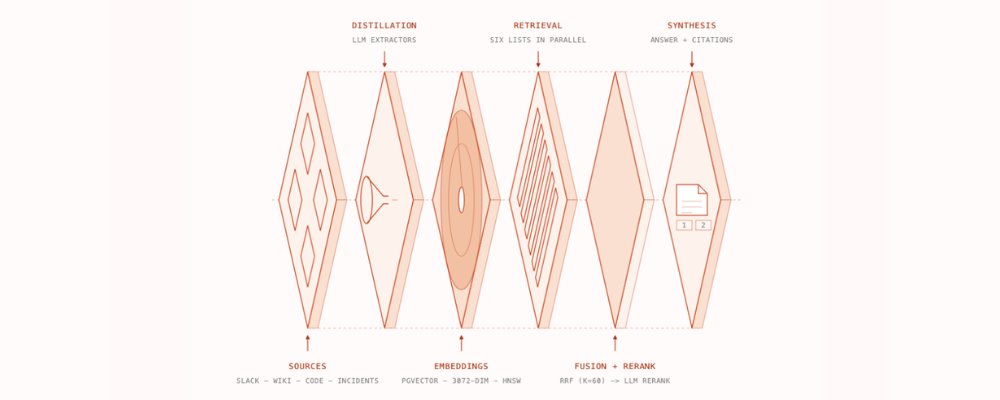
Cerebras 分享了构建其内部知识库的经验。该知识库每天处理超过 15,000 个问题,集成了 Slack、GitHub 等多种数据源。文章详细介绍了如何通过 Postgres 存储 embeddings,并采用混合搜索策略(全文搜索、向量搜索、IDF 加权、时间衰减)来高效检索非结构化对话数据,解决了信息分散和匹配精度的问题。
Cerebras 分享了构建其内部知识库的经验。该知识库每天处理超过 15,000 个问题,集成了 Slack、GitHub 等多种数据源。文章详细介绍了如何通过 Postgres 存储 embeddings,并采用混合搜索策略(全文搜索、向量搜索、IDF 加权、时间衰减)来高效检索非结构化对话数据,解决了信息分散和匹配精度的问题。
Cerebras 分享了如何构建内部知识库,该系统每天处理超过 15,000 个查询。文章介绍了其数据采集架构,特别是如何通过混合搜索技术(全文搜索、Embedding 搜索、IDF 和时间衰减)来处理非结构化的 Slack 对话,以提高信息检索的准确性和实时性。
Cerebras 介绍了其内部知识库的构建过程,该知识库每天处理超过15,000个问题。系统通过从Slack、GitHub等平台提取数据,利用Postgres存储嵌入和元数据,结合全文搜索、向量搜索、IDF和衰减时间等混合搜索技术,实现了高效的信息检索。