Wiki 知识库

全部文档 / 标签: 检索增强生成

6 篇
清除

Agent 高频题 01. 讲讲你的 RAG 链路

本文是 Agent 高频面试题详解系列第一篇,聚焦 RAG(检索增强生成)链路。文章基于近两个月牛客网 82 场面试的统计,指出 RAG 是最常被追问的题目。内容先给出 RAG 整体架构图,解释为什么需要 RAG 及其与长上下文、grep、微调、工具调用、记忆等方案的边界;再沿离线、在线两条线逐环讲解:离线部分涵盖文档解析、切分策略、embedding 向量化、HNSW/IVF 索引原理;在线部分讲解问题改写、BM25 与向量多路召回、RRF 融合、交叉编码器重排等环节。每个环节均附上面试常见追问,并提供复习优先级参考。

技术 › Agent 码良 2026-10-2041.5 KB 10.7K 70 78

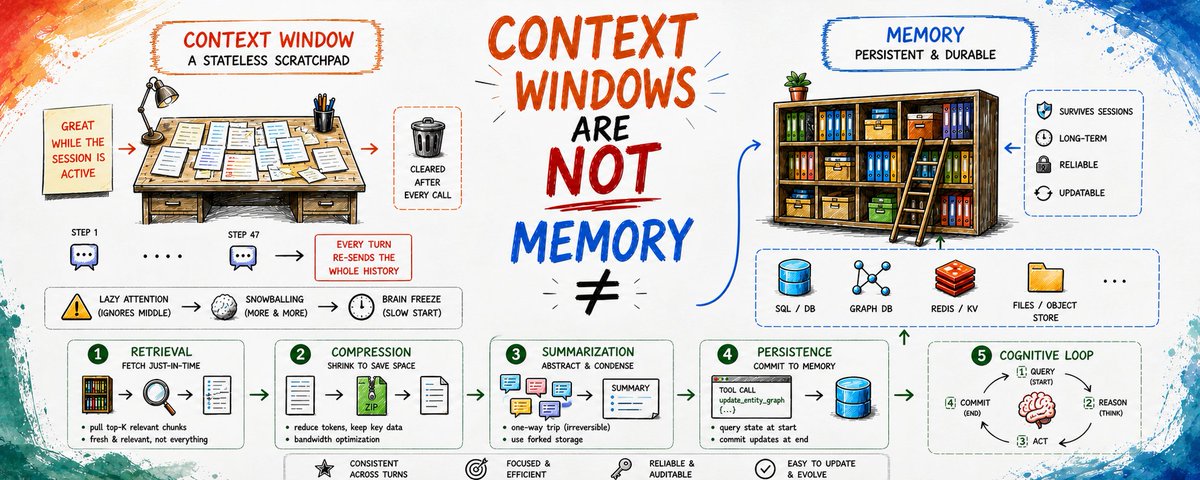
Context Windows Are Not Memory: What AI Agent Developers Need to Understand

本文深入探讨了AI代理开发中的一个关键误解:大上下文窗口并不等同于记忆。作者通过办公室隐喻,清晰区分了上下文窗口(桌面)、检索(书架)、压缩(ZIP)和摘要(抽象)在代理认知栈中的不同角色。文章指出,模型本质上是无状态的,每次API调用都从零开始,依赖大上下文窗口会导致注意力分散、雪球效应和延迟问题。真正的记忆持久化需要代理扮演数据库管理员的角色,通过检索、压缩和摘要等技术,将原始数据存储在外部存储中,仅将相关信息放入上下文窗口。文章提供了具体的代码示例,展示了如何实现冲突解决和分叉存储模式,为构建可靠的AI代理提供了实用指导。

技术 › LLM beamnxw 2026-08-1510.9 KB 104.3K 119 76

百万级文档RAG实战:检索质量由重排和查询改写决定,模型选型反而是小事

本文总结了HN上关于RAG系统实战的讨论,核心结论是检索质量主要由重排和查询改写等流程环节决定,而非模型选型。文章整理了微软Pamela Fox和Usul AI作者Abdellatif等一线工程师的学习清单,涵盖生产级RAG的ROI排序、检索理论、开源模板、模型评测、存储基础设施及产品案例,并指出query generation和reranking是性价比最高的优化点,chunking最耗时。

技术 › LLM yibie 2026-08-136.4 KB 77

How we built our knowledge base

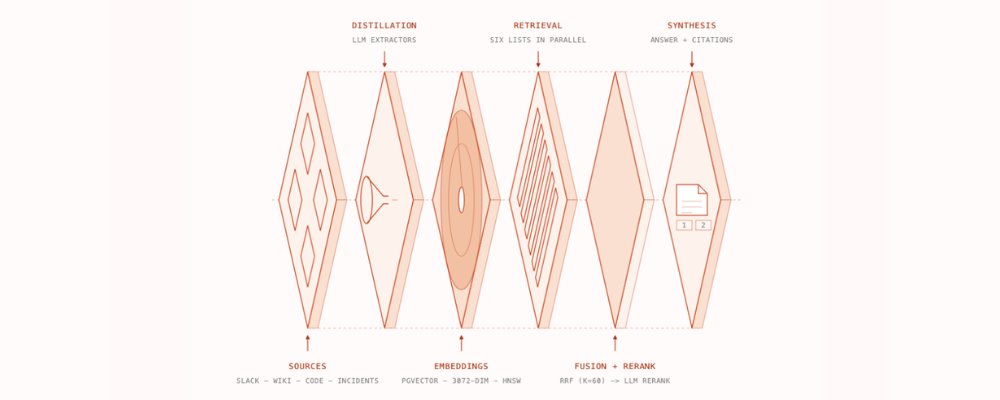
Cerebras 分享了构建其内部知识库的经验。该知识库每天处理超过 15,000 个问题,集成了 Slack、GitHub 等多种数据源。文章详细介绍了如何通过 Postgres 存储 embeddings,并采用混合搜索策略(全文搜索、向量搜索、IDF 加权、时间衰减)来高效检索非结构化对话数据,解决了信息分散和匹配精度的问题。

技术 › DevOps Cerebras 2026-07-18311.2 KB 3.6M 5.6K

RAG 像素级拆解实战:索引、混合检索与评测体系

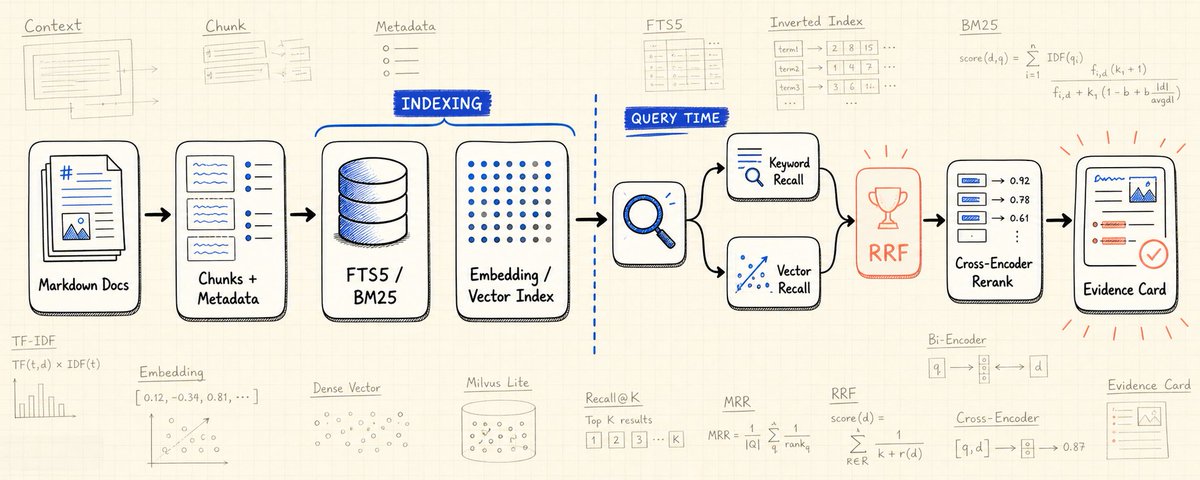
本文通过 Notebook 实战项目,对 RAG 系统的索引与检索过程进行了深度解析。内容涵盖文档切分(Chunking)、SQLite FTS5 倒排索引、BM25 关键词检索、向量 Embedding 语义检索,以及基于 RRF 的混合检索召回策略。此外,文章还介绍了如何构建评测集来验证检索效果,提供了完整的代码与数据结构示例,旨在帮助开发者理解 RAG 底层运作原理与工程实践细节。

技术 › LLM MateMatt 2026-07-1218.3 KB 43.4K 40

非向量 RAG 框架 PageIndex:用 LLM 推理替代 Embedding

文章介绍了 VectifyAI 开源的 PageIndex 框架,这是一种不使用向量嵌入的 RAG(检索增强生成)方法。它通过构建文档的层次树结构,利用 LLM 的推理能力来精确定位答案页面。该框架在 GitHub 获得了超过 2.9 万星,其构建的 Mafin 2.5 在金融问答基准测试中取得了 98.7% 的高准确率。

技术 › LLM AlphaSignal AI 2026-05-0811.9 KB 11.3K 165 87