Wiki 知识库

全部文档 / 标签: 信息检索

15 篇
清除

Agent Reach:89K Star,给 AI 装上读遍全网的眼睛

文章介绍了开源项目 Agent Reach(约8.9万Star),它为 AI Agent 提供读取全网信息的能力。项目不重复造工具,而是负责为16个平台(含B站、小红书、V2EX、雪球等国内平台)做工具选型、安装、健康体检和路由,每个平台配备首选加备选方案,接口被封时自动切换。安装只需一句话交给 AI 完成,使用时用自然语言即可让 AI 搜索、读取各平台内容并总结。作者提示 Cookie 登录平台存在封号风险,建议使用小号。文章强调其核心价值在于'先把会坏想到前面'的工程设计思路,让 AI 站在真实信息上回答问题。

技术 › Agent 北 北衡 2026-10-176.8 KB 862 9 81

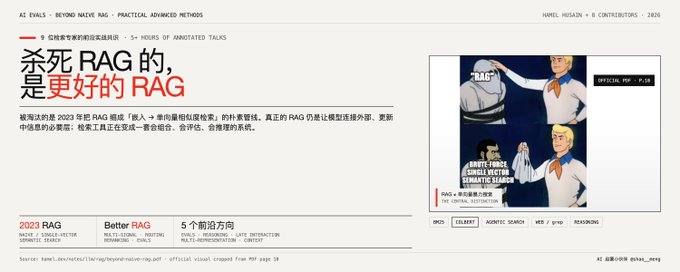
杀死 2023 RAG 的,是更好的 RAG:9 位检索专家的前沿实战共识「Beyond Naive RAG」

本文介绍 Hamel Husain 主编的演讲合集《Beyond Naive RAG》,汇集 9 位一线检索专家的共识:朴素 RAG(切块+单向量+余弦检索)已失效,但检索增强生成本身远未死亡。全书论证三条主线:长上下文不能替代检索(Context Rot 证明上下文越长模型越不可靠);评估先于优化(公开基准已污染,须建自有黄金数据集);复杂性不是目的(慎用图数据库等过度工程)。涵盖 ColBERT 后期交互、推理增强检索(Promptriever、Rank1)、多重表示与智能路由、FreshStack 评估指标等前沿方法,提出'评估驱动+多表示+推理增强+克制架构'的实践观。

技术 › LLM meng shao 2026-10-1211.9 KB 4.7K 43 84

Research Engineering: 构建AI研究机器

文章提出'研究工程'(Research Engineering)的实践方法,指出常见AI搜索工具只是'带浏览器的流畅回答',其核心缺陷在于缺少支撑证据的系统。作者提出一个与模型无关的六阶段研究工作流架构:定义研究简报、拆解查询计划、搜索与抓取、记录证据账本、验证声明冲突、生成带来源报告。文章强调要给agent明确的研究契约(含范围、时间点、比较维度、停止条件),将问题拆成目的不同的并行搜索通道,而非让多个agent读同样的资料制造虚假共识。还介绍了多源检索策略(开放网络、X、私人文档库、数据库/API),核心目标是让AI返回更少的不受支持的声明,并持续追踪'它如何知道自己所说的是真的'。

技术 › Agent rari 2026-10-0824.1 KB 63.6K 230 85

都翻墙了,还只会拿 Telegram 看群看片?我是怎么把它变成“海外信息数据库”的

文章系统讲解了如何把 Telegram 从被动接收消息的聊天软件,变成主动获取信息的“海外信息数据库”。作者提出:正确使用内置搜索(中英文多关键词组合)、善用搜索机器人与外部 Web 搜索反向查找入口;用“三分钟筛选法”判断频道质量(看最近消息、更新频率、来源可靠性);控制订阅数量、用文件夹管理;寻找高质量 Seed Channel 并沿转发、引用和管理员网络扩展信息源;最后将 Telegram 接入 AI 工作流,用 AI 做翻译、摘要、实体提取和选题整理,把信息变成自己的研究材料,建立个人“信息雷达”。文中还强调了账号安全底线。

技术 › 工具与效率 Fred-New 2026-09-1118.0 KB 74K 150 82

告别混乱收藏夹!我用 Markdown + 本地 AI 搭建数字大脑

作者分享了自己搭建 AI 个人知识库的完整经验。文章指出收藏资料不等于拥有知识,知识库应帮助找回信息、形成判断并推动行动。作者以 Markdown、JSON 和原始文件为事实源,搭建了包含 raw、notes、wiki、briefs、logs 五层结构的系统,覆盖内容入库、索引检索、AI 引用问答、周报复盘等流程。文章还总结了搭建中的关键原则:原文、AI 总结与个人判断分开,回答必须带引用,先用简单检索验证需求,注意隐私与数据边界,并通过 14 天真实使用验证价值,最终实现从收集到判断的行动循环。

技术 › 工具与效率 浅水虾 2026-09-029.2 KB 2.6K 2 77

Codex 进阶应用教程:普通人最常用的 10 个工作场景

本文系统介绍了 Codex 在普通人日常工作中的十个典型应用场景,包括电脑配置与软件安装、文件夹整理、会议纪要汇总、Excel 数据分析、PPT 制作、网页信息检索、网页与桌面软件操作、长期任务管理、Skills 固定工作流建设以及专业资讯监控。每个场景都遵循'先只读检查、再确认方案、后执行验收'的原则,并提供了可直接使用的提示词模板,强调任务边界、人工确认和结果核验,帮助用户安全高效地将日常任务交给 Codex 完成。

技术 › Codex Miles Ma 2026-08-2621.5 KB 335.3K 773 88

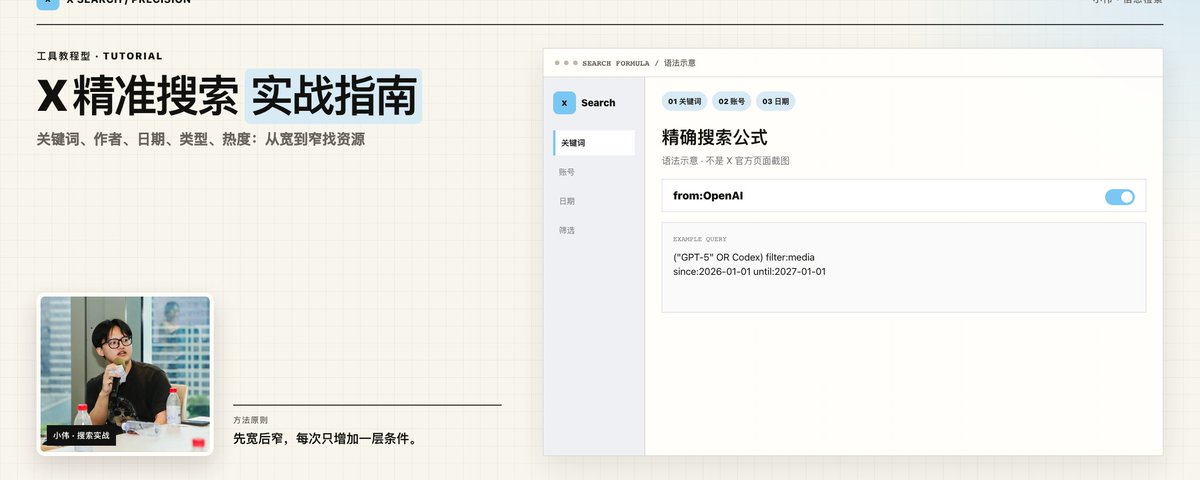
手把手教你用 X 精准搜索,成为你的一手AI信息源

本文系统介绍了如何利用 X(Twitter)官方高级搜索功能精准获取 AI 信息。文章讲解了搜索的五大维度:关键词、账号、帖子形态、互动量和时间范围,并提供了完整的搜索语法公式大全,包括 from:/to: 锁定账号、since:/until: 限定日期、filter:media 筛选媒体、min_faves 设置热度门槛等。作者还给出六个最常用场景的可直接复制的查询模板,并分享了结果为零时的排查技巧——按固定顺序逐层移除条件,快速定位过严限制。

技术 › 工具与效率 siuser小伟 2026-08-256.9 KB 55.6K 225 77

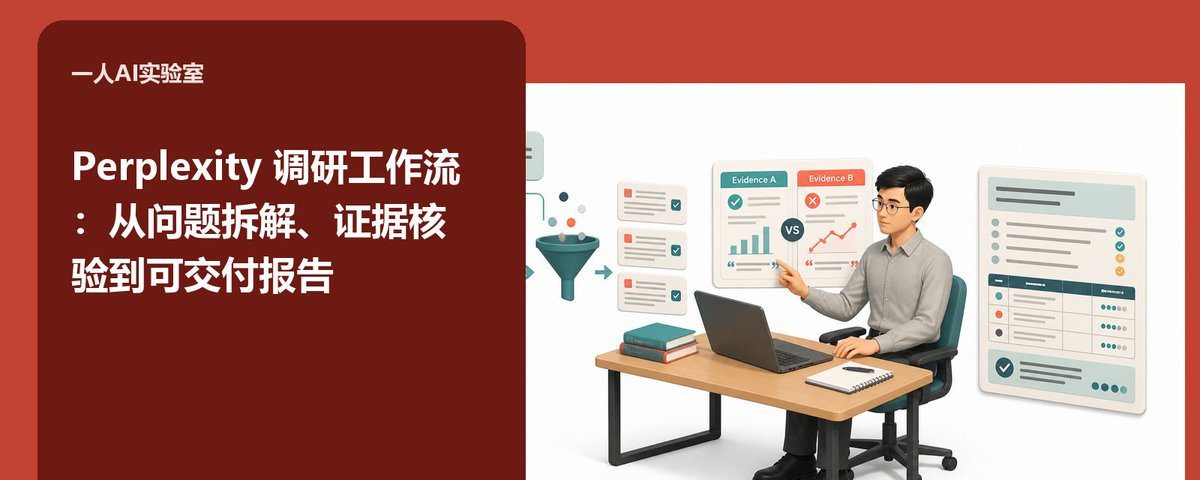
Perplexity 调研工作流:从问题拆解、证据核验到可交付报告

本文介绍如何用 Perplexity 做产品调研和行业研究的完整工作流,共五步:一、把大问题拆解为可验证的问题清单;二、用 Research 模式做宽搜,明确来源优先级;三、逐条核验引用来源,分为 A/B/C 三档;四、针对证据缺口做定向追问与反证;五、把结果按决策顺序改造成可交付报告,附来源表。文章还指出该流程的边界与五项验收标准,强调 Perplexity 的价值在于把“我觉得”改造成可追踪、可反驳的证据链。

技术 › 工具与效率 FlowOps Daily 2026-08-186.5 KB 1.9K 14 73

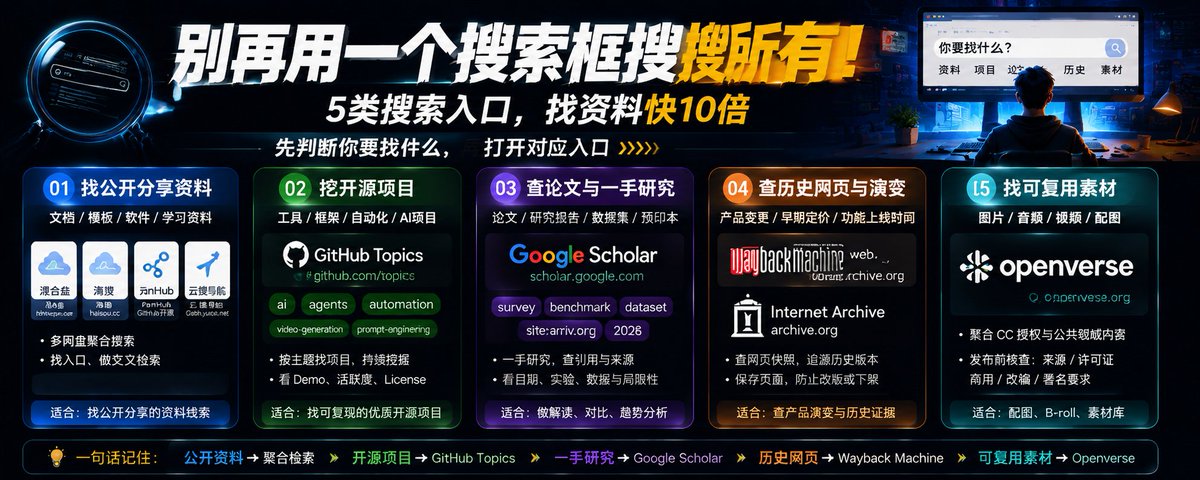
高效搜索指南:别再一个搜索框搜到底

本文指出许多人找资料慢的原因在于将所有搜索需求都塞进同一个搜索框,而不同类型的资料需要不同的搜索入口。作者将常用搜索入口分为五类:公开分享资料(如混合盘、海搜)、开源项目(GitHub Topics)、论文与一手研究(Google Scholar)、历史网页(Wayback Machine)、可复用素材(Openverse),并提供了具体的使用方法和搜索技巧。文章强调搜索分流能显著提升效率,帮助内容创作者快速找到高质量信息。

技术 › 工具与效率 小海豚笔记 2026-08-127.3 KB 1.8K 8 76

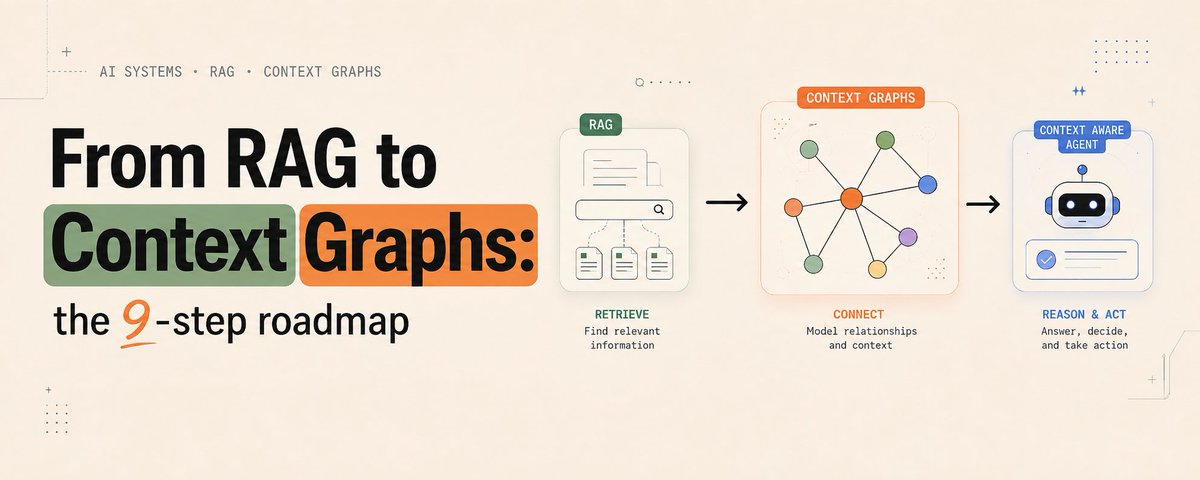
从RAG到上下文图谱:9步路线图

文章探讨了传统RAG在处理多跳推理问题时的局限性,指出检索文本块无法捕捉复杂的实体关系链。为此,作者提出了一种向“上下文图谱”转型的9步实施路线图。该方法通过从文本中提取实体与关系三元组,进行实体规范化以避免图谱割裂,并构建双向边表。图谱通过多源验证分配边权重,并为每条边附加来源以实现精准溯源。最终,检索过程转变为图谱遍历,通过反向可达性分析和路径权重排序,精准定位多跳查询的答案。

技术 › LLM Morlex 2026-08-1011.5 KB 310.6K 465 83

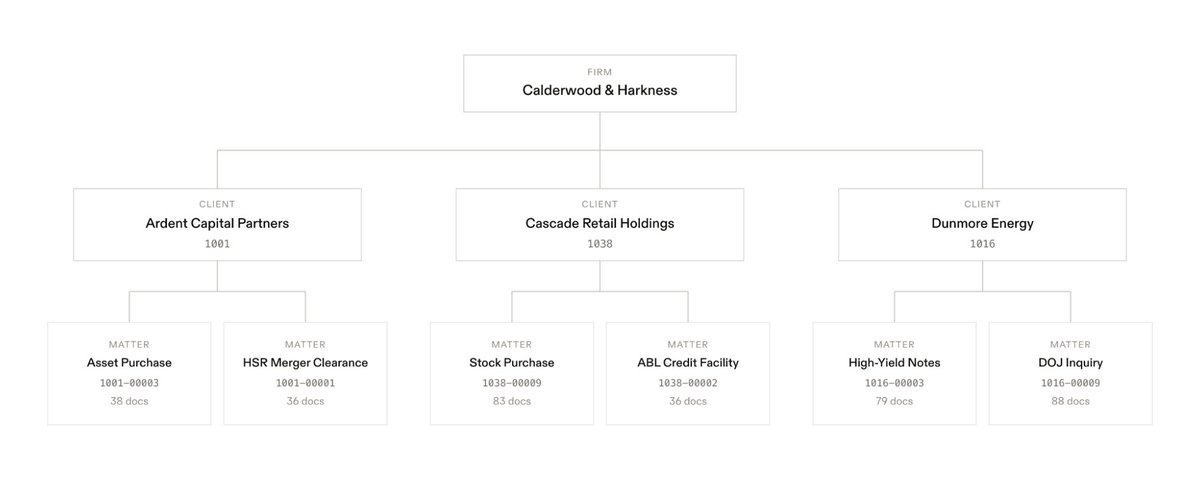
LAB: 模拟律师事务所知识环境与AI智能体基准测试

本文介绍了开源的模拟律所环境Calderwood & Harkness (C&H),旨在测试大语言模型在企业级海量知识(超1亿Token)中的检索与推理能力。C&H包含46个客户和266个案件。基准测试表明,当前先进模型在全面搜索和判断信息检索的“完整性”上存在严重瓶颈,导致任务完成度受限。作者指出,未来的改进方向是让智能体预先构建更丰富的语料库表示(如索引、摘要、记忆),以分摊运行成本并提升企业级知识处理能力。

技术 › Agent Julio Pereyra 2026-08-088.8 KB 298.1K 234 86

一个暑假,我侄子用两个 Skill 搞明白了 Agent 最难的部分

作者讲述侄子利用暑假开发两个健康类 Agent Skill 的经历。从“养生谣言粉碎机”到“体检行动助手”,解决了大模型幻觉、信息检索权威性及流程设计等难点。文章重点介绍了如何利用豆包搜索 API 的结构化数据与权威过滤功能来增强 Agent 能力,并分享了 Skill 开发优于独立 Agent 的实践经验和建议。

技术 › Agent 宝玉 2026-07-2814.6 KB 52.2K 238

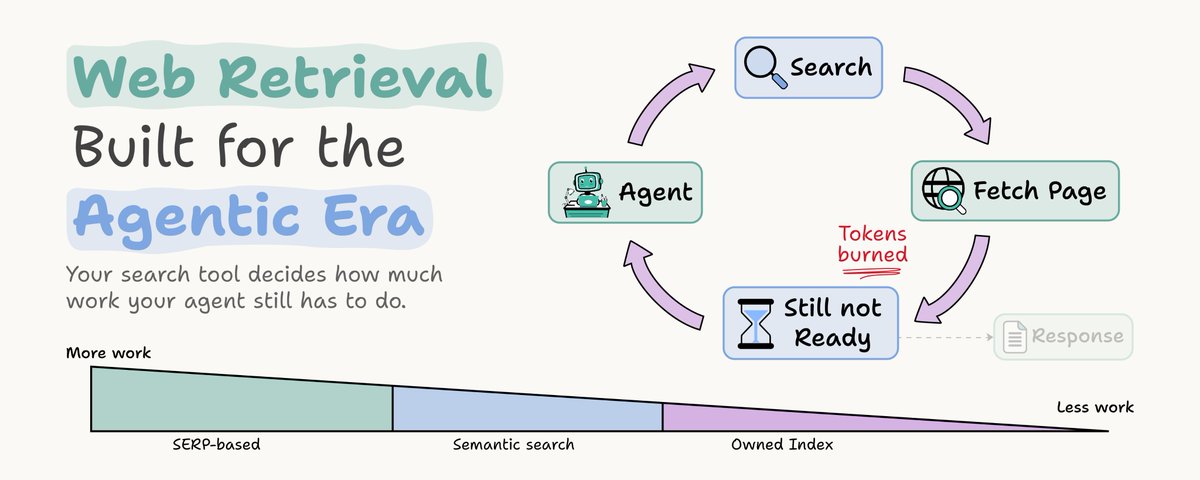
Agents Need a New Kind of Web Search

文章探讨了当前 AI Agent 在使用传统网页搜索时面临的“检索税”问题。传统搜索 API 仅返回链接和摘要,迫使 Agent 耗费大量 Token 去抓取和清洗内容。作者通过对比实验指出,使用预先爬取并结构化处理的索引(如 Seltz)能显著降低成本并提升效率,这种返回完整文档而非指针的方式是 Agent 搜索的未来。

技术 › Agent Akshay 2026-07-179.7 KB 72.1K 152

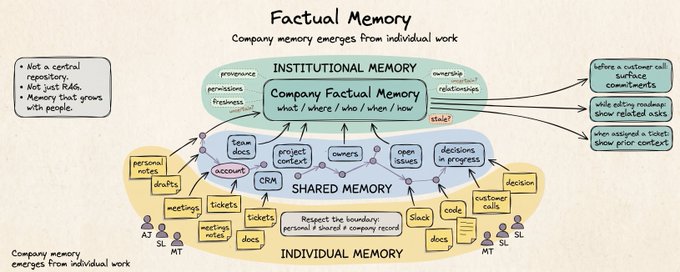
Company Brain, Part 2: Factual Memory

文章探讨了构建“公司大脑”中的事实记忆层。作者指出,真正的企业记忆不是简单的知识库或带有聊天框的企业搜索,而是一种从个人工作向外涌现的语义文件系统。它必须具备追溯性、权限管理和个性化能力,能够综合多源数据(如文档、CRM、代码)并主动提供上下文,而非仅被动等待查询。

技术 › LLM Ashwin Gopinath 2026-05-0119.8 KB 71.7K 709 66