AI 全自动生成图书号短视频实战流程
本文详细拆解了使用 Codex、HyperFrames、VoxCPM 及 fast-whisper 等开源工具,全自动生成图书号短视频的完整技术链路。流程涵盖资料收集、文案生成、语音克隆、音频后期处理及字幕对齐等关键环节,旨在构建一套可复用的 AI 自媒体生产工作流。
本文详细拆解了使用 Codex、HyperFrames、VoxCPM 及 fast-whisper 等开源工具,全自动生成图书号短视频的完整技术链路。流程涵盖资料收集、文案生成、语音克隆、音频后期处理及字幕对齐等关键环节,旨在构建一套可复用的 AI 自媒体生产工作流。
本文介绍了作者利用 WorkBuddy 结合「蚁小二」CLI 工具,实现自媒体多平台内容自动分发的实践。通过打通账号管理、发布排版、合规校验及数据分析等全流程,有效降低了机械性重复劳动,提升了内容创作效率,实现了 Agent 时代的自媒体运营自动化闭环。
本文探讨了在 AI 时代,工程师角色的根本性转变。通过 OpenAI、Spotify 等案例,指出工程师正从「写代码的人」转变为「编排 Agent 的人」。文章详细阐述了新角色的四个维度:设计约束、编写 Spec、构建 Harness 和审阅产出。团队结构也随之重组,从按技术栈分工转向按 Spec/Review/Harness 流程分工。
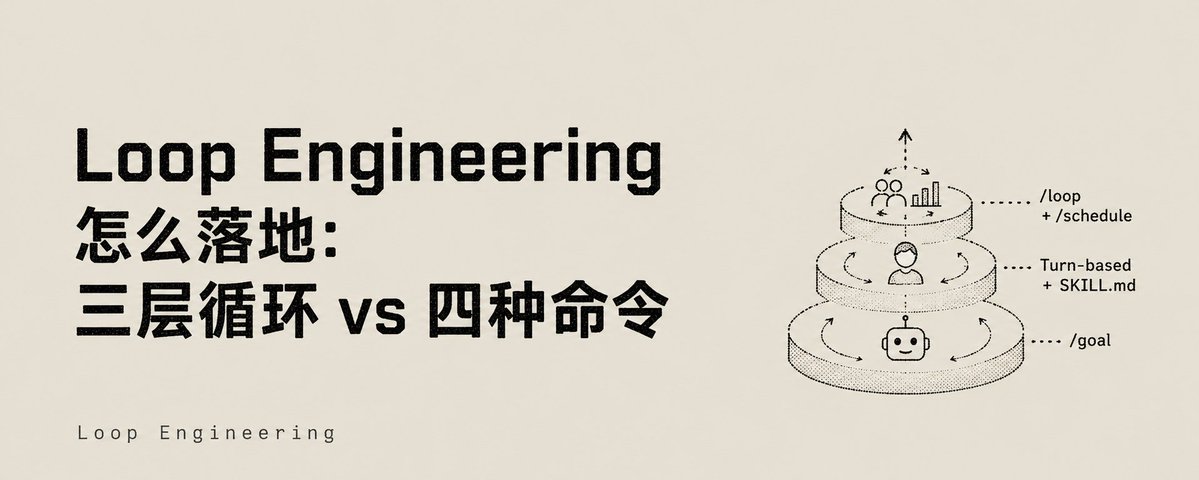
本文结合吴恩达与 ClaudeDevs 的观点,深入探讨了 AI 编程(Loop Engineering)的落地实践。文章将吴恩达的“三层循环”(分钟级自检、小时级决策、天级反馈)与 ClaudeDevs 的“四种命令”(Turn-based, Goal-based, Time-based, Proactive)进行映射,提供了一套从定义验证标准、固化人工经验到收集外部反馈的完整方法论,帮助开发者摆脱只做 QA 的困境,真正掌握 AI 编程的效率。
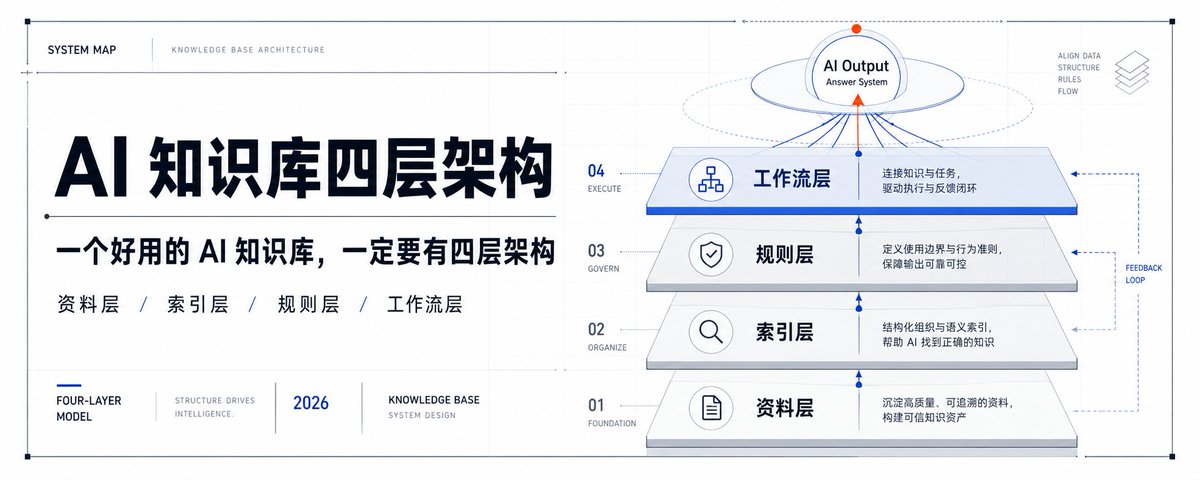
文章指出AI知识库搭建失败常因只有资料层,缺了索引、规则和工作流。资料层重质不重量,索引层解决检索路径,规则层限定输出与引用规范,工作流层确保落地任务。
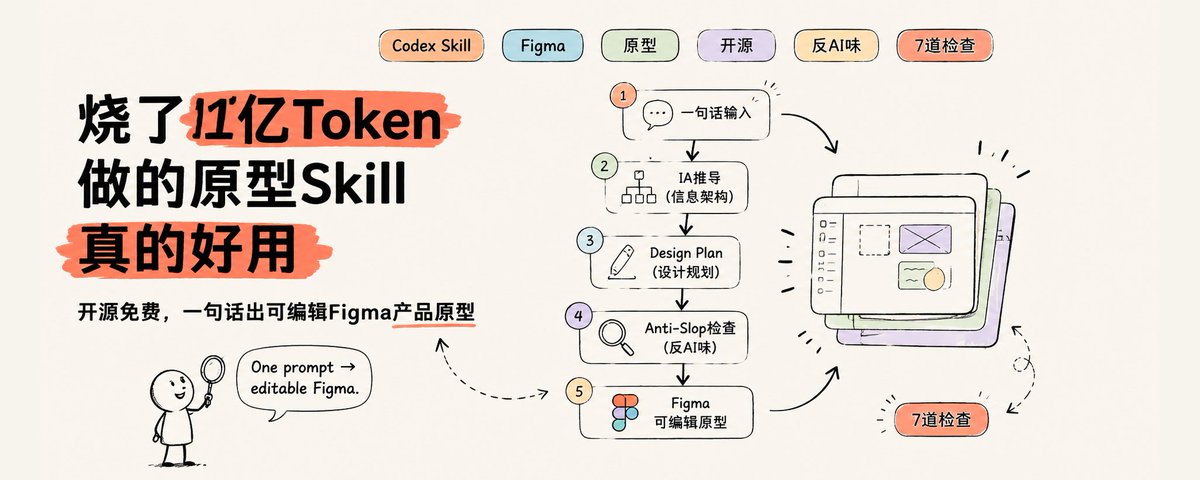
本文介绍了一款开源的产品经理原型生成 Skill。作者为了解决现有 AI 原型工具“修改即重绘”的痛点,消耗约 1 亿 Token 开发了该 Skill。它遵循专业的产品流程(IA推导、设计规划、Figma 输出),通过硬性约束规则确保设计的可控性与去 AI 味,支持 Codex、Cursor 等环境。
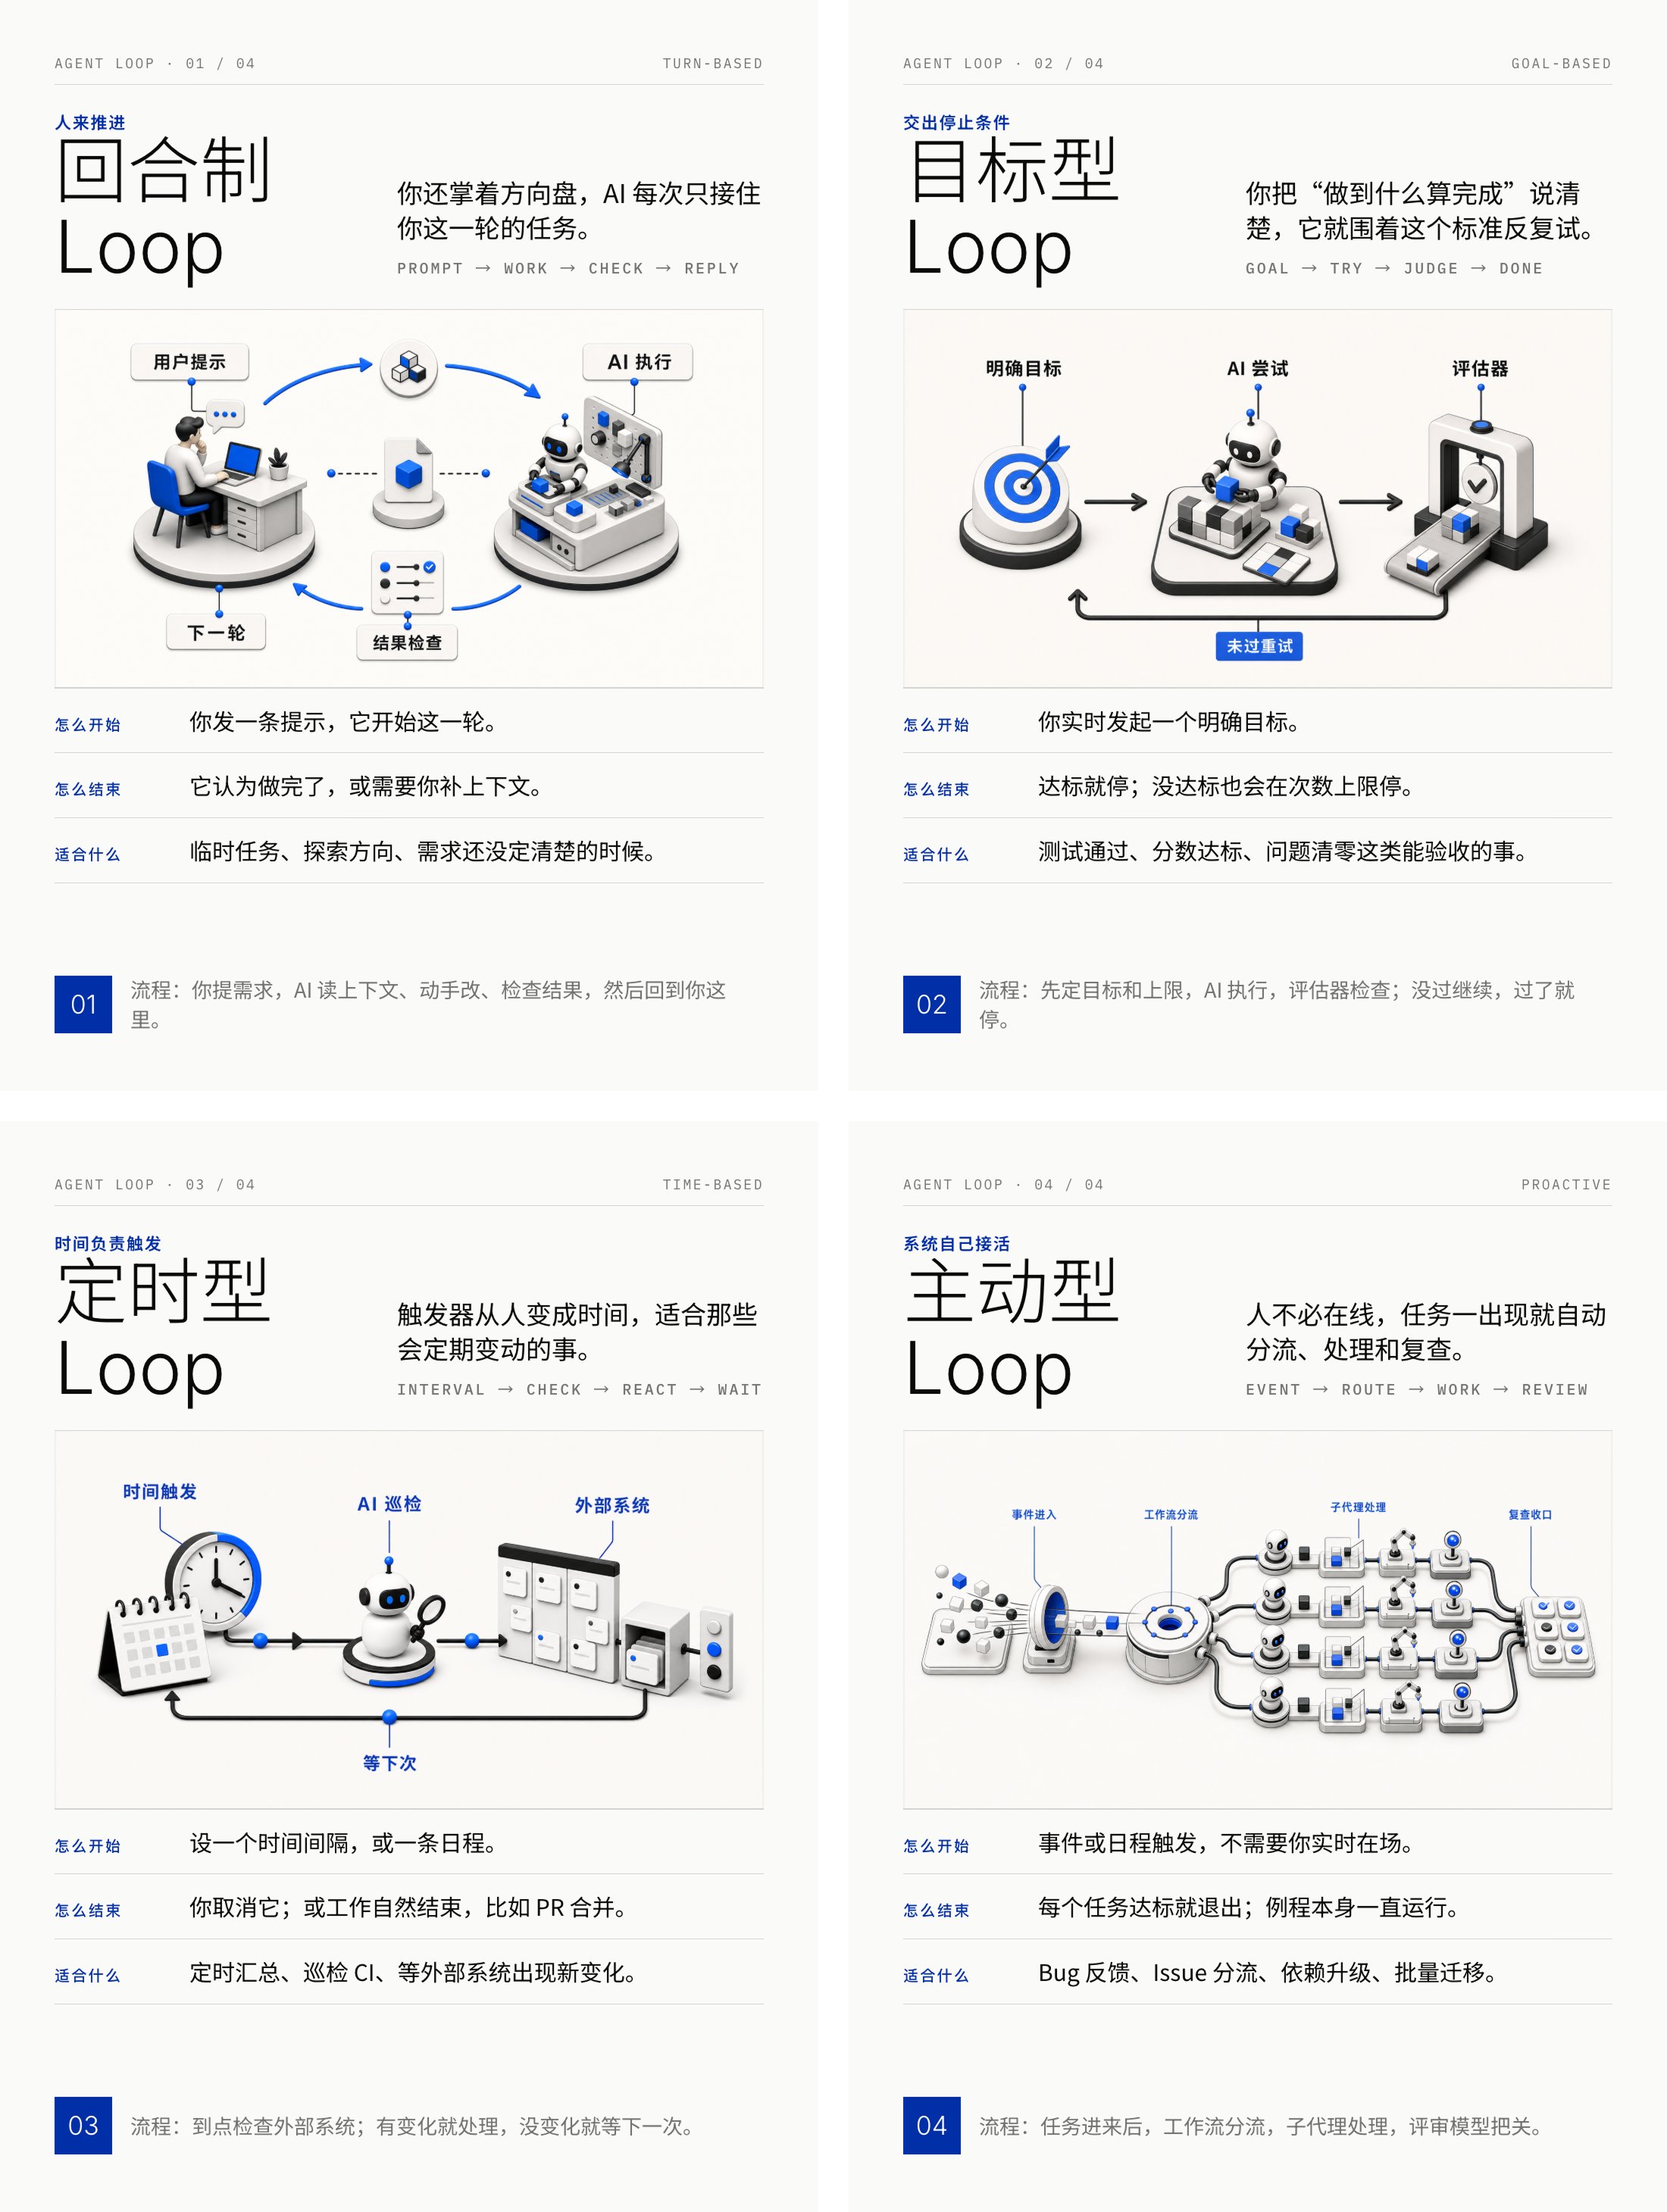
本文探讨了 Claude Code 中的“Loop(循环)”概念,即 Agent 反复循环工作直到满足停止条件。文章详细介绍了四类 Loop:回合制、目标制、时间制和主动式,并分析了各自的最佳适用场景及如何控制 Token 消耗与保证代码质量。
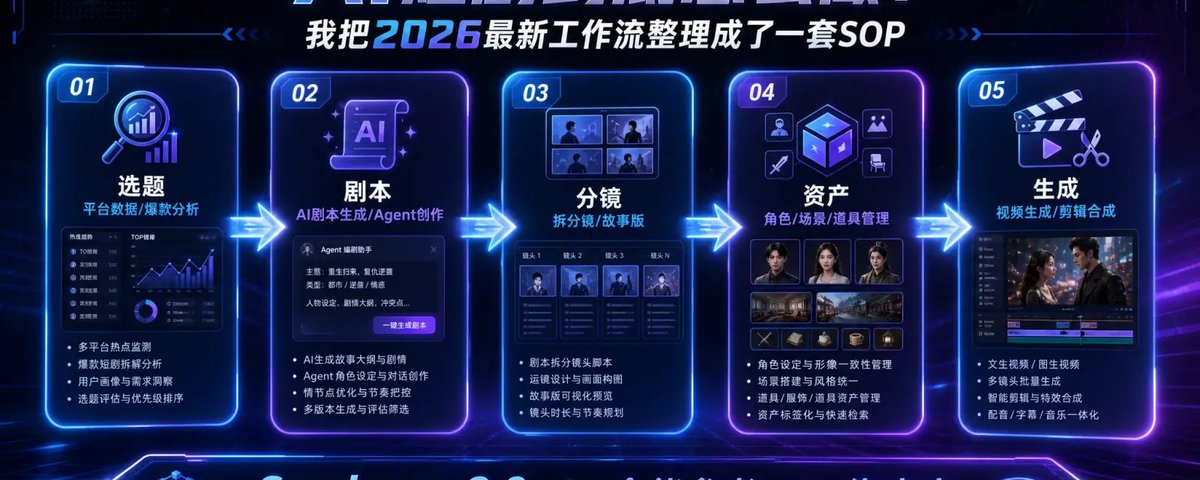
本文作者总结了2026年度AI视频创作的最新SOP,涵盖了从选题、剧本生成(如使用Agent工具)、分镜拆解、资产管理到视频生成与剪辑的全流程。重点介绍了Seedance 2.0、故事版玩法及各类辅助工具(如LibTV、小云雀)的实战应用,强调了在工具快速迭代中,选题能力与资产库管理的重要性。
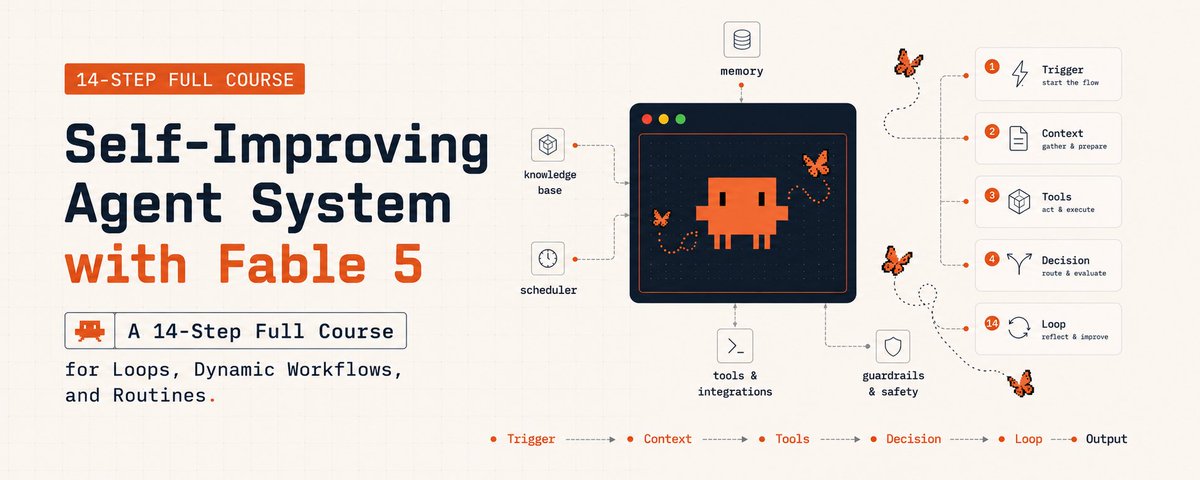
文章深入探讨了如何充分利用 Claude Fable 5 的潜能,而非仅仅将其视作上下文窗口更大的 Sonnet。作者提出了构建“自我改进系统”的 14 步路线图,区分了自我学习与自我改进,并详细阐述了基于 Loops、Dynamic Workflows 和 Routines 的三层架构。文章还提供了 Fable 5、Opus 和 Sonnet 在系统中的成本与任务分配策略。
文章探讨了在代理工程和软件工厂时代,工程师的角色转变。作者指出,随着 AI 承担更多内部执行循环,工程师必须拥有“外部循环”的问责权,负责定义质量、做出最终裁决并保证可解释性。文章区分了内部循环(能力)与外部循环(能动性),强调虽然 AI 生成代码的速度提升了,但验证、治理和人为的判断力成为了稀缺资源。
文章通过解读 Anthropic、吴恩达和微软 CEO 纳德拉关于“Loop(循环)”的不同视角,构建了一个三层模型:一楼关注技术执行效率,二楼关注人机分工与方向,三楼关注“Token 资本”与组织复利。作者指出,完整的 AI 工作流应融合这三层,并针对独立开发者提出了具体建议,强调沉淀判断力而非工具用法,以构建可跨模型迁移的专属资产。
文章以「好记性不如烂笔头」为喻,深入剖析了 AI 助手 WorkBuddy 的三层记忆架构(云端画像、本地长期记忆、工作区日志)。通过对比传统 AI 的「金鱼式」失忆,阐述了长程任务中「读写外部文件」优于单纯依赖上下文窗口的原理。同时,文章探讨了记忆与身份层如何赋予 AI 连续性,并与 OpenClaw 进行了横向对比。
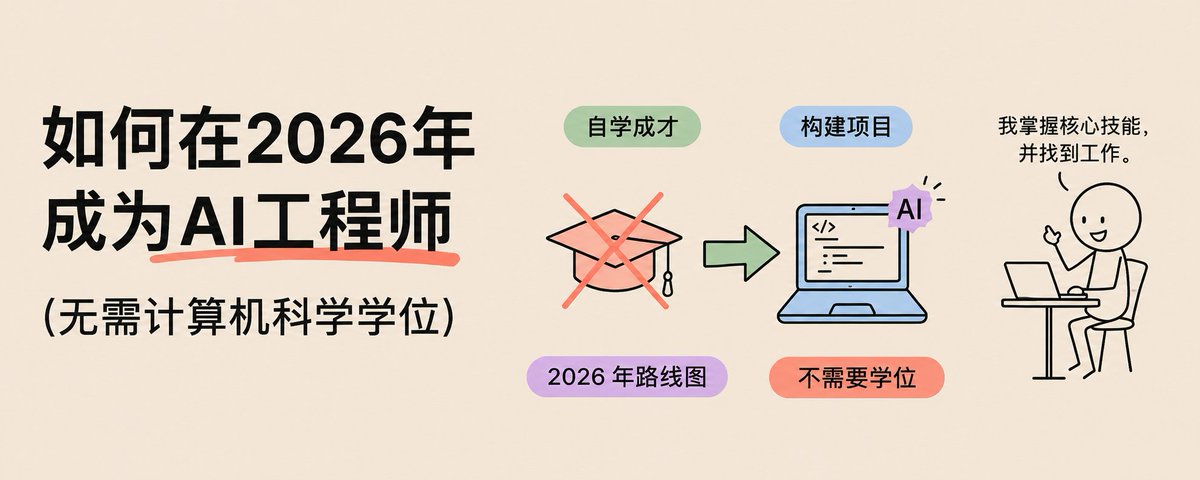
文章指出 2026 年 AI 工程师的门槛已变,不再看重学历,而是看重作品集与交付能力。作者拆解了 AI 工程师的三个核心能力:软件工程、LLM 使用及产品思维,并规划了一份为期 12 个月的六阶段实战路线图,涵盖 Python 基础、LLM API、RAG、Agent 系统开发、评估部署及求职准备。
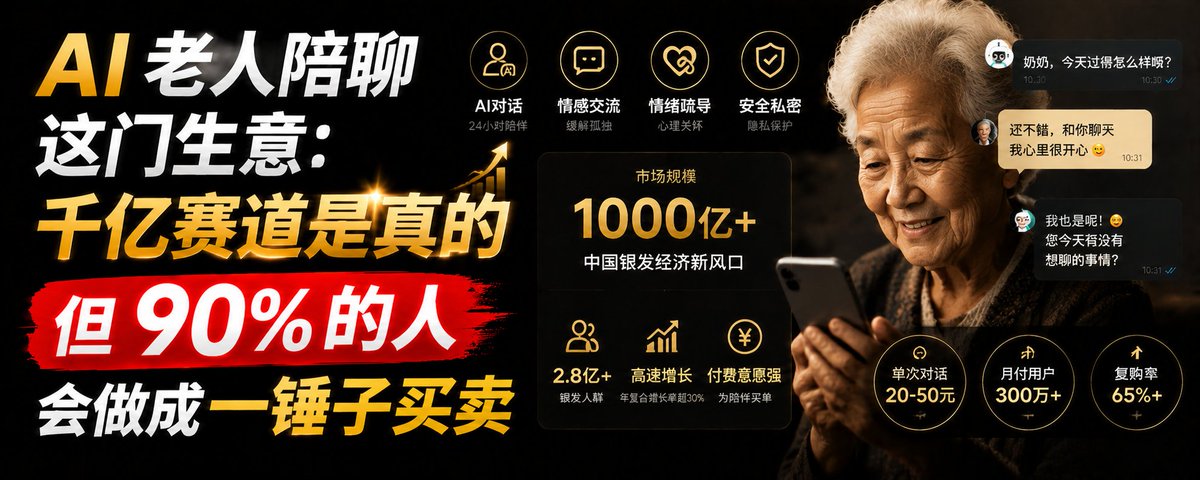
文章深入探讨了AI老人陪伴市场的现状与商机,指出虽然市场规模达千亿且痛点真实,但90%的产品因体验不佳沦为一次性消费。作者分析了硬件、软件+服务、渠道分销三种入局路径,详细拆解了成本与定价模型,并警示了复购率低、合规风险及技术幻觉等核心雷区。
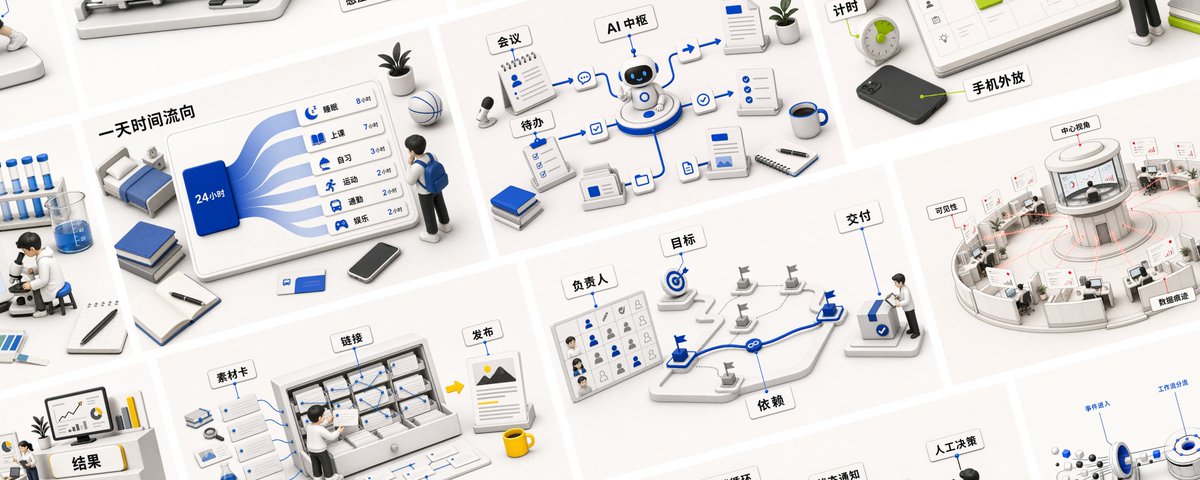
作者开源了一款名为“歸藏材质插画”的 Skill,旨在解决文章、汇报及教学中概念解释难的问题。该工具通过调用 GPT-Image 2.0,能将文本转化为风格统一、带中文标签的 3D 材质解释图。文章详细介绍了其在处理冷门概念检索、图表数据重绘以及防止 AI 乱写标签等方面的技术优化。
本文详细复盘了作者利用AI视频(Sora、Veo等)在TikTok进行带货的实战经历。起初通过简单三步法快速出单,随后因死磕产品一致性、选错昂贵模型及盲目做IP号而亏损十几万。最终总结出一套“逆向拆解+参数化生产”的SOP方法论,强调在AI生产成本趋近于零的时代,核心壁垒在于脚本创作力和系统化的数据资产,而非单纯的工具或产量。
文章深入对比了当前热门的两种 AI 编程工作流 grill-me 和 Superpowers。作者从设计初衷出发,分析了两者在多轮问答、需求对齐及执行计划上的差异。grill-me 假设开发者已有方案,通过大量提问完善细节;Superpowers 则通过 Brainstorming 引导方向,并引入多轮 Reviewer 保证质量。文章指出,选择哪种工具取决于模型的智能程度以及对长程任务处理的偏好。
文章推荐了 Codex 中 8 个具有商业变现潜力的 Skill,涵盖了小红书代运营、金融分析、企业法务、跨境电商、文档处理、虚拟主播及选题监控等领域。作者强调了这些工具不仅是插件,更应被包装为具体的交付物,适合从事接单、代运营及 AI 工作流搭建的人群使用。
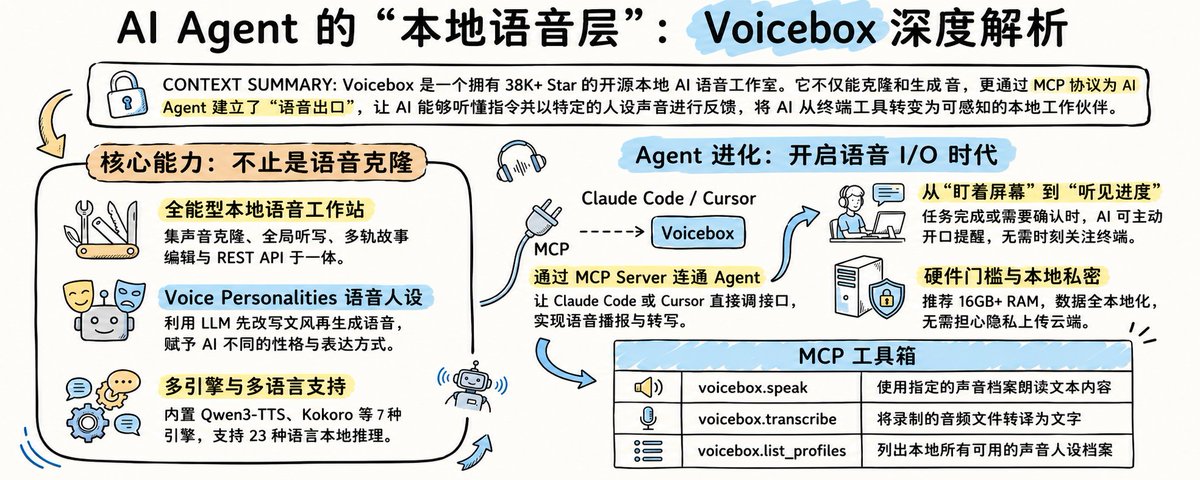
文章介绍了一款名为 Voicebox 的开源 AI 语音工作室工具。它不仅支持语音克隆、生成和全局听写,更关键的是通过内置 MCP Server,让 Claude Code、Cursor 等 AI Agent 能够调用本地语音层,实现“能听、能说”的交互闭环,弥补了 Agent 只能文字交互的短板。
文章介绍了一个名为 claude-video 的开源插件,利用 FFmpeg 场景检测和 Whisper 转录,解决了 Claude Code 无法精准看视频的痛点。该工具摒弃了随机抽帧,仅在画面变化时截帧,能准确理解图表、PPT 和 UI 变化。文中详细介绍了插件在 Claude Code、Cursor 等平台的安装方法、参数配置及会议纪要、Bug 复盘等七大实战场景。
文章介绍了 Claude 官方提出的 Loop Engineer 概念,该概念将现有的 Agent 工作流程进行了系统化梳理。文中详细讲解了四种 Loop 类型:回合制循环、基于目标的循环(GOAL 模式)、基于时间的循环以及主动循环。此外,作者还分享了关于代码库质量维护和 Token 消耗管理的优化建议,并提及了 Codex、Skills 和 Hooks 等相关工具。
阿里开源了一款名为 Zvec 的向量数据库项目,主打“纯本地、内嵌式”极简体验,号称向量界的 SQLite。该项目基于 C++ 编写,支持零配置安装,性能强悍(毫秒级搜索数十亿向量),同时兼容稠密、稀疏向量及全文检索。它非常适合本地大模型、RAG 和个人知识库开发,彻底免去了部署繁琐的后端向量服务。
这篇文章提供了一个极具洞察力的 Prompt,通过分析本地 AI Agent 的会话历史(如 ~/.claude/projects),揭示了用户真实的行为模式。该 Prompt 指导 AI 分六个阶段挖掘、蒸馏、访谈并最终生成“用户镜像”,从而指出时间浪费点、可自动化任务及真正的核心价值,旨在实现深度自我认知与工作流的彻底重构。
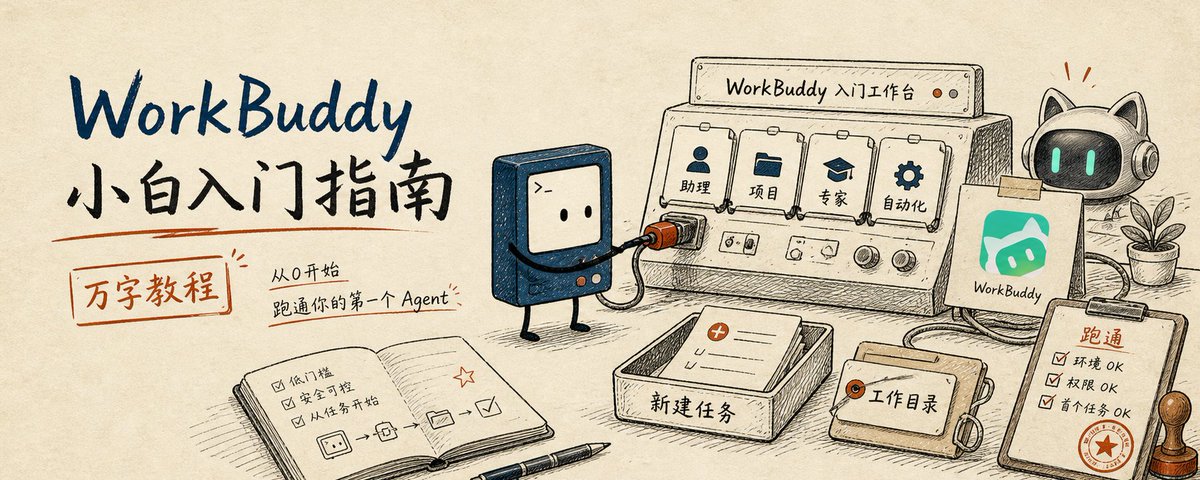
本文是一篇WorkBuddy Agent产品的深度实战教程。作者详细介绍了WorkBuddy的核心功能区(助理、项目、专家、自动化),讲解了任务场景选择、三种工作模式、模型匹配策略及Skill的使用方法。文章还通过真实案例演示了如何利用WorkBuddy进行深度调研,并强调了固定工作目录和权限管理的重要性,旨在帮助用户降低Agent上手门槛,提高工作效率。
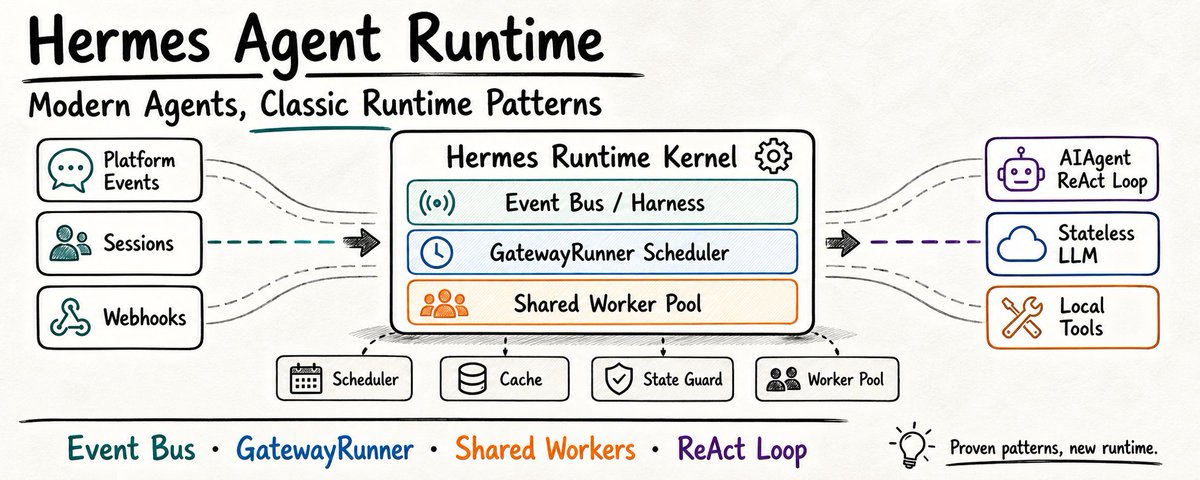
本文详细拆解了 Hermes Agent 的底层架构,将其定义为工业级运行时而非简单的 LLM 循环。文章类比前端工程模式,阐述了 Agent = Harness + Model 的核心公式。重点解析了从平台入口、适配器层、事件总线、GatewayRunner 核心调度层到 AI Agent 执行层的五层架构,揭示了 Hermes 如何通过共享线程池、会话复用和生命周期管理,实现高并发、有状态且安全可靠的 Agent 运行环境。
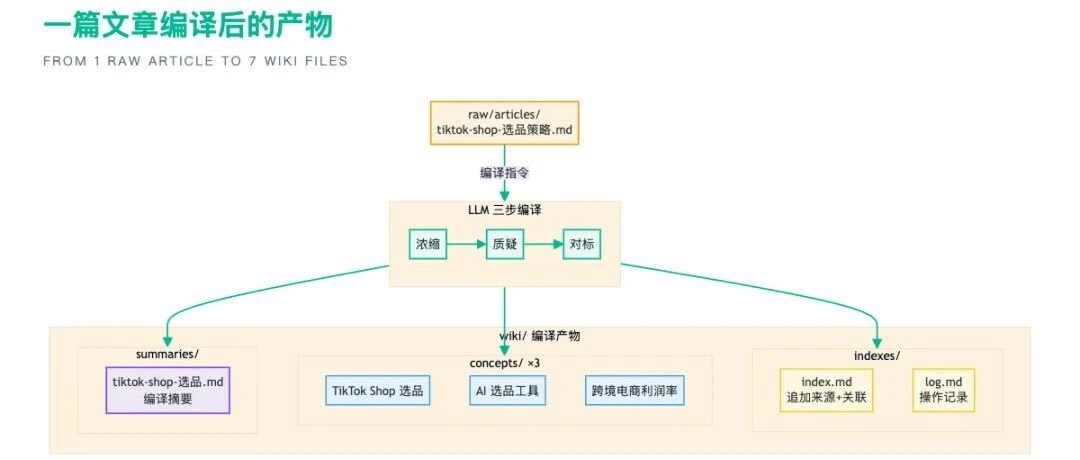
文章介绍了一套基于LLM Wiki方法论的内容生产3.0系统,解决了2.0版本中知识库信息垃圾化的问题。通过“三步编译法”(浓缩、质疑、对标)将原始文档编译为持久化Wiki结构,实现知识资产的自动积累与进化,大幅降低维护成本并提升了内容创作与知识管理的效率。
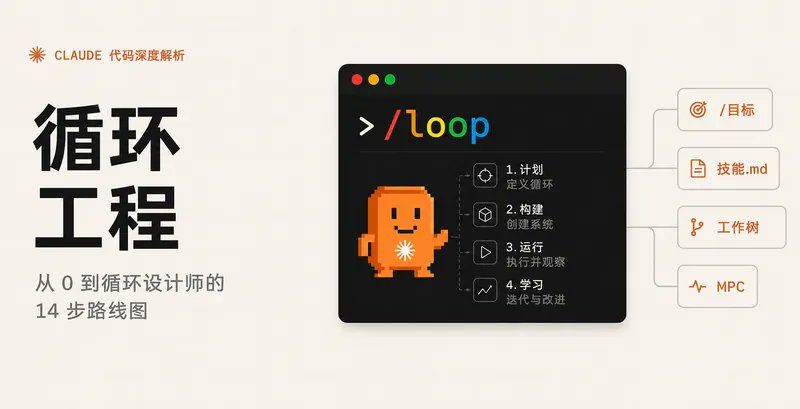
文章探讨了从手动编写提示词向设计自动化循环系统的转变。通过借鉴 Anthropic 和 Addy Osmani 的经验,文章提出了 14 步路线图,分为判断必要性、学习五个核心组件(自动化、Git Worktree、Skill、连接器、子 Agent)和搭建最小可用系统三个阶段,旨在帮助开发者利用 Agent 实现更高杠杆的工程效率。
本文讲述了退伍军人余小欢利用AI辅助写作做公众号副业的故事。他通过摸索提示词打磨、系统学习写作逻辑、建立分成合作模式等方法,运营400多个账号,一年变现超40万。案例展示了AI作为效率放大器的作用,以及坚持、试错和复制成功路径的重要性。
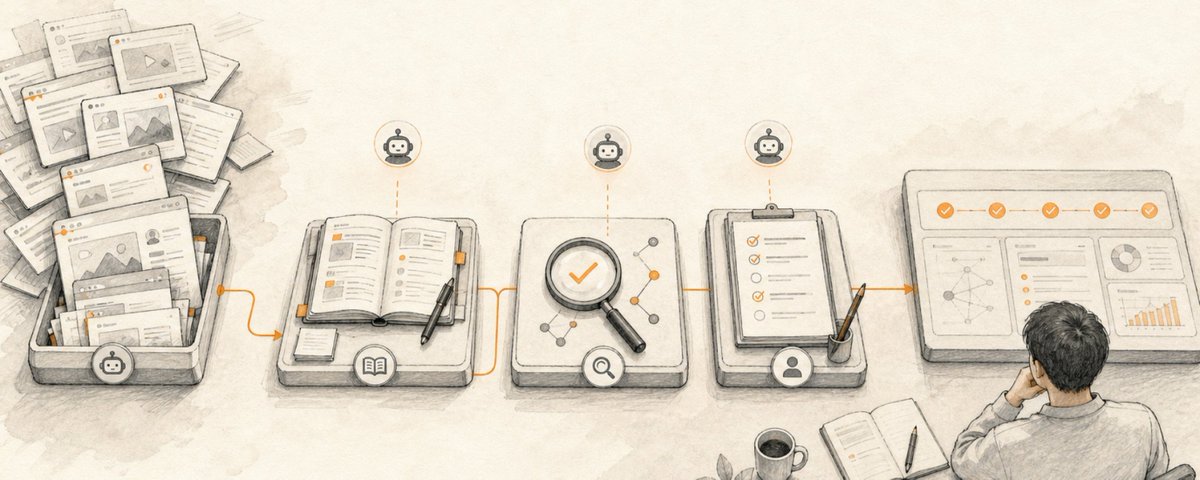
本文指出 Agent OS 的核心并非追求万能 AI 或全自动化,而是通过合理的“工位”分工来隔离上下文、责任与风险。作者以整理浏览器标签为例,详细演示了如何将任务拆解为抓取、提炼、核查、确认四个独立工位,并强调了人工确认在防止错误落地中的关键作用。
文章介绍了 Git Worktree 的功能与使用场景。通过允许一个仓库关联多个独立工作目录,Worktree 解决了开发中频繁切换分支导致的上下文丢失问题。在 AI 编程和多 Agent 协作的并行开发时代,Worktree 能有效隔离任务现场,避免互相干扰,是提升开发效率的实用工具。