Wiki 知识库

全部文档 / 标签: 线性注意力

4 篇
清除

斯坦福大学 CS329Z「Engineering AI Agents」第二讲 LLMs for Builders:Agent 工程师必修的大模型底层原理

本文深度解读斯坦福 2026 秋季课程 CS329Z 第二讲「LLMs for Builders」讲义,面向 Agent 工程师系统讲解 LLM 底层原理。内容涵盖:自回归概率分解与解码采样策略;从 RNN 到 Transformer、线性注意力的架构演进及其工程取舍;预训练、中期训练与后训练(RLHF、RLVR)管线;推理阶段的 Prefill/Decode、KV Cache、投机解码与推理时扩展;最后落脚到 Agent 开发的结构化 I/O 与上下文工程实践,强调'设计决策→局限→应用策略'的因果链。

技术 › LLM meng shao 2026-09-2919.3 KB 19.4K 60 84

16GB 无独显本地部署 Ling-3.0-tiny 实测:21.7 token/s 与推理引擎版本的秘密

作者在一台单通道 16GB 内存、无独显的 Ryzen 5 5600G 台式机上,使用 llama.cpp 官方版部署 Ling-3.0-tiny(Q4KM 量化),实测生成速度 21.70 tok/s,比配置更强的 64GB+3090 机器快近 4 倍。经排查,差异源于推理引擎版本而非硬件。文章还分析了该模型线性注意力架构带来的超低上下文内存开销(约 6.79 KiB/token),总结了思考模式、Windows 编码、线程设置三个实践坑,并给出三步部署教程,证明普通电脑即可流畅本地运行该模型。

技术 › LLM 阿良|AI 工作流 2026-08-2414.2 KB 71.3K 177 90

一文科普 主流 LLM 注意力机制

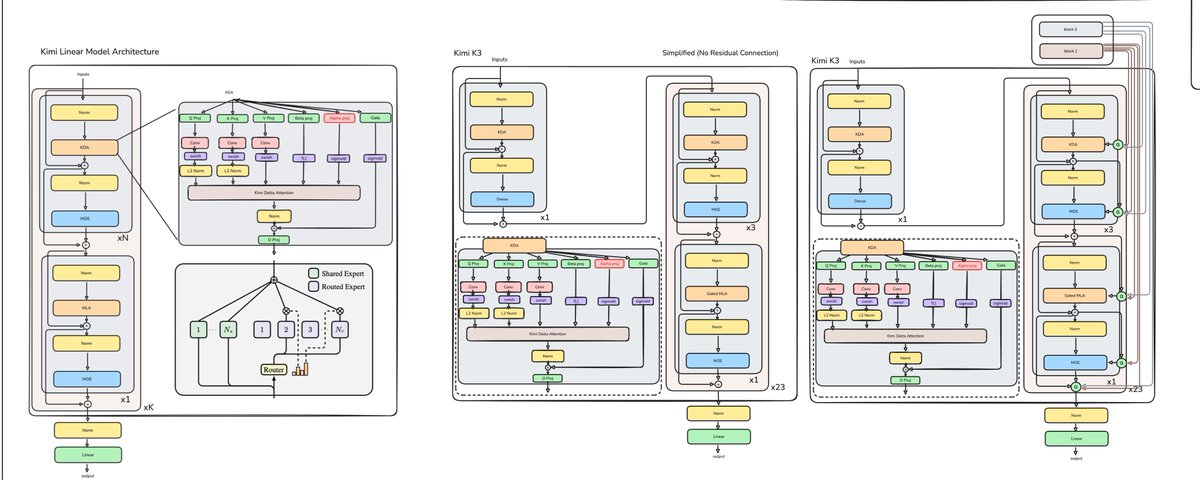
本文系统科普了主流LLM的注意力机制,指出其并非简单的单线升级,而是可组合的四个维度:KV缓存表示、注意力连接范围、序列混合器及位置稳定化技术。文章详细解析了MHA、MQA、GQA、MLA等机制对显存带宽的影响,以及全注意力、稀疏注意力、线性注意力等在降低长序列计算复杂度上的权衡。最后通过对比DeepSeek、Qwen、Kimi等代表模型,澄清了常见误区,为机制选择提供了准确的技术指导。

技术 › LLM 山景城小路 2026-08-1021.7 KB 8.6K 41 88