Wiki 知识库

全部文档 / 标签: GQA

3 篇
清除

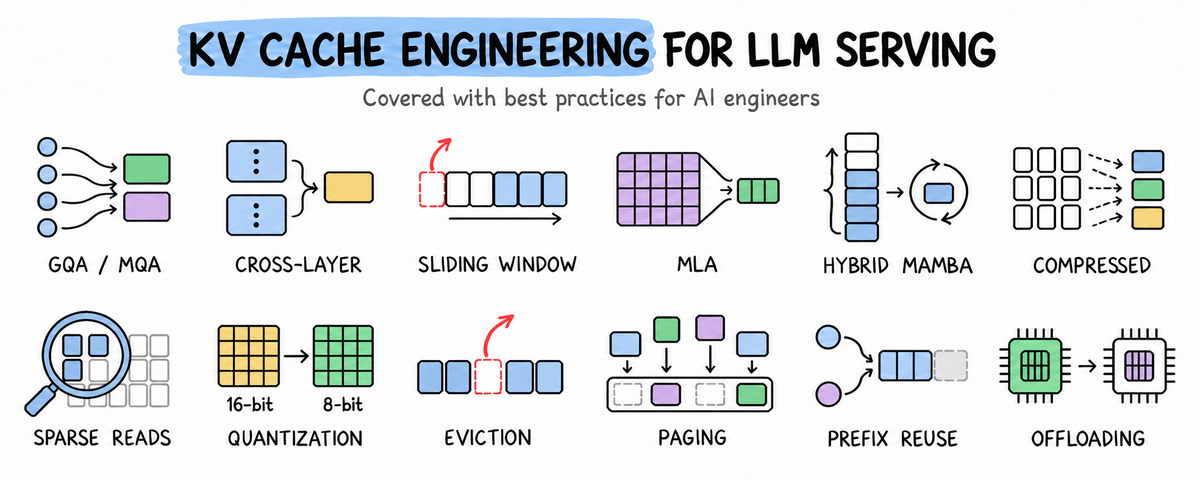
KV Cache Engineering for LLM Serving, clearly explained

文章系统讲解了LLM推理中KV缓存的工程优化。KV缓存随序列长度增长,Llama 3.1 70B单条128K序列的BF16缓存约需40GB,成为GPU内存和注意力计算的双重瓶颈。作者将12种优化技术按减少的对象分类:GQA/MQA减少KV头数量,跨层注意力减少缓存层数,滑动窗口与淘汰减少保留token数,MLA减少表示宽度,量化减少字节数,混合循环层用固定状态替代增长缓存,分页与前缀复用减少分配浪费。文章配有可运行代码示例,并分析各技术的适用场景与权衡。

技术 › LLM Avi Chawla 2026-09-0640.4 KB 206.5K 557 82

LLM 注意力机制详解:从 Self-Attention 到 MLA

文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。

技术 › LLM Akshay 🚀 2026-09-0513.4 KB 191.5K 577 75

一文科普 主流 LLM 注意力机制

本文系统科普了主流LLM的注意力机制,指出其并非简单的单线升级,而是可组合的四个维度:KV缓存表示、注意力连接范围、序列混合器及位置稳定化技术。文章详细解析了MHA、MQA、GQA、MLA等机制对显存带宽的影响,以及全注意力、稀疏注意力、线性注意力等在降低长序列计算复杂度上的权衡。最后通过对比DeepSeek、Qwen、Kimi等代表模型,澄清了常见误区,为机制选择提供了准确的技术指导。

技术 › LLM 山景城小路 2026-08-1021.7 KB 8.6K 41 88