年轻人最该戒掉的,就是复利思维
文章批判了当下流行的复利思维和长期主义叙事,指出年轻人往往被远期规划压垮,忽视了眼前的生存与反馈。作者用农民下棋、斯诺克走位、蜂巢地图等类比,引入'邻近可能'与'计算不可约性'等概念,主张未来无法提前规划,只能一步步走出来。真正有效的是做好够得着的下一步,留下能复用的成果,让每次行动把自己推进可能性更多的位置。作者强调他反对的是'复利思维'而非复利本身:复利是后半段的结果,前半段只需走好一千个下一步。
文章批判了当下流行的复利思维和长期主义叙事,指出年轻人往往被远期规划压垮,忽视了眼前的生存与反馈。作者用农民下棋、斯诺克走位、蜂巢地图等类比,引入'邻近可能'与'计算不可约性'等概念,主张未来无法提前规划,只能一步步走出来。真正有效的是做好够得着的下一步,留下能复用的成果,让每次行动把自己推进可能性更多的位置。作者强调他反对的是'复利思维'而非复利本身:复利是后半段的结果,前半段只需走好一千个下一步。
文章总结了单调队列的核心模版:队列存下标并保持单调性,通过'过期踢队首、单调踢队尾、队首即答案'三步解决滑动窗口最值问题。作者用一套通用 Python 模版讲解了五道 LeetCode 题目:滑动窗口最大值(239)、跳跃游戏 VI(1696,dp 套模版)、带限制的子序列和(1425)、和至少为 K 的最短子数组(862,前缀和+递增队列)、绝对差不超过限制的最长子数组(1438,双队列维护最大最小值),帮助读者快速掌握单调队列这一 O(n) 高效算法技巧。
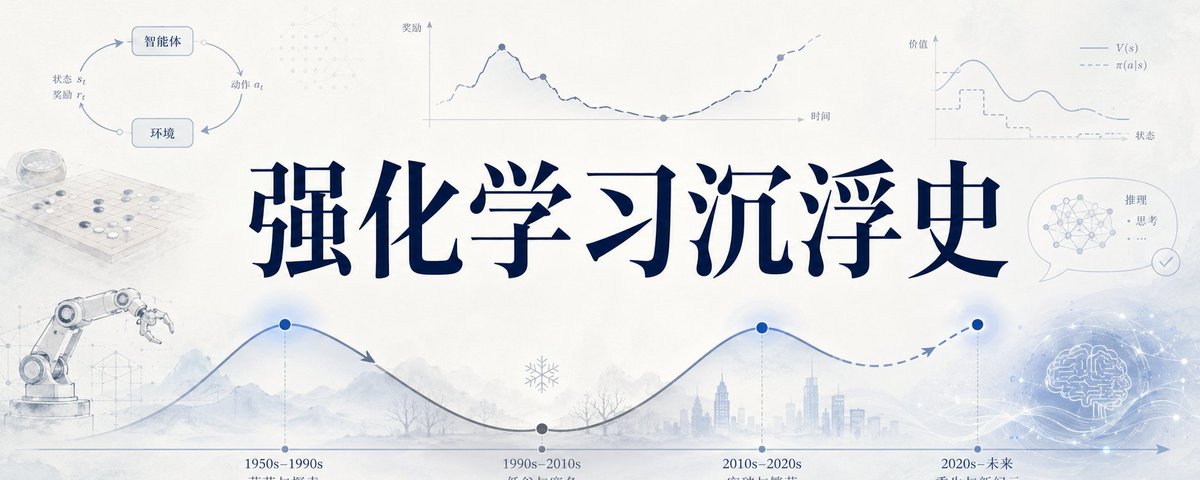
文章回顾了强化学习七十年跌宕起伏的发展历程。从心理学的效果律与数学的动态规划这两条根源讲起,梳理了教科书时期的理论奠基与早期边缘化。随后,深度学习的引爆带来了黄金年代,DQN与AlphaGo的辉煌让强化学习备受推崇。然而,样本效率等缺陷曾让其一度跌入谷底。如今,这门学科在大模型时代通过RLHF等技术奇迹般重生,再次站到了AI舞台的中央。