Wiki 知识库

全部文档 / 标签: AlphaGo

4 篇
清除

Let a billion mathematicians bloom

文章回应25位菲尔兹奖得主关于AI将损害数学的宣言。作者以AlphaGo‘第37手’为例:AI出现后职业围棋水平不降反升,因为开源引擎让每位棋手拥有超人类导师。作者认为菲尔兹奖得主担心的核心问题真实存在——AI正在把解题的成果与过程分离,但他们忽略了更深层的变化:验证成本的历史性反转。过去猜测便宜而验证昂贵,如今借助Lean等证明助手和形式化证书,验证变得廉价可复制。数学的制度体系(同行评审、长学徒制)都是围绕验证稀缺建立的。AI不会摧毁数学,反而会让数百万人得以参与,让‘十亿数学家’绽放。
技术 › LLM Emad 2026-09-1227.3 KB 69K 477 71

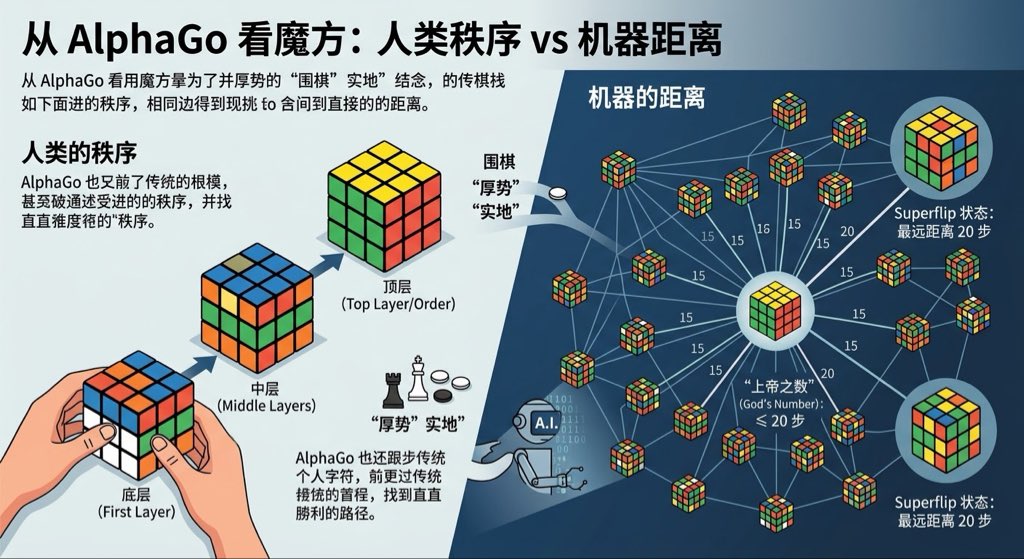
从 AlphaGo 的角度看魔方游戏:人类看秩序,机器看距离

文章以围棋和魔方为例,探讨人类智能与机器智能的本质差异。人类因算力有限,发明层先法、定式等启发式结构来压缩复杂度,依赖局部秩序感;而 AlphaGo 等机器则直接在状态空间中寻找最短路径。三阶魔方虽有约4.3×10^19种状态,但上帝之数证明任意状态距复原最多20步,如 Superflip 看似对称易解实则最远。人类看到的是局部颜色与秩序,机器看到的是全局坐标与距离,人类的“智慧”或许只是适应自身算力限制的辅助结构。

其他 › 杂谈 云中月 (@MoonAtCloud) 2026-08-216.8 KB 67

强化学习沉浮史:从深度寒冬到大模型封神

文章回顾了强化学习七十年跌宕起伏的发展历程。从心理学的效果律与数学的动态规划这两条根源讲起,梳理了教科书时期的理论奠基与早期边缘化。随后,深度学习的引爆带来了黄金年代,DQN与AlphaGo的辉煌让强化学习备受推崇。然而,样本效率等缺陷曾让其一度跌入谷底。如今,这门学科在大模型时代通过RLHF等技术奇迹般重生,再次站到了AI舞台的中央。

技术 › LLM snowboat 2026-07-2357.2 KB 25.6K 45

高手都在用这个思维工具,收割普通人

文章借AlphaGo与Libratus AI的决策逻辑,阐述了“状态评估”优于“预测未来”的思维模型。通过对比两位创业者的经历,指出普通人常因追逐风口而忽略自身当前状态与目标之间的可达性(转移概率)。作者强调在商业和职业选择中,应依据当前确定的信号和一手经验做决策,而非依赖宏观数据或等待虚无缥缈的确定性。

职场 › 职业发展 block0 2026-05-188.0 KB 4.5K 36 83