Wiki 知识库

全部文档 / 标签: LLM架构

7 篇
清除

Is ENGRAM free lunch? Does it not impact AI model quality?

文章深入分析Engram技术:将序列嵌入存储到可卸载至DRAM的嵌入表中,节省HBM内存、减少FLOPs,从而降低AI推理成本。在参数和训练预算相同的对照实验中,Engram-27B相比MoE-27B不仅没有降低性能,反而显著提升(MMLU从57.4升至60.4)。作者指出Engram参数分配存在约20-25%的最优区间,过高会挤占MoE专家参数损害性能,且不能完全替代FFN(FFN负责概念运算)。结论认为Engram确实是一种'免费午餐',DeepSeek、美团LongCat、Qwen等已采纳该技术。
技术 › LLM GDP 2026-09-2710.0 KB 38.3K 64 73

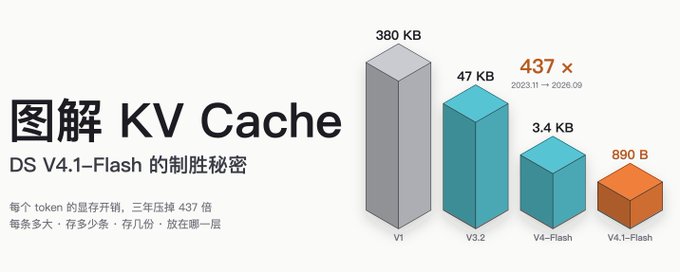
图解 KV Cache——DS V4.1-Flash的制胜秘密

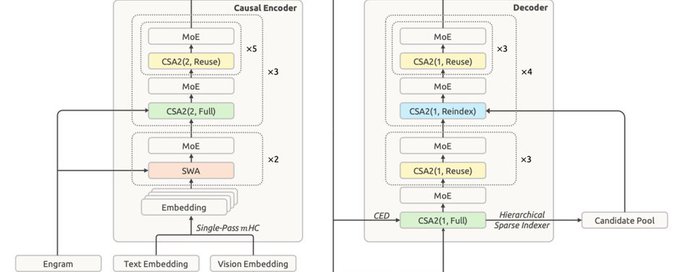
本文图解 DeepSeek V4.1-Flash 如何将单 token 全局 KV Cache 从 V1 的 389KB 压缩至 890 字节。文章先介绍 KV Cache 原理与显存瓶颈,再梳理 GQA、MLA、量化、稀疏注意力、跨层复用等六次关键突破,最后详解 V4.1 在架构、精度、部署三层的联合优化,包括 CED、CSA2 三模式、层级稀疏索引器与 FP4 量化,并给出 890 字节的推导过程。

技术 › LLM WquGuru 2026-09-1423.6 KB 68.6K 376 83

DeepSeek V4.1 Flash:架构学习笔记

本文是 DeepSeek V4.1 Flash 的架构学习笔记。文章详细解析了其 Causal Encoder-Decoder(CED)结构,该结构通过前后半段网络的不对称计算减少长输入处理成本。核心创新在于 KV 缓存压缩:通过 CSA2 跨层共享全局 KV、FP4 量化、分层稀疏检索以及 SWA 有界回放等设计,将全局 KV 降至约 890 字节/token,持久化缓存约为上一代的 1/8。文章还讨论了这些设计如何协同工作,使长上下文在 Agent 场景下更可负担。

技术 › LLM AI Dance 2026-09-1113.1 KB 21.3K 203 79

Test-Time Compute Engineering: 构建推理引擎

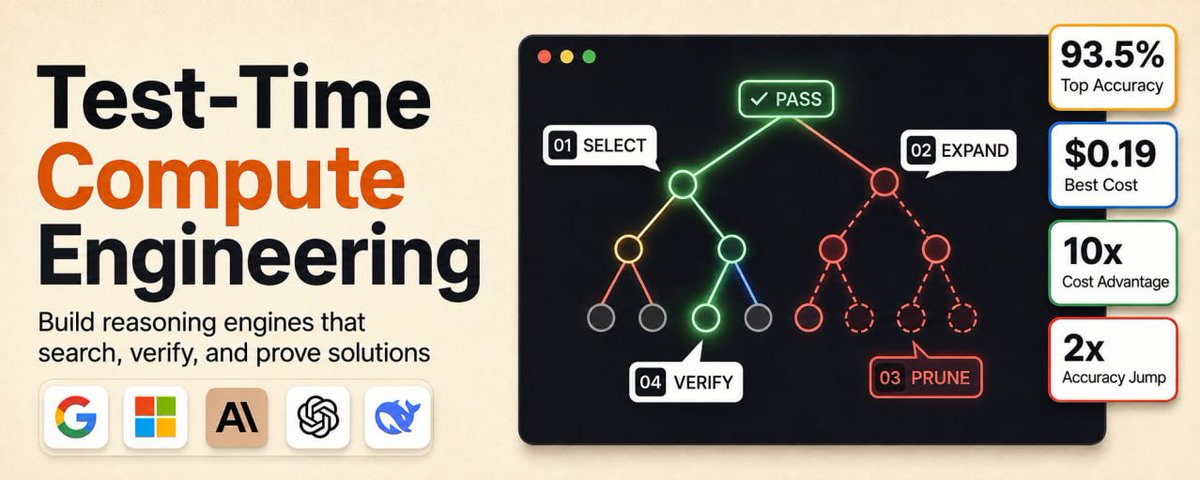
本文探讨了 Test-Time Compute Engineering,即通过将算力从预训练转移到推理阶段,利用动态预算分配、搜索树拓扑、过程奖励模型验证和剪枝策略,构建在回复前进行自主推理的 AI 引擎,以突破预训练规模定律的限制并提高复杂任务的准确性。

技术 › LLM marfin 2026-08-0610.5 KB 411.3K 175

12步打造拥有持久记忆的自我进化Claude智能体

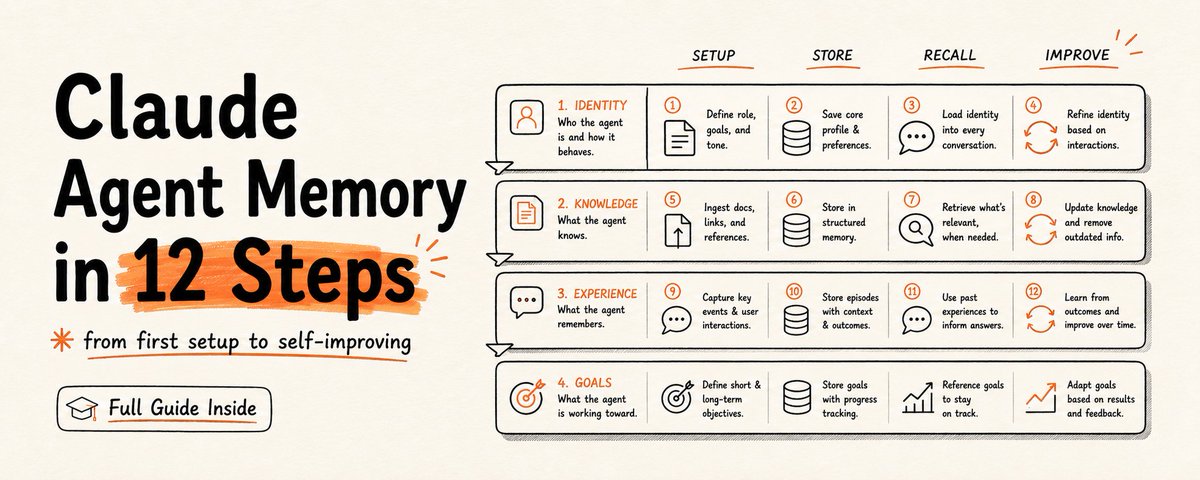
本文详细介绍了如何通过12个步骤为Claude智能体构建四层记忆架构:利用内置记忆功能、创建Project作为固定工作流、编写动态增减的持久化记忆文件,以及配置Dreaming自我迭代机制。文章指出,只有结合长期偏好存储与任务模式总结,才能让Agent跨越会话限制,从单次执行的“金鱼”进化为持续自我优化的虚拟员工。

技术 › Agent Codez 2026-05-2412.2 KB 840.3K 471 92

四大 Agent 编排模式详解

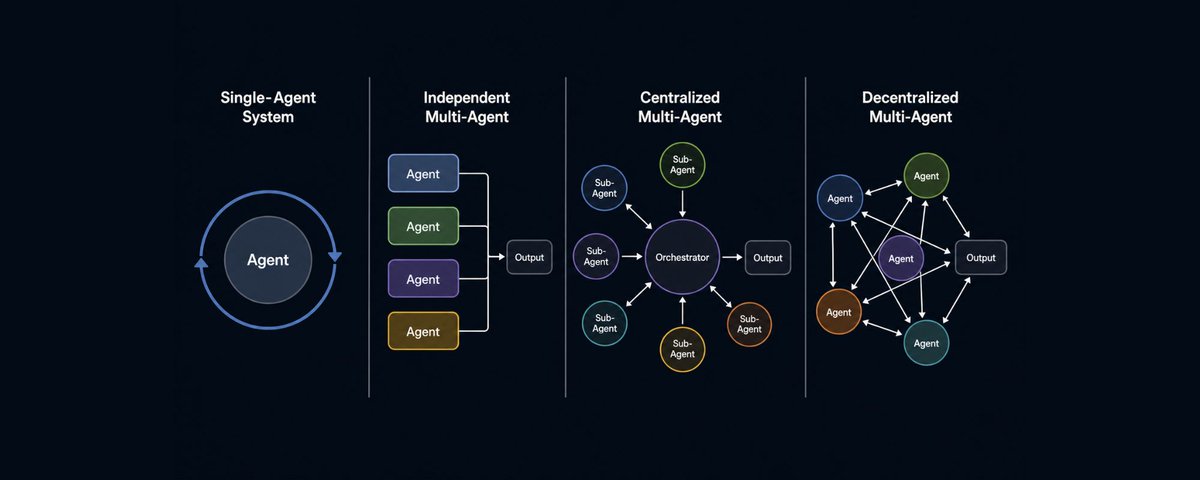
本文探讨了单提示词 LLM 工作流的局限性,并介绍了 NYU 研究者测试的四种多 Agent 编排架构:顺序流水线、并行分发合并、分层主管-工人模式以及反思式自纠循环。文章详细分析了每种模式的技术原理、优缺点、Token 效率及适用场景,指出分层模式在成本与精度间最平衡,而自纠模式虽精度最高但成本高昂且难以扩展。

技术 › Agent AlphaSignal AI 2026-05-0611.0 KB 18.5K 249 82

驾驭 Claude 的智能 | 构建应用的 3 个关键模式

本文探讨了如何随着 Claude 能力的进化,调整构建 AI 应用的策略。文章提出了三个核心模式:善用 Claude 已知的通用工具(如 bash 和文本编辑器),赋予其自主编排和上下文管理能力,以及谨慎设定框架边界以平衡安全与效率。文章强调了减少外部框架对模型能力的过度干预,让 Claude 自主决定工具调用与数据处理,从而提升应用的性能和成本效益。

技术 › Agent 宝玉 (译) / Lance Martin 2026-04-0321.0 KB 41.8K 264 90