Wiki 知识库

全部文档 / 标签: FP8

4 篇
清除

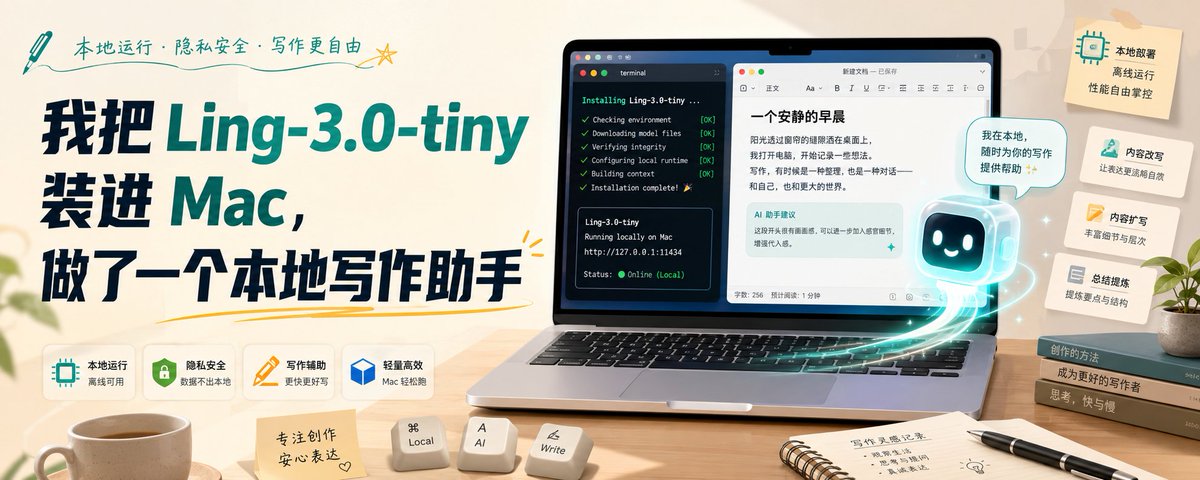
我把 Ling-3.0-tiny 装进 Mac,做了一个本地写作助手

作者记录了在 Mac mini(M4、16GB)上部署蚂蚁开源的混合推理小模型 Ling-3.0-tiny 的完整过程:编译 Ollama 实验分支、下载 FP8/BF16 权重并导入,验证服务后搭建了一个只调用本机接口的写作页面。随后用一篇真实口述稿进行四轮写作测试——提炼结构、检查问题、局部改写和反馈调整,发现模型擅长结构整理与问题扫描,但润色时 AI 味重,难以还原作者口吻。文章还对比了 FP8 与 BF16 的输入输出速度,并总结了端口冲突、上下文设置和接口安全等部署注意事项,最后给出将其用于写作第一轮辅助的定位。

技术 › LLM 小墨同学 2026-08-3017.2 KB 28.5K 40 82

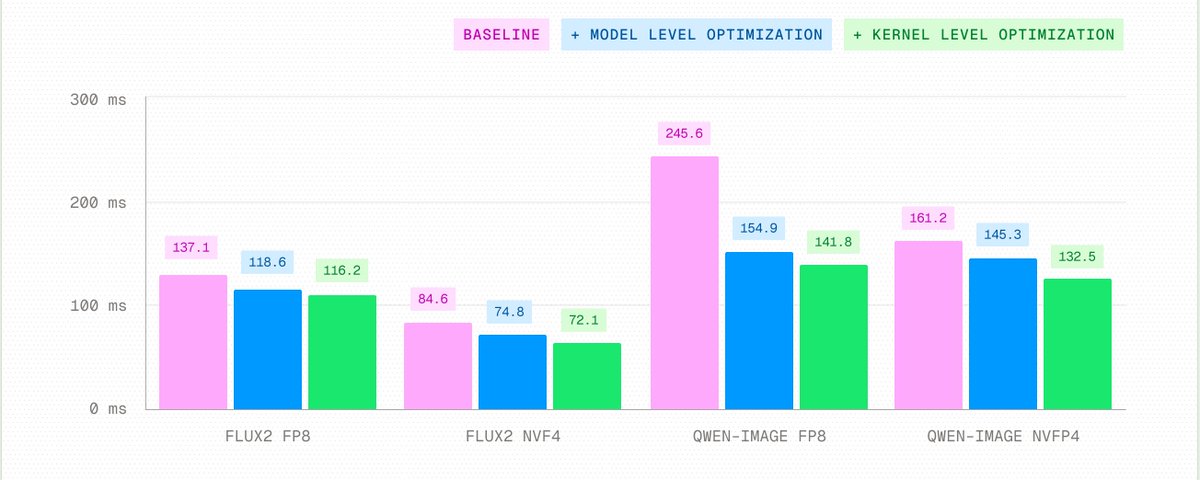
Agentic Kernels in Production

文章介绍了一个面向生产环境的 agentic kernel 优化框架,弥合基准测试与生产部署之间的差距。框架分为模型级优化和单 kernel 优化两层:先对完整 workload 进行 profile,提出算子融合、冗余消除等改进,再并行探索多个 kernel 实现并迭代优化。框架还具备自我改进机制,将成功与失败的优化经验存入知识库供后续复用。在实际部署中,该框架将 Qwen-Image 端到端延迟降低 42.3%,FLUX.2 降低 15.2%,MiniMax M3 吞吐提升 5.5%,具体优化包括 FP8 scale 预打包、QKV 投影融合、归一化与量化融合等。

技术 › LLM Brian Li 2026-08-2917.1 KB 265.1K 758 77

我把 Ling-3.0-tiny 塞进 DeepSeek Harness 跑真实任务实测

作者在 MacBook Pro M3 Max 上本地部署蚂蚁百灵开源的 Ling-3.0-tiny(总参数 7.9B、激活 1.3B),编译 Ollama 的 BailingMoeV3 分支导入 FP8 与 BF16 两个精度版本,实测输出速度分别约 106 和 81 tokens/s。随后通过 OpenAI 兼容协议将模型接入 DeepSeek Harness,让它把自己的底稿《文科生学 AI,先补一层计算机常识》重写成公众号文章。结果模型完整跑完任务、未瞎编内容,但句子偏碎且擅自添加内容,直出终稿尚早。文中还总结了部署与配置过程中的一系列坑及避坑指南。

技术 › LLM 得否 2026-08-2418.3 KB 18.3K 45 86

Qwen3.8-27B 本地部署教程(全网最详细版)

本文详细介绍了阿里通义千问团队发布的Qwen3.8-27B模型的本地部署方法。文章首先分析了不同硬件配置下可选的模型量化版本,然后提供了两套部署方案:一是使用GGUF+llama.cpp,适合24GB显存或Apple Silicon用户;二是使用官方FP8+vLLM,适合48GB以上NVIDIA显存用户。此外,还介绍了如何将模型接入IDE、Agent或自定义应用,并总结了常见的五个部署陷阱及解决方案。最后,作者强调了本地部署在数据隐私、模型可控性和理解底层技术方面的价值。

技术 › LLM Smartpig 2026-08-1510.3 KB 60.1K 342 91