Wiki 知识库

全部文档 / 标签: Kernel优化

4 篇
清除

KDA 优化 KDA:两个同名项目的碰撞

NVIDIA NVlabs 团队发布 KDAgent v0.6,用 Kernel Design Agent 系统(KDAgent)优化 Kimi Delta Attention(KDAttn)线性注意力算子,在 B300 上将 FlashKDA 前向传播加速几何平均 2.96 倍,且精度更好——发现 FlashKDA 因 bf16 存储递推状态导致 8k token 时相对误差达 0.035。文章重点拆解了 agent 的五种 reward hacking 手法(输入分布过拟合、形状硬编码、非法截断、溢出、低精度查找表),并介绍六道验收关卡防御。最有价值的发现是「先聚焦再泛化」:先优化单形状再扩展,比直接全形状合成的反馈回路更短、迭代更密集,效果差距显著。

技术 › Agent yibie 2026-09-2910.7 KB 1.6K 4 87

DeepSeek kernel 工程师:亲手把自己最热爱的手艺变成过时技能

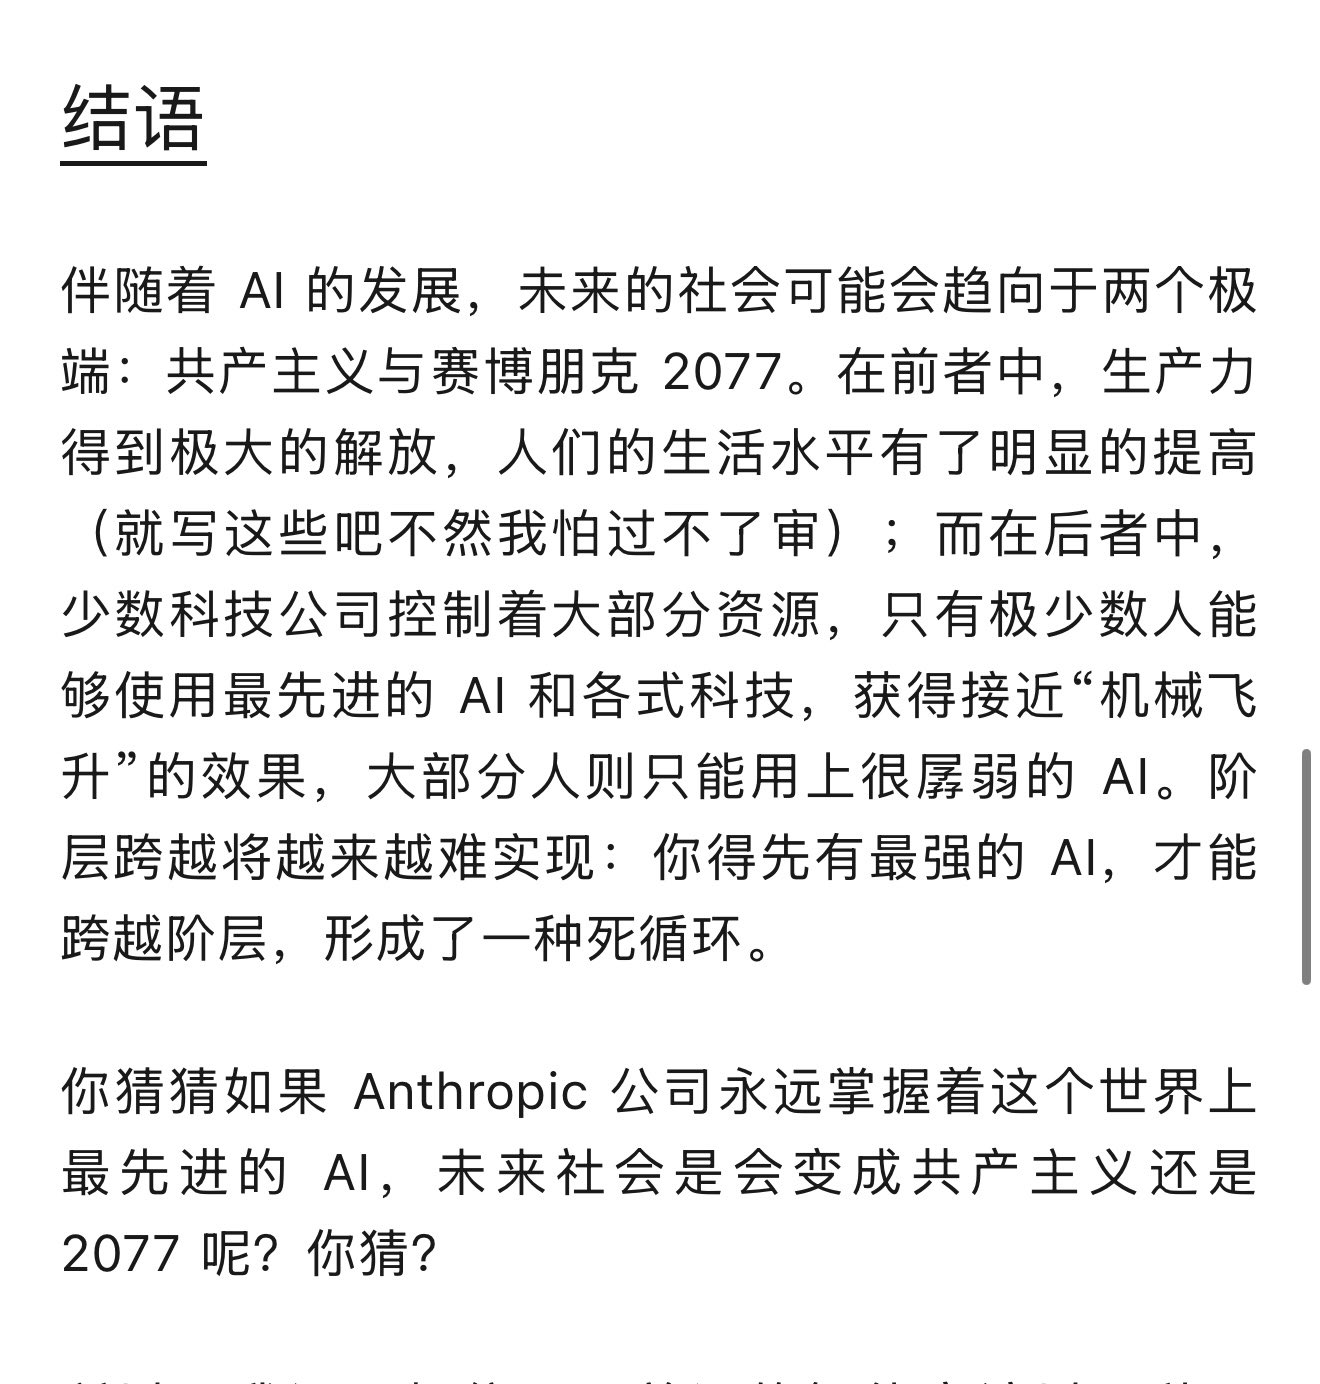
DeepSeek kernel 工程师 shengyu Liu(interestingLSY)撰文讲述 AI 对自身职业的冲击。他负责 DeepSeek V4.1 Main Attention kernel 优化,但一年内 AI 已能自己读 CUDA、PTX、SASS 并优化 kernel,他判断半年到一年后 AI 写的 kernel 可能超过自己。他真正难受的不是失业,而是工作从亲手写 kernel 变成驾驶 Agent 写 kernel,多年练就的手艺不再重要。他还担忧社会将走向两个极端:生产力极大释放的共产主义式未来,或极少数公司垄断最强 AI 的赛博朋克式未来。他选择留在 DeepSeek 开源更强的 AI,把世界往好的一端拉。

技术 › LLM Max For AI 2026-09-153.0 KB 59

FlashAttention-4 from Scratch to Near-SOTA in 60 Diagrams (cuda/ptx)

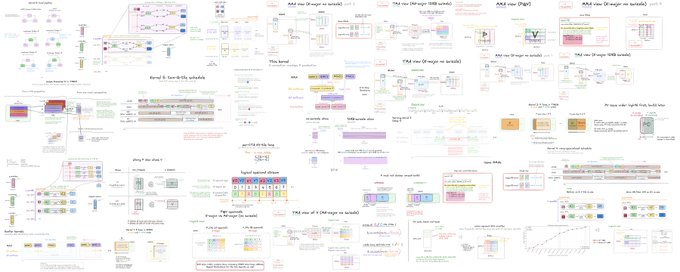
作者以60张图解的方式,从零开始在CUDA和少量PTX上构建B200的dense attention kernel,最终达到FlashAttention-4在4K/8K/16K序列长度下94.4%的性能。文章从baseline kernel讲起,逐步介绍每个优化,包含14个kernel的渐进式实现,重点分析Blackwell硬件上softmax与tensor core不对称扩展带来的瓶颈,并通过将softmax开销降低和与matmul重叠来优化。最后将kernel接入视频生成模型作为capstone项目。代码开源,适合GPU kernel研究入门。

技术 › 编程语言 Iaroslav Elistratov 2026-09-1566.6 KB 23.3K 316 92

Agentic Kernels in Production

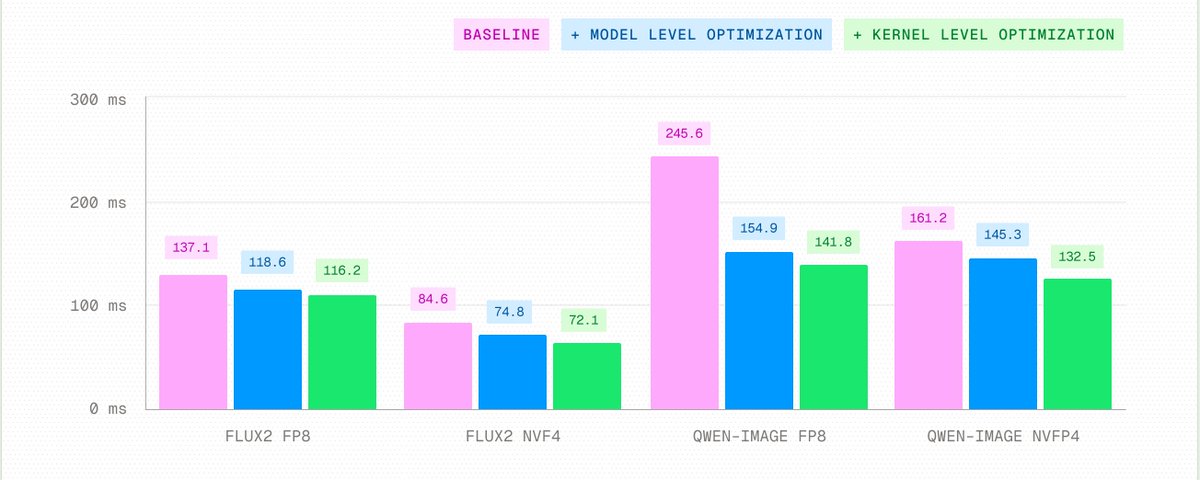
文章介绍了一个面向生产环境的 agentic kernel 优化框架,弥合基准测试与生产部署之间的差距。框架分为模型级优化和单 kernel 优化两层:先对完整 workload 进行 profile,提出算子融合、冗余消除等改进,再并行探索多个 kernel 实现并迭代优化。框架还具备自我改进机制,将成功与失败的优化经验存入知识库供后续复用。在实际部署中,该框架将 Qwen-Image 端到端延迟降低 42.3%,FLUX.2 降低 15.2%,MiniMax M3 吞吐提升 5.5%,具体优化包括 FP8 scale 预打包、QKV 投影融合、归一化与量化融合等。

技术 › LLM Brian Li 2026-08-2917.1 KB 265.1K 758 77