Wiki 知识库

全部文档 / 标签: Transformers

5 篇
清除

Hugging Face 详细教程:从调用模型到微调与部署

本文是一篇 Hugging Face 平台的系统教程,从零讲解大模型开发的完整工作流:安装环境、登录 Hub、用 Pipeline 快速推理、理解 Tokenizer、加载模型、使用 Datasets 处理数据、用 Trainer 微调模型、通过 LoRA/PEFT 高效微调大模型、上传模型到 Hub,以及用 Spaces 部署 Gradio Demo。文章还涵盖模型选择要点、常见问题排查(如显存不足、tokenizer 配置、训练效果差)和分阶段学习路线,并附官方文档链接,适合想将大模型真正用起来的开发者入门与进阶。

技术 › 工具与效率 Mr Panda 2026-10-0712.1 KB 9.3K 40 80

小白入门:Hugging Face vs GitHub 测评与零基础学习路径

本文为零基础学习者提供 GitHub 和 Hugging Face 两套可执行的学习路线。GitHub 路线分 3 阶段:第 1 周入门(核心概念与图形化工具操作)、第 2-3 周进阶(Git 命令、团队工作流、Pull Request 与开源参与)、第 4 周实战(搭建个人作品集)。Hugging Face 路线也分 3 阶段:第 1 周平台认知与在线体验、第 2-4 周本地调用 Transformers 库与简单微调、第 5-6 周开发并部署 AI 应用。文章还给出不同基础学习者的时间分配建议,所有推荐资源均免费,每天学习 1-1.5 小时即可从 0 到 1 完成入门。

技术 › 工具与效率 Modengsir AI 2026-09-068.0 KB 2K 16 72

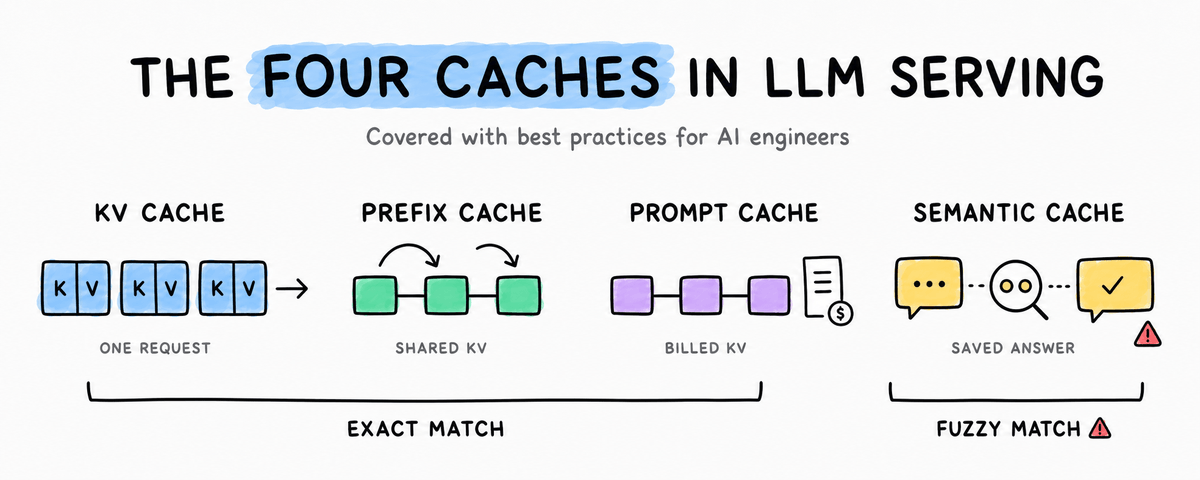
LLM 中的 KV Cache、Prefix Cache、Prompt Cache 与 Semantic Cache 详解

文章系统讲解了 LLM 推理中四层常被混淆的缓存机制:KV cache 存储单次请求的注意力张量;Prefix caching 在服务端以 token ID 哈希链为键复用这些张量;Prompt caching 是服务商对该查找的计费版本;Semantic cache 则以嵌入向量的余弦相似度为键存储完整响应。前三层为精确匹配、不影响正确性,未命中只损失延迟和费用;第四层为模糊匹配,可能返回错误答案。文章基于 transformers v5 提供可运行代码示例,涵盖缓存增长、内存带宽瓶颈、GQA/MLA/量化等优化手段,以及阻碍缓存复用的五类常见问题。

技术 › LLM Avi Chawla 2026-08-2833.6 KB 1.7M 1.4K 85

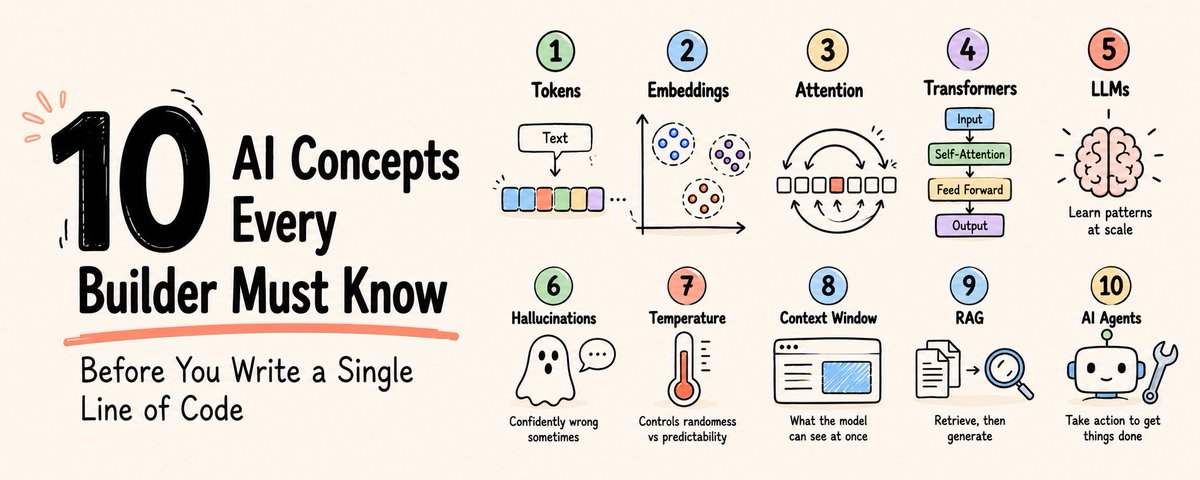
开发者在写代码前必须理解的 10 个 AI 核心概念

本文阐述了 AI 开发者在编写代码前必须掌握的 10 个核心概念,而非急于动手写代码。文章解释了 Tokens(计费基础)、Embeddings(语义理解)、Attention(上下文机制)以及 Transformers(模型引擎)等原理,深入剖析了 LLM 的本质、幻觉产生的原因、Temperature 对输出的控制作用以及上下文窗口的重要性。理解这些心智模型,能帮助开发者避免盲目调试,构建出更稳定、高效的 AI 应用。

技术 › LLM Rahul 2026-06-0412.8 KB 584.7K 402 76