Wiki 知识库

全部文档 / 作者: 纳米AI

2 篇
清除

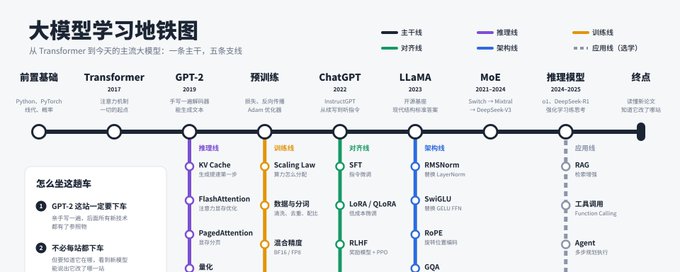
大模型学习地铁图:从 Transformer 到今天的主流大模型

文章以地铁图为比喻,为大模型学习者规划了一条清晰的学习路线。主干线按演进顺序设置八站:前置基础、Transformer、GPT-2(强调亲手实现作为锚点)、预训练、ChatGPT 时刻(RLHF)、LLaMA、MoE 稀疏专家、推理模型(o1/R1),终点是能独立读懂新论文。五条支线按兴趣选修:推理优化(KV Cache、FlashAttention、量化)、训练(Scaling Law、分布式并行)、对齐(SFT、LoRA、DPO、GRPO)、架构(RMSNorm、RoPE、MLA)、应用(RAG、Agent)。最后给出建议:GPT-2 必须亲手写一遍,主干加一至两条支线即可入门,学习原理时动手推算。

技术 › LLM 纳米AI 2026-10-2010.4 KB 52K 871 88

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65