从 Kimi K3 看下一代 MoE 架构的转折点:LatentMoE
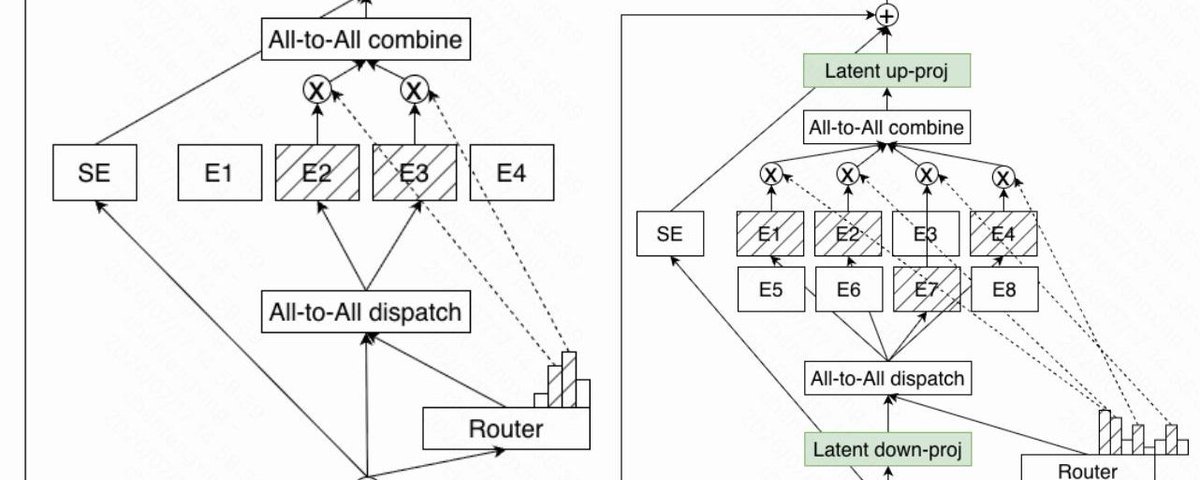
文章分析了 2026 年大模型架构的新趋势 LatentMoE。通过对比 NVIDIA Nemotron 3 Super 和 Moonshot AI Kimi K3,揭示了 LatentMoE 如何通过将 token 投影到低维潜在空间,大幅降低内存和通信开销,从而在同等推理成本下激活更多专家,提升模型性能与效率。
文章分析了 2026 年大模型架构的新趋势 LatentMoE。通过对比 NVIDIA Nemotron 3 Super 和 Moonshot AI Kimi K3,揭示了 LatentMoE 如何通过将 token 投影到低维潜在空间,大幅降低内存和通信开销,从而在同等推理成本下激活更多专家,提升模型性能与效率。
OpenRLHF 作者发布了新的强化学习框架 Molt。该框架采用纯 PyTorch 栈,核心代码仅约 9000 行,专注于 Agentic RL 研究。它支持 Qwen3.5-397B 到 GLM-5.2 753B 等超大规模 MoE 模型训练,无需依赖 Megatron,具备高度的代码可读性和可修改性。

