Wiki 知识库

全部文档 / 标签: 大模型训练

3 篇
清除

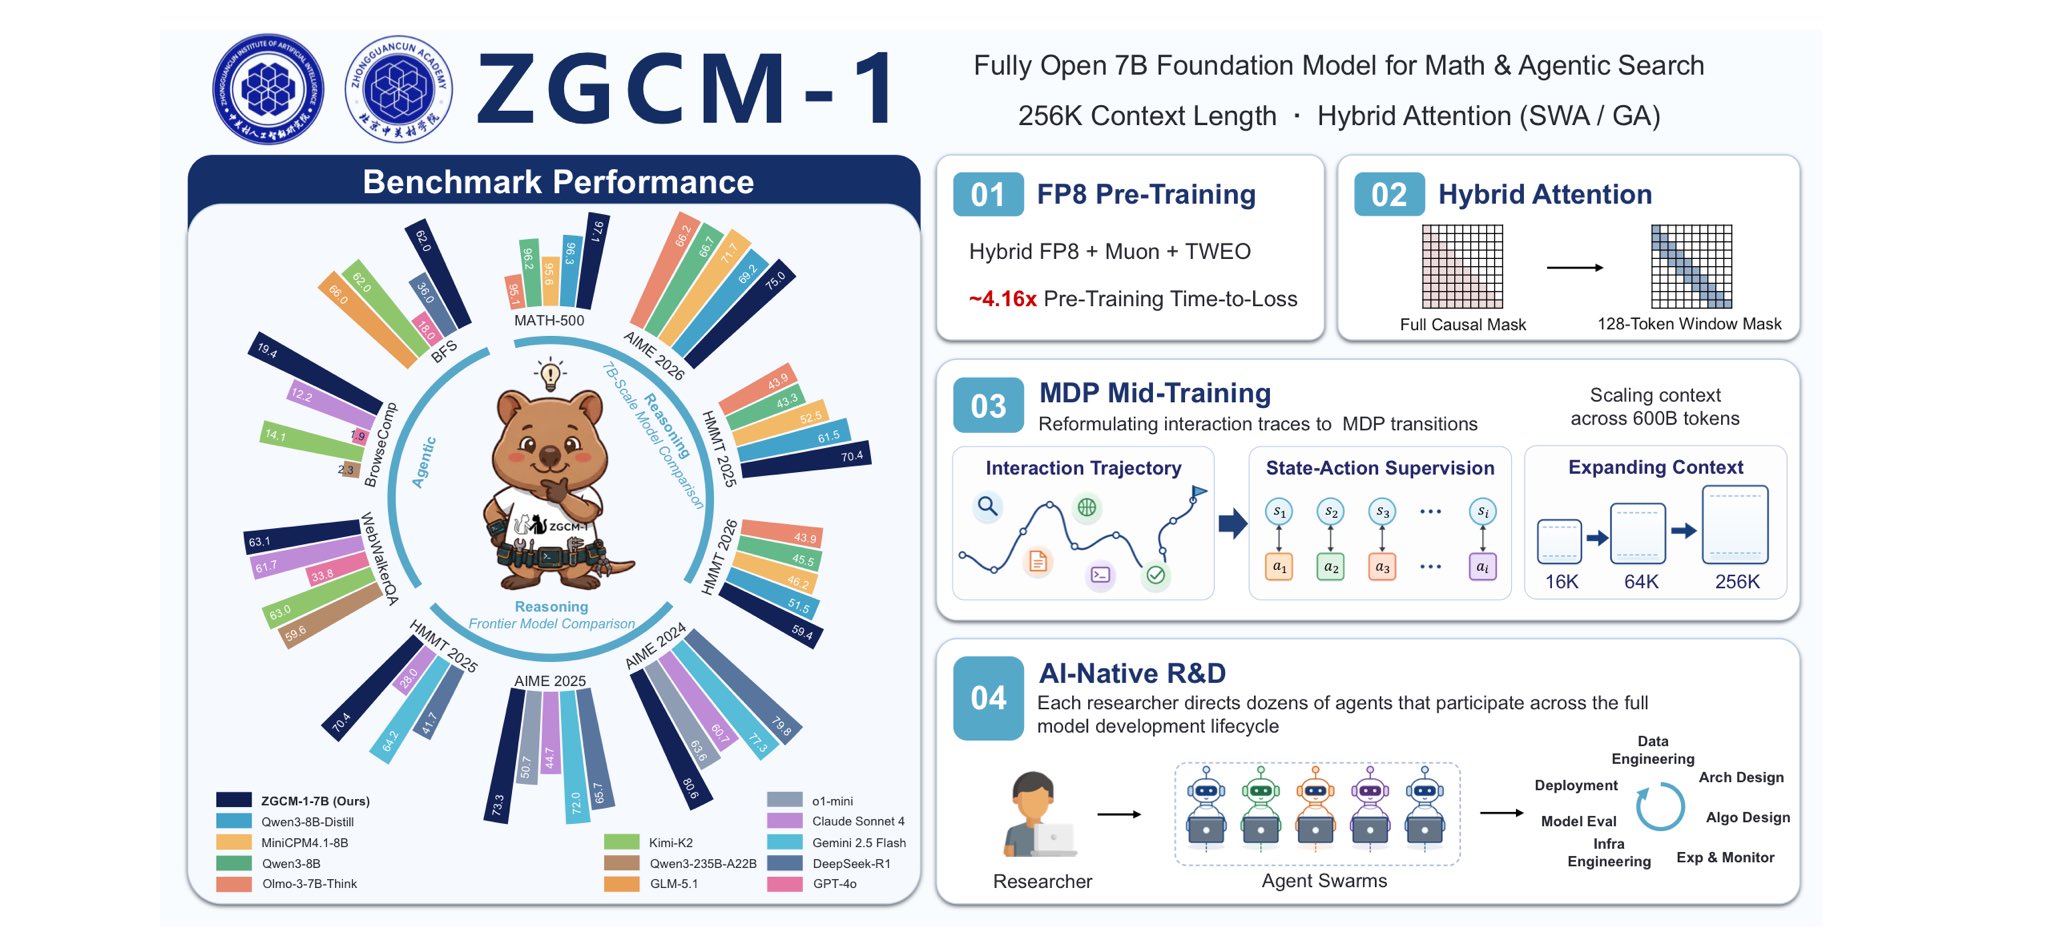
中关村学院 3 个月从零训练 7B SOTA 模型的启示

作者评述中关村学院何纪言老师带领 7 位博士生用 3 个月从预训练、中训练到后训练完全自主训练出 7B 模型并达到 SOTA 水平。文章提出三点观察:一是当前模型能力远未到全自主程度,在架构设计、算法设计等方面仅达 L2 辅助水平;二是模型训练会者不难,MiMo V2.6 RL 仅花 300 多万美金即达高水平,说明关键是人才而非算力堆砌;三是数据是新的代码,数据质量如同代码质量一样重要,该模型在数据清洗、课程学习、上下文扩增和 RL 优化上做了深入工作。

技术 › LLM Bojie Li (@bojie_li) 2026-09-262.6 KB 63

OpenRLHF 作者发布 Agentic RL 框架 Molt:9K 行核心代码支持超大规模 MoE 训练

OpenRLHF 作者发布了新的强化学习框架 Molt。该框架采用纯 PyTorch 栈,核心代码仅约 9000 行,专注于 Agentic RL 研究。它支持 Qwen3.5-397B 到 GLM-5.2 753B 等超大规模 MoE 模型训练,无需依赖 Megatron,具备高度的代码可读性和可修改性。

技术 › LLM 青稞社区 2026-07-1610.2 KB 9.5K 81

你不知道的大模型训练:原理、路径与新实践

本文深入探讨了大模型训练的全链路流程,指出2026年模型效果的差距主要源于后训练阶段。文章从预训练底座、数据配方、系统架构约束、后训练(SFT/RLHF/DPO)以及 Eval/Reward 机制五个维度,解析了如何通过工程化手段提升模型实际落地效果,并引用了 DeepSeek、Llama 等实例。

技术 › LLM Tw93 2026-04-0333.6 KB 650.9K 86

