Wiki 知识库

全部文档 / 标签: 负载均衡

9 篇
清除

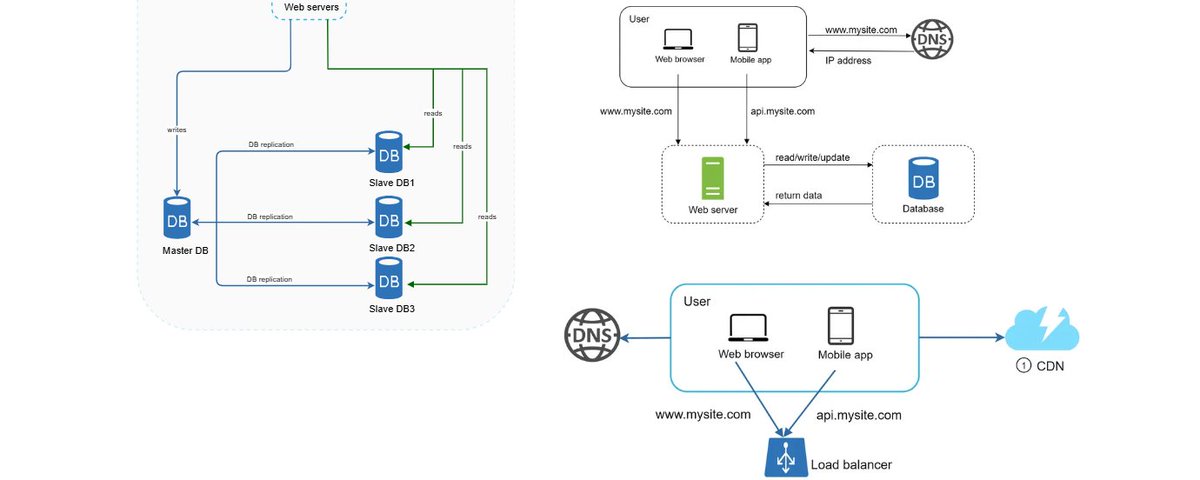
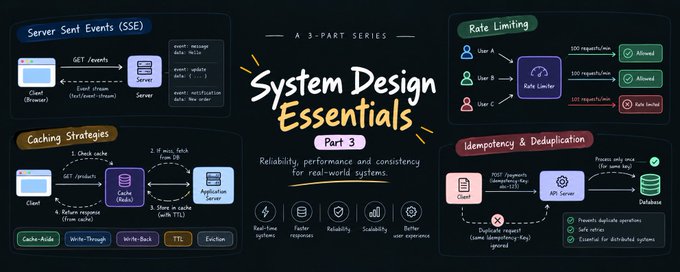
System Design Essentials - Part 3

本文是System Design Essentials系列的第三部分也是最后一部分,聚焦系统设计中的优化技术。文章详细介绍了缓存概念、缓存命中与失效,以及五种缓存策略:Cache Aside、Read Through、Write Through、Write Around和Write Back。此外还讲解了幂等性、幂等键、去重机制及其在分布式系统中的重要性,并分析了分布式系统的优势与挑战(一致性、可用性、容错性、延迟),最后深入解释了一致性哈希的原理及其在服务器扩缩容时减少请求重映射的作用。

技术 › 后端 Anurag 2026-10-0615.7 KB 15K 355 75

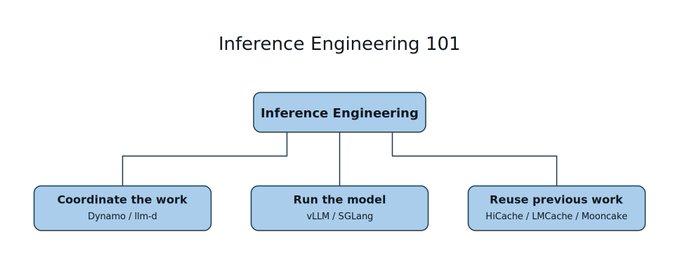
The Inference Engineering Skills Map

作者从 B2B SaaS Web 开发转向推理工程一个月后分享的入门知识地图。文章将推理工程分为三大类:协调工作(Nvidia Dynamo、llm-d 负责路由、调度与扩展,需智能负载均衡)、运行模型(vLLM、SGLang 处理批处理、张量并行、prefill/decode 分离)、复用先前工作(KV 缓存与 HiCache、LMCache、Mooncake 实现跨 GPU/CPU/NVMe 的分层前缀缓存)。作者强调从 Web 开发转型并不难,不需要精通 CUDA,先跑起模型、发送流量,再逐层深入即可。

技术 › 后端 Nick Khami 2026-09-118.5 KB 17.7K 512 73

杭州线下活动回看:我是怎么让 Grok Bot 额度更耐用的

作者从两块钱的 SuperGrok 试用号出发,分享了为 Grok Build 开发 PC 桌面端 Grok App 的经历,以及如何让 Grok Bot 维护 Awesome Grok Bot 仓库。面对 Grok Bot 一周额度烧光的困境,作者提出将 Grok Bot 作为调度端、把执行任务交给 Grok Build 的方案,进而总结出"能力路由 + 额度路由"的三层架构(规划、调度、执行),实现多模型、多订阅之间的额度负载均衡。文章还分享了本地授权迁移到 Bot 虚拟机的"邪修"技巧和 X 开发者积分的节省策略,核心理念是:不要让一个 Agent 干完所有活,让每个模型干自己最擅长的事。

技术 › Agent 铁柱AGI 2026-09-0610.9 KB 70.5K 98 81

Ai Vibe Coding:小白也能看懂的产品稳定性教程

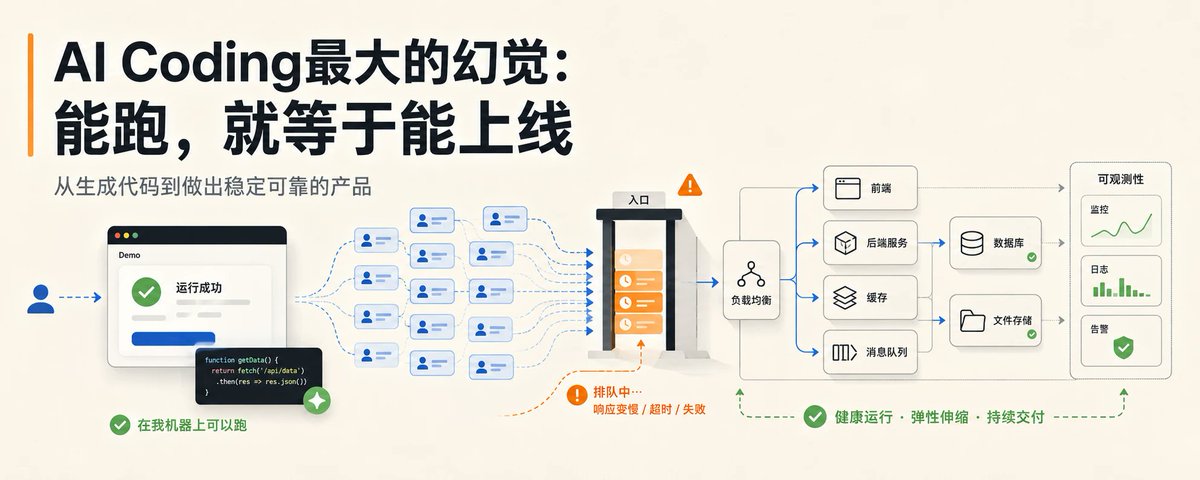
文章以面包店从街角小店成长到全国连锁的故事为比喻,系统讲解网站如何应对用户增长与稳定性挑战。从单体架构(一台烤箱)讲到垂直扩展、数据库索引、N+1 查询优化、缓存与缓存失效、水平扩展、负载均衡与自动扩缩容,再延伸到 Docker 容器化、CI/CD、可观测性、读写分离、微服务拆分、CDN 内容分发,以及限流、队列与异步处理等高并发应对手段。用通俗类比帮助零基础读者理解前后端、数据库、缓存等核心概念,掌握系统扩容与稳定性的基本方法论。

技术 › 后端 苏乐 2026-09-0333.6 KB 55.2K 67 79

同样 $100 X 开发者积分,为什么我能用一年

文章介绍了如何节省 X 开发者积分的使用方法。核心策略是将任务拆分:查信息走 Grok Build 的 x_search(消耗 Grok 订阅额度,不扣开发者积分),读写操作走开发者控制台创建的 APP 凭证(比连接器功能更全且价格相同)。作者详细演示了从创建 App、开通读写权限、生成凭证到在 Grok Bot 中完成授权并成功发帖的完整十二步流程。还提醒了一个坑:发帖正文包含域名会按带 URL 计费($0.20 vs $0.015),建议链接放评论区。通过这种负载均衡方式,$100 积分可以高效使用很长时间。

技术 › Agent 铁柱AGI 2026-08-319.6 KB 27.3K 49 81

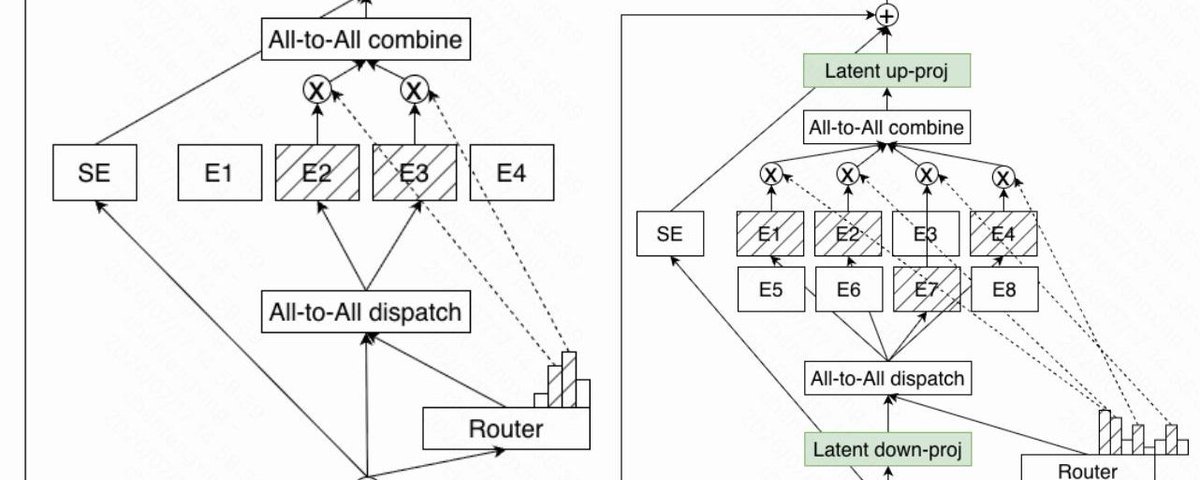
从 Kimi K3 看下一代 MoE 架构的转折点:LatentMoE

文章分析了 2026 年大模型架构的新趋势 LatentMoE。通过对比 NVIDIA Nemotron 3 Super 和 Moonshot AI Kimi K3,揭示了 LatentMoE 如何通过将 token 投影到低维潜在空间,大幅降低内存和通信开销,从而在同等推理成本下激活更多专家,提升模型性能与效率。

技术 › LLM 青稞社区 2026-07-208.2 KB 21.8K 189

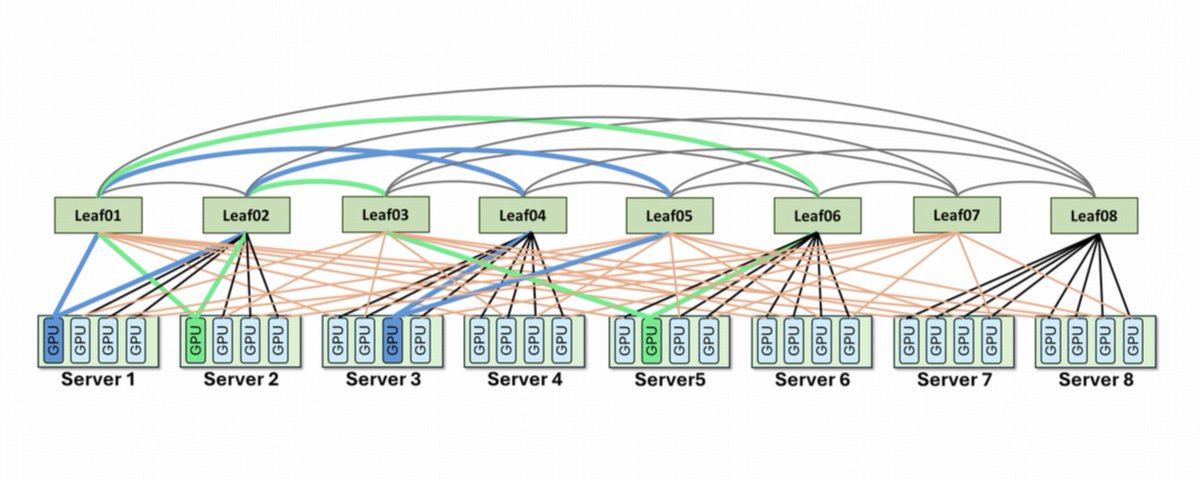
下一代 LLM 推理网络:ZCube 如何缓解网络瓶颈

文章探讨了随着长上下文推理和 Prefill-Decode 解耦成为主流,网络如何成为 LLM 推理集群吞吐量和延迟的关键瓶颈。Z.ai、Harnets.AI 和清华大学联合开发了 ZCube 网络架构,通过扁平化拓扑和混合轨道设计,有效解决了传统 ROFT 架构下的流量负载不均衡问题。生产环境基准测试显示,ZCube 仅通过架构优化便实现了交换机成本降低 33%、吞吐量提升 15% 以及 TTFT 延迟降低 40.6% 的显著收益。

技术 › DevOps Z.ai 2026-05-2134.3 KB 204.1K 926 77