阿里开源 Zvec:像 SQLite 一样极简的嵌入式向量数据库
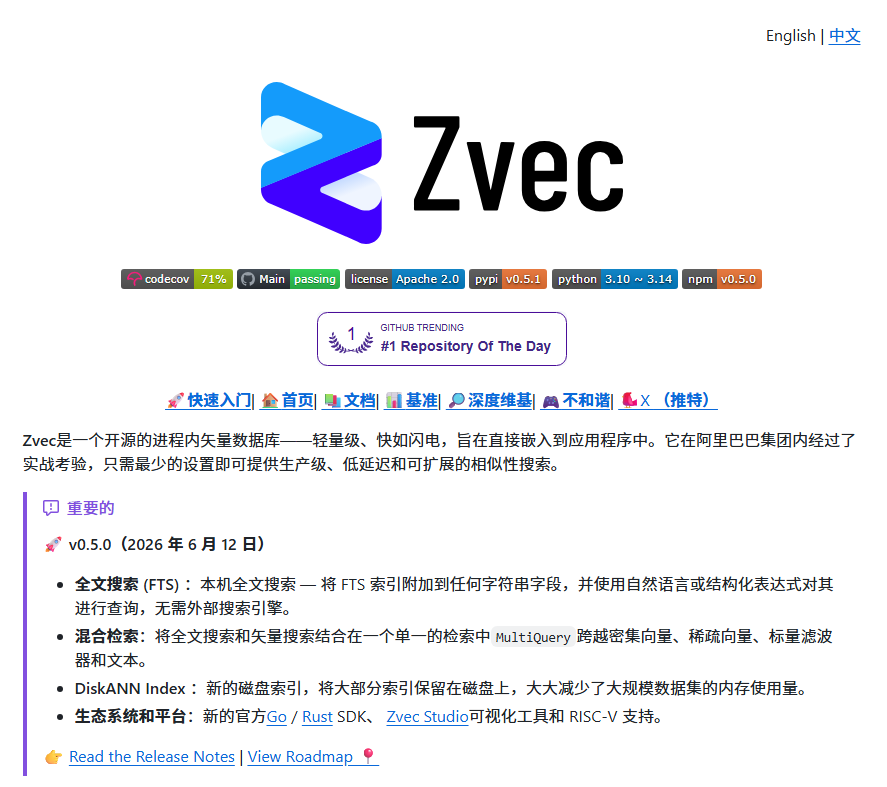
阿里开源了一款名为 Zvec 的向量数据库项目,主打“纯本地、内嵌式”极简体验,号称向量界的 SQLite。该项目基于 C++ 编写,支持零配置安装,性能强悍(毫秒级搜索数十亿向量),同时兼容稠密、稀疏向量及全文检索。它非常适合本地大模型、RAG 和个人知识库开发,彻底免去了部署繁琐的后端向量服务。
阿里开源了一款名为 Zvec 的向量数据库项目,主打“纯本地、内嵌式”极简体验,号称向量界的 SQLite。该项目基于 C++ 编写,支持零配置安装,性能强悍(毫秒级搜索数十亿向量),同时兼容稠密、稀疏向量及全文检索。它非常适合本地大模型、RAG 和个人知识库开发,彻底免去了部署繁琐的后端向量服务。
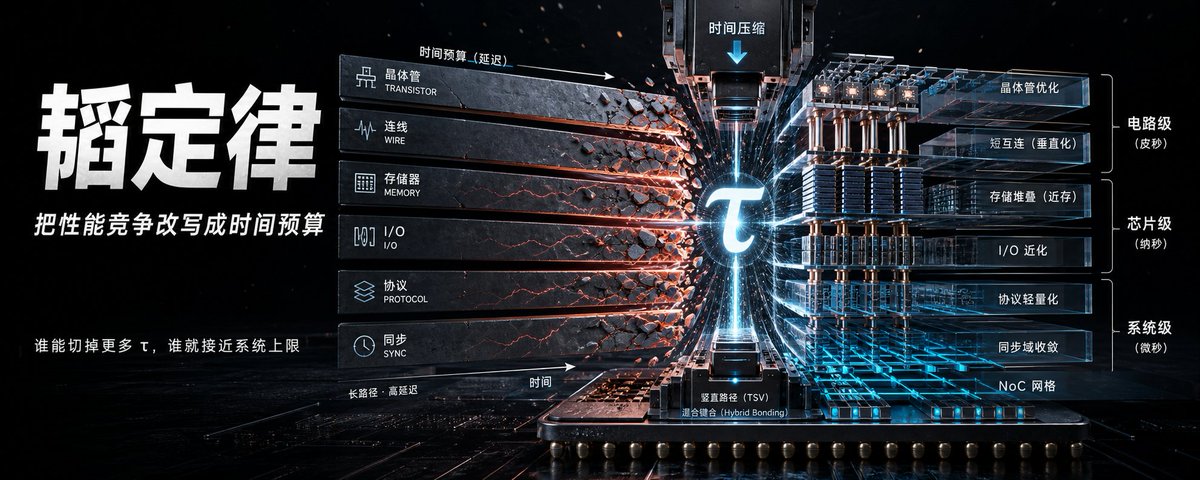
文章解析了关于华为“韬定律”的官方论文,指出其并非传统摩尔定律的延续,而是一种以后摩尔时代时间预算为中心的全新工程方法论。通过LogicFolding、3D堆叠和Unified Bus等技术,旨在优化从晶体管到系统的全链路延迟,将竞争焦点从单纯的晶体管尺寸转移到系统时间效率的优化。
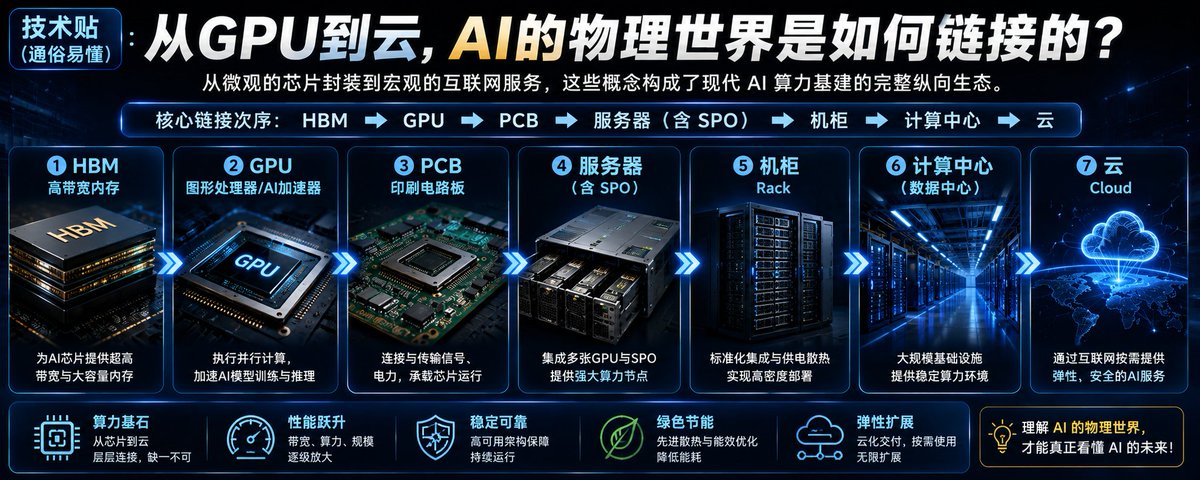
本文以通俗易懂的方式,从微观到宏观详细拆解了AI算力基础设施的物理构成。文章按照 HBM、GPU、PCB、服务器、机柜、计算中心到云的层级顺序,解析了各硬件的连接关系与核心作用,并补充了硅中介层、交换芯片、散热系统及数据中心与云的区别等关键知识点。
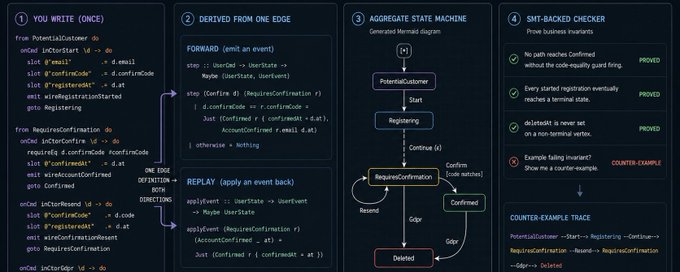
文章介绍了一种基于函数式事件溯源(Functional Event Sourcing)的库,旨在让业务逻辑 Bug 在结构上不可能发生。作者通过定义可组合的状态机,在类型层统一描述状态转换,自动生成决策逻辑和演化逻辑,从而避免两者不一致。此外,该库还能自动生成 Mermaid 流程图,并利用 SMT 求解器验证业务不变性,大幅提升代码的健壮性和可维护性。
Atlassian 首席工程师总结的后端面试与系统设计中的 20 个并发编程核心概念。文章涵盖了从基础的并发与并行、进程线程区别,到互斥锁、信号量、死锁、CAS、线程池及生产者-消费者模式等进阶主题。旨在帮助工程师掌握并发原语,理解性能权衡,从而构建可靠的生产级系统。
这是一份面向新手的网络建站与服务部署路线图。文章系统地梳理了从准备域名、配置 DNS 解析、购买 VPS、使用 SSH 连接服务器,到最终部署服务端和配置客户端的全过程。作者不仅推荐了 Cloudflare、NameSilo、DMIT 等具体的平台和工具,还详细解释了 NS 记录、A 记录等核心概念,旨在帮助初次接触者理清流程逻辑,少走弯路。
文章探讨了知识图谱性能优化的核心技术,指出海量数据下的查询瓶颈在于算法而非数据本身。文中深入讲解了三大索引策略(六重索引、位图索引、邻接表压缩)以及四种关键的图遍历算法(BFS、DFS、Dijkstra、A*),并分析了其适用场景与计算复杂度。
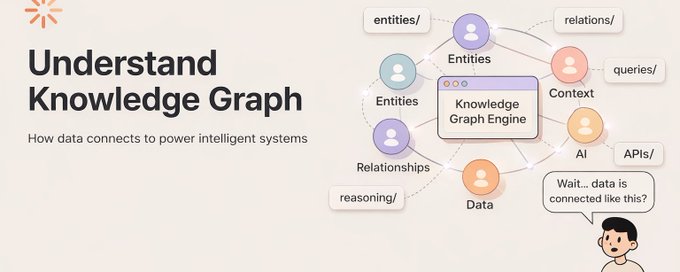
文章通过形象的人类联想记忆引入,阐述了知识图谱如何解决传统关系型数据库在处理复杂、多跳关系时的局限性。详细介绍了知识图谱的核心构成(节点、边、属性)及本体概念,展示了其在城市关系建模和推理中的强大能力。最后对比了不同数据模型,指出知识图谱在关系复杂度极高的场景下具有独特优势。
本文记录了作者将 Next.js 项目从 Vercel 迁移到 Cloudflare Workers 的完整过程,重点解决了 Supabase 数据库在 Worker 环境下的连接难题。文章详细介绍了环境变量获取方式的变化、Hyperdrive 的连接池原理以及“单次请求单次连接”的代码重构策略,提供了关于直连端口配置和 SSL 设置的关键避坑指南。
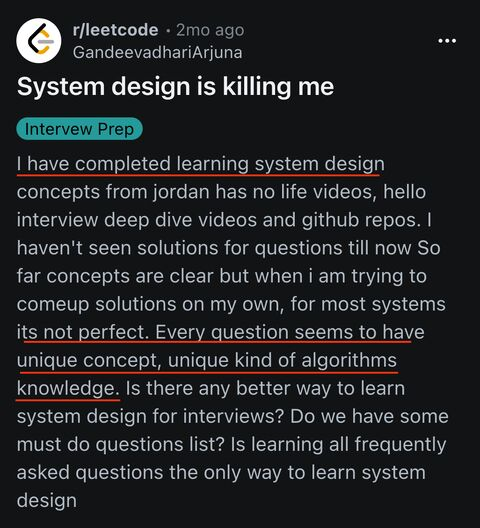
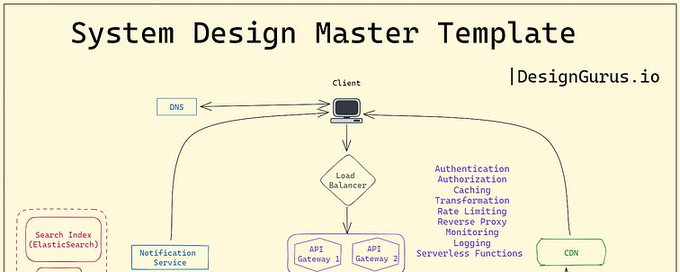
本文是作者基于对30多门课程的测试与评估,为2026年工程师精选出的5个最佳系统设计学习资源。文章涵盖了ByteByteGo、DesignGurus、Udemy及Exponent等平台,详细对比了它们在内容质量、实战案例、AI模拟面试等方面的优劣,旨在帮助开发者掌握可扩展性、微服务等核心架构技能,以应对FAANG级别的高难度面试。
文章讲述了 Stripe 创始人 Patrick 和 John Collison 如何从爱尔兰起步,通过解决开发者在线支付的痛点,打破 PayPal 垄断的故事。重点描述了他们如何通过一封给 Paul Graham 的冷邮件获得关键建议,并通过“Collison 安装法”实现早期增长。文章结尾强调了精准沟通(Cold Email/DM)在商业获客中的巨大威力,并作者推广了自己的 DM 销售服务。