Obsidian 小白完整入门教程(本地知识库)
本文是一篇面向新手的 Obsidian 完整入门教程,详细介绍了 Obsidian 作为本地知识库工具的核心概念、安装方法、界面操作、Markdown 语法、笔记组织方法论以及必备插件。文章强调在 AI 时代建立个人知识库的重要性,并提供了从基础到进阶的实操指南,帮助用户高效构建和管理自己的知识体系。
本文是一篇面向新手的 Obsidian 完整入门教程,详细介绍了 Obsidian 作为本地知识库工具的核心概念、安装方法、界面操作、Markdown 语法、笔记组织方法论以及必备插件。文章强调在 AI 时代建立个人知识库的重要性,并提供了从基础到进阶的实操指南,帮助用户高效构建和管理自己的知识体系。
作者为解决长文跨平台发布到小红书时排版繁琐的问题,开发了名为 Punk XHS Cards 的 Codex Skill。该 Skill 能根据用户上传的人物照片或 IP 形象,自动将 Markdown 长文转换为带有个人 IP 的竖版知识卡片,并生成小红书标题、正文和话题标签。文章详细介绍了该 Skill 的设计思路、工作流程、安装方法及当前局限性,强调了人物形象、主题色和教程截图的保留等关键特性。
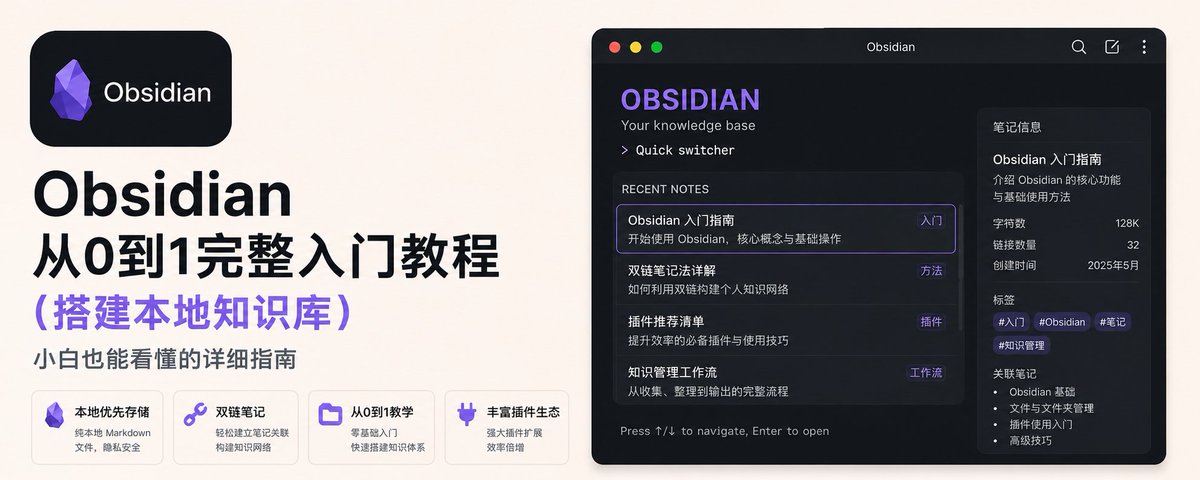
本文是一篇面向 Obsidian 新手的详细教程,旨在帮助用户从零开始搭建一个可用的本地知识库。文章从理解 Obsidian 的核心概念(仓库、Markdown、内部链接)入手,逐步讲解下载安装、创建仓库、建立目录结构、调整设置、创建 Home 首页、使用双向链接等关键步骤,并提供了具体的操作截图和验收方法。通过一个自媒体工作者的实例,展示了如何设计文件夹结构,最终形成一套完整的知识管理流程。
本文介绍了一个名为 Punk IP Illustrations 的开源 Agent Skill,旨在解决文章配图风格不统一、角色漂移的问题。用户只需上传一张照片,该工具即可生成可复用的固定个人IP角色。它能自动读取文章内容,根据信息密度智能选择配图位置,并运用“核心动作”或“流程拆解”模式生成插图,最后自动插入Markdown文件的正确位置。所有资产均在本地保存与调用。
文章详细介绍了如何将笔记软件 Obsidian 与 AI 工具结合,实现高效内容创作与变现。作者从为何选择 Obsidian、安装使用、基础 Markdown 语法、必备插件、接入 AI 的具体方法(如 Terminal 和 Claudian 插件)以及多端同步方案六个方面进行了全方位拆解,旨在帮助零基础用户掌握这一工作流。
作者开源了基于 Agent 的 Web Clipper,通过批量抓取 Dan Koe 2026 年文章进行压力测试。测试暴露了初版在质量验证上的不足,通过 Fallback 机制优化,最终成功抓取 17 篇公开文章,验证了健壮的 Skill 设计需要处理失败状态并验证产物。
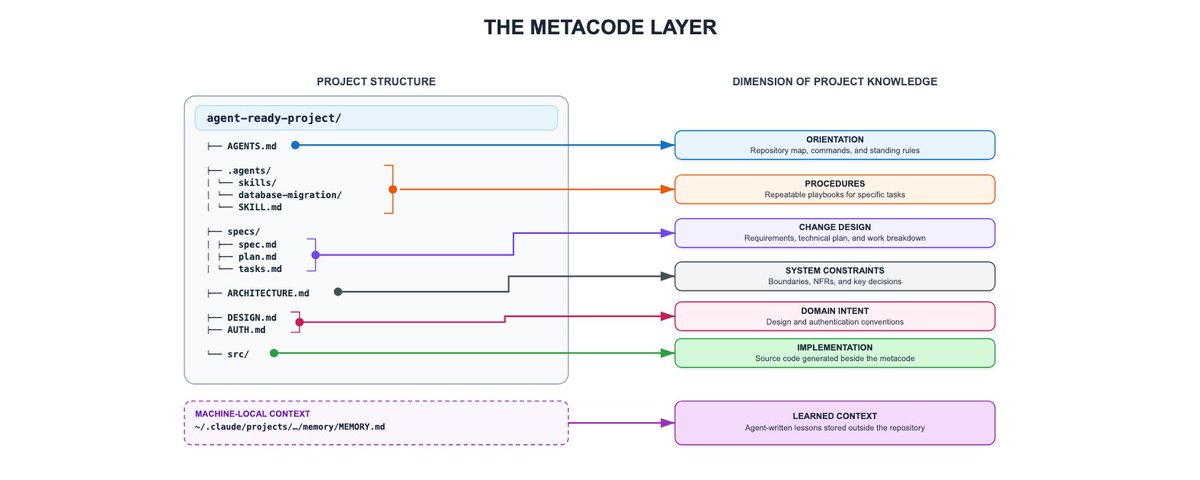
文章探讨了知识如何从分散的文档转移到代码库中,成为编码代理可发现的元代码层。介绍了AGENTS.md、SKILL.md等新兴Markdown格式,它们将人类意图和判断转化为代理可理解的形式,从而辅助代码生成。
本文介绍了如何从零开始搭建个人AI知识库。作者提出了一套包含文本文件、Agent工具、规则和真实任务的工作方式,并详细说明了准备四样要素(开放文件夹、真实任务、Agent工具、工作规则)和五个具体步骤的方法,帮助用户通过简单的流程实现知识的积累与迭代。
作者受够了每次与编码代理沟通时重复上下文,因此开发了AsterMem,一个本地运行的内存服务器。它将记忆存储为Markdown文件,支持离线运行,并自动提炼用户画像供代理读取。用户可完全控制和编辑记忆,避免黑盒问题。
文章介绍了一款开源的Obsidian公众号插件,能将排版时间从半小时缩短至1分钟。该插件支持实时预览、7套精美主题一键切换、封面同步、多账号配置及一键发布到草稿箱等功能。作者全程使用Vibecoding与AI对话开发,未手写一行代码,目前插件已开源。
这是一篇面向新手的 Obsidian 入门教程。文章介绍了 Obsidian 作为本地 Markdown 笔记软件的优势,包括易于搜索、双向链接、AI 友好及数据自主性。教程详细讲解了软件下载、库创建、界面布局(左中右三栏)、文件管理、工作区保存、文档属性(YAML)及基础 Markdown 写法,帮助用户快速搭建个人知识库。
文章介绍了如何使用简单的Markdown文件夹和CLAUDE.md索引文件构建AI原生的第二大脑。通过扁平文件结构、语义化文件夹和严格的主题命名规范,无需复杂应用即可实现高效的知识管理和AI检索。
本文介绍了一种结合 Claude 和 Obsidian 的知识管理方案,通过自动化提取、链接和归档,将死笔记转化为可交互的第二大脑,支持全文检索和引用,帮助知识复利增长。
年初制作了一套提示词,可自动生成文字海报。近期在 Claude Code 中开发了网页版编辑器,支持上传 Markdown 文本生成图文混排的悬浮框,并提供截图功能,灵活且节省 token,已开源。
本文作者 kaitox 介绍了一款名为 Kaitox 的开源工具,旨在解决本地 Markdown 文章发布到 X (Twitter) 时格式丢失、图片需手动上传的痛点。该方案由本地 Relay、Chrome 插件及 CLI/Skill/Obsidian 插件组成,支持原生排版保留、封面自动设置及一键生成草稿,且完全免费开源。
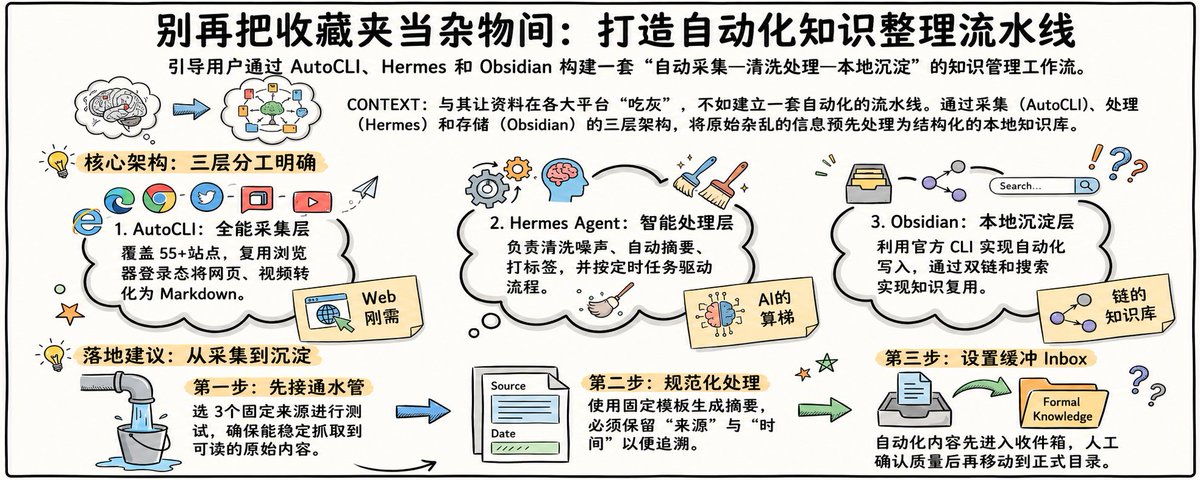
针对“收藏即遗忘”的痛点,文章提出了一套本地化知识管理方案。作者建议结合 AutoCLI(采集层)、Hermes Agent(处理层)和 Obsidian(存储层),构建一条自动化流水线。通过定时抓取网页、清洗摘要并生成 Markdown,将杂乱信息转化为可检索的本地知识库,从而提升资料利用率。
本文介绍了如何利用 Obsidian、Markdown、GitHub 和 AI(Codex)快速搭建一个同步的知识库。文章建议新手先不要追求复杂的 RAG 和向量数据库,而是使用 Obsidian 结合 Git 插件进行本地与云端(GitHub)的免费同步。文中还提供了小红书及网页内容剪藏插件的推荐,实现内容的快速收集与 AI 辅助整理。
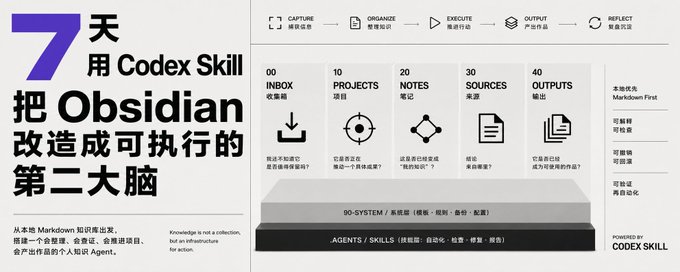
本文介绍如何将 Obsidian 本地 Markdown 知识库与 Codex 结合,通过编写可执行的 Skill,把第二大脑的方法论封装成系统。文章提出了五入口目录结构、Bootstrap Skill 的设计原则以及从捕获到产出的知识管理闭环,旨在让 AI 成为持续工作的知识操作员。
本文介绍了一种为编码 Agent 添加持久记忆的轻量级方案。针对 Agent 上下文窗口有限且容易遗忘历史信息的问题,作者选择了开源项目 EverOS。与传统的黑箱向量数据库不同,EverOS 将记忆存储为本地 Markdown 文件,透明且可编辑。文章详细讲解了从环境准备、安装初始化到验证记忆写入与检索的全过程,帮助开发者在半小时内赋予 Agent 跨会话的长期记忆能力。
本文介绍了一套结合 Obsidian 与 Claude Code 搭建本地 AI 知识库的完整方案。文章详细讲解了如何建立文件夹体系(Inbox、Raw、Wiki 等)、编写 CLAUDE.md 规则文件,以及利用 AI 自动整理资料、生成 Wiki 页面和索引的方法。该方案旨在解决资料分散混乱的问题,实现知识的结构化沉淀与高效复用。
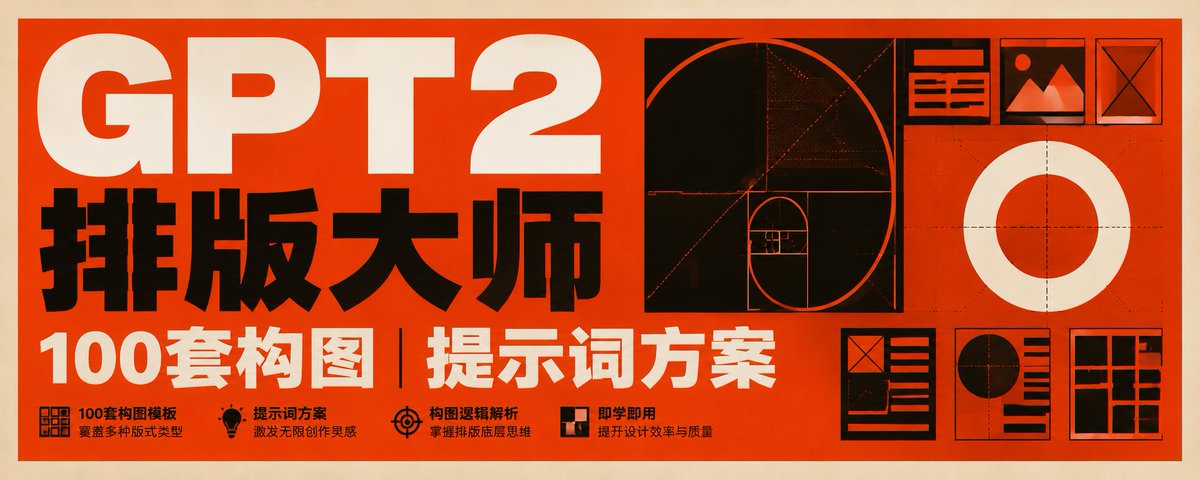
本文作者利用GPT2生成了100套用于设计和海报制作的构图方案,旨在提高Prompt编写效率。文章同时介绍了作者开源的Chrome插件xPoster,该插件支持Markdown导入X平台文章及批量上传图片,解决了单次发布图片数量的限制问题。
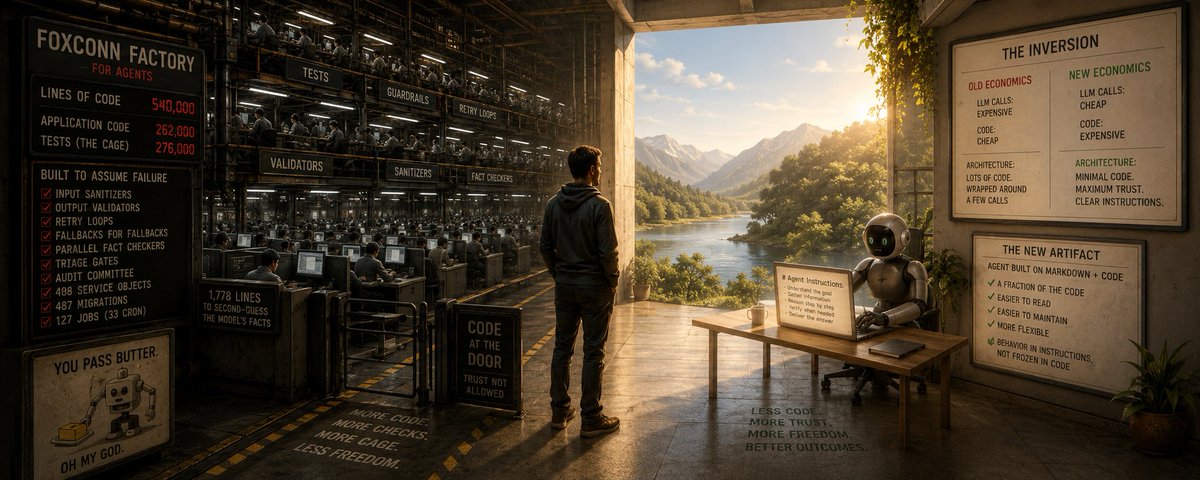
作者通过自己编写 54 万行代码的亲身经历,反思了在 LLM 时代的开发范式。他指出,当前大多数开发者仍在沿用旧思维,编写大量代码来限制和监控智能模型,这就像是在为不需要严格监管的超智力工人建造富士康工厂。随着模型成本降低和能力提升,开发者应摒弃“保姆式代码”,转向以 Markdown 为核心的“即时软件”架构,将指令与逻辑解耦,释放 AI 的真正潜力。
作者通过对比传统设计书籍与 GPT2 的教学效率,整理了 100 套关于构图与布局的视觉方案。文章重点介绍了如何利用这些方案优化 AI 绘画提示词,以提升海报设计和排版的实战效果。同时,作者开源了相关的 Chrome 插件 xPoster,支持批量上传 Markdown 到 X 平台,并分享了包含 100 种布局示例的 GitHub 项目下载链接。
GBrain 是 Y Combinator CEO Garry Tan 开源的个人知识管理系统。它突破了传统笔记工具的存取模式,通过集成知识图谱、混合搜索与 LLM 合成能力,实现跨文档的关联理解与自动回答。系统采用 Markdown+Git 存储数据,支持 MCP 集成及 43 种预置技能,目前已在 14 万页规模的生产环境中得到验证。
本文是一篇面向零基础用户的 Obsidian 新手教程。作者指出 Obsidian 本质上是一款本地优先、基于 Markdown 的双向链接笔记软件,能有效构建知识网络。文章通过创建库、掌握基础语法、理解双向链接、建立文件夹结构、使用每日笔记和模板等步骤,引导新手从“先写再整理”开始,避免沉迷插件和过度装修,最终搭建出属于自己的个人知识库。
作者分享了将 Agent 输出格式从纯 Markdown 调整为“Markdown 源文件 + HTML 报告”组合的实践经验。通过在 X Manager 项目中测试,发现 HTML 渲染仅增加 51ms 延迟,却显著降低了阅读长文本的认知负担。文章提出了一套清晰的交付契约:Markdown 作为机器处理的数据源,HTML 作为人类阅读的审查界面,聊天工具仅保留极简摘要。
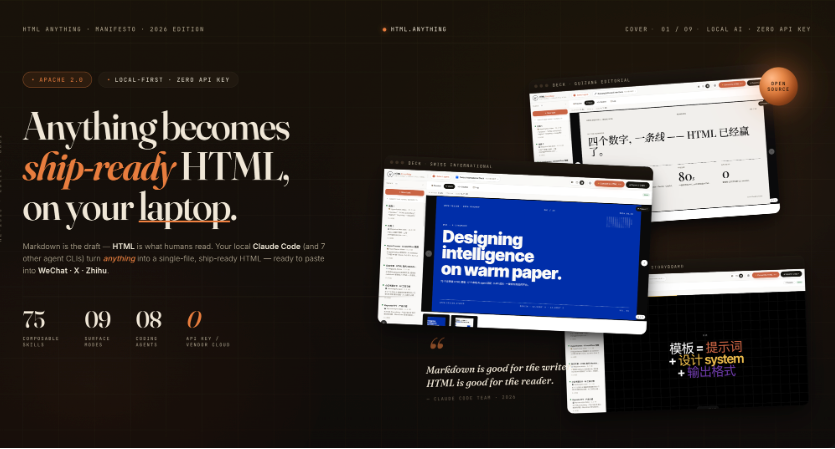
文章宣布正式开源 AI 工具 html-anything。该工具历时 3 天开发,包含 1.5 万行代码,旨在解决 AI Agent 输出 HTML 设计差的问题。它内置 75 套技能模板,支持 18 种主流代码 Agent CLI(如 Claude Code、Cursor 等)的自动探测与会话复用,实现零 API Key 成本。同时支持 Markdown、数据及图像等 11 种文件格式转换,并可一键发布至社交媒体或导出高 DPI 图片。
本文分析了 Andrej Karpathy 关于 LLM 输出 HTML 格式的观点。Karpathy 从神经科学角度指出,视觉是 AI 偏好的输出,HTML 是通往未来“神经模拟”的必经之路。作者结合自己的观察,对比了用户行为与科学原理的异同,并提出了 Karpathy 未尽的两个观点:一是输入端(人机交互)的滞后,二是 HTML 可能因工程上的局部最优而长期存在,不仅是过渡方案。
本文介绍了一套在 macOS 上将推特(X)长文批量保存为本地 Markdown 文件的完整方案。通过结合 gallery-dl 抓取工具、Python 脚本及 Cloudflare R2 图床,用户可以自动下载文章内容,并将图片上传至图床,最终生成排版整洁的 MD 文件存档于 Obsidian 中。文中提供了从安装依赖、导出 Cookies 到编写转换脚本的详细步骤。
文章探讨了 AI Agent 的记忆机制,解释了为何不同 Agent(如 Claude Code 和 Codex)之间无法直接通过复制文件来迁移记忆。作者指出,这是因为模型在后期训练时与特定的记忆层“融合”了。文章对比了 Hermes、Codex CLI 和 Claude Code 三种实现,并得出结论:最聪明的架构(如向量数据库、知识图谱)输给了最简单的方案(LLM + Markdown + Bash 工具)。核心在于 Agent 遵循的读写规范,而非数据结构本身。