Wiki 知识库

全部文档 / 标签: 重排序

3 篇
清除

Is Jev overhyped? We tested it on 4 real enterprise tasks.

作者基于 Glean 的四个真实企业场景测试了 Jev——一个输出类型化决策(选项、分数、概率)而非生成文本的'System One'模型。文章梳理了通用 LLM、零样本分类器、微调分类器与 Jev 的替代方案权衡,并对比了 Qwen/SGLang、Kev 等开源复现。实验显示:查询分类上 Jev 零样本明显优于 Laya 但微调后反超;模型路由(专家转移)是最强结果,准确率更高且中位加速 8.1 倍;重排序中 Jev 的 Choice 表述最强,但平均 41 个候选中约 37 个分数相同需靠生产排序打破平局。结论是 Jev 在新任务或标签频繁变化时最具吸引力,是否被高估取决于具体场景。

技术 › LLM Tony Gentilcore 2026-09-2913.0 KB 196.4K 379 83

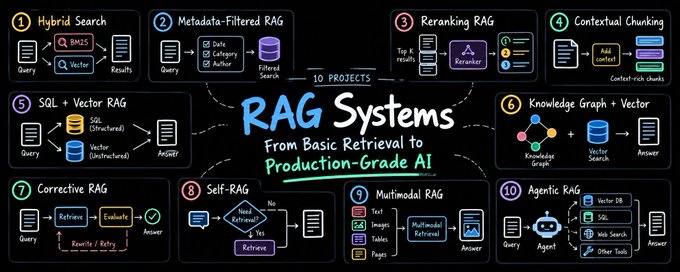
10 个带你从基础检索到生产级 AI 系统的 RAG 项目

文章指出仅掌握基础的'chat with PDF'式 RAG 流水线(分块、嵌入、向量检索、LLM)不足以构建真实生产系统,并推荐 10 个进阶项目:混合检索(BM25+向量)、元数据过滤、重排序、上下文分块、SQL+向量混合、知识图谱+向量、纠错式 RAG、自感知 RAG、多模态等。每个项目均说明要解决的问题、系统架构、技术栈(Python、pgvector、LangGraph、Neo4j 等)及学习要点,帮助开发者从语义相似度走向关键词匹配、结构化过滤、关系推理与检索质量反馈等生产级能力。

技术 › LLM Jaydeep 2026-09-2912.2 KB 22.5K 314 78

How I Built pragatiLM?

作者详细介绍了 pragatiLM 的构建过程——一个只基于用户提供的源(PDF、网页、YouTube 视频、字幕文件或粘贴文本)作答并附带可点击引用的 AI 笔记本。文章系统讲解了基础 RAG 的原理及其三大失效点:问题作为搜索键不佳、存储只单向单次搜索、输出缺乏自检。pragatiLM 采用九阶段检索管线:将问题转化为五个搜索变体、并行多通道检索、基于排名一致性融合、重排序、答案 grading,低分时基于缺失诊断再次检索,极低分时拒答。文章还涵盖基础设施、消融实验测试等内容。

技术 › LLM Saurav Jha 2026-09-1340.3 KB 3.7K 34 85