Wiki 知识库

全部文档 / 标签: Apple Silicon

9 篇
清除

Karpathy的本地LLM加速技巧终于有了完整解决方案:Uzu推理引擎

文章回顾了Karpathy在2023年指出的本地LLM推理瓶颈:解码阶段受限于内存带宽,每次前向传播只生成一个token,使得推理速度存在硬上限。以M5芯片和4-bit Qwen3.5 9B为例,理论极限约29 token/s,llama.cpp和MLX接近该上限。开源推理引擎Uzu通过组合优化突破瓶颈:采用4-bit/8-bit整数量化降低内存流量,利用M5的int8硬件加速路径,在量化前应用块对角随机Hadamard变换抑制离群值误差,并通过推测解码一次性验证多达16个草稿token。实测Uzu在M5上达到92-117 token/s,显著超越llama.cpp和MLX。

技术 › LLM Akshay 2026-10-0928.4 KB 115.2K 257 78

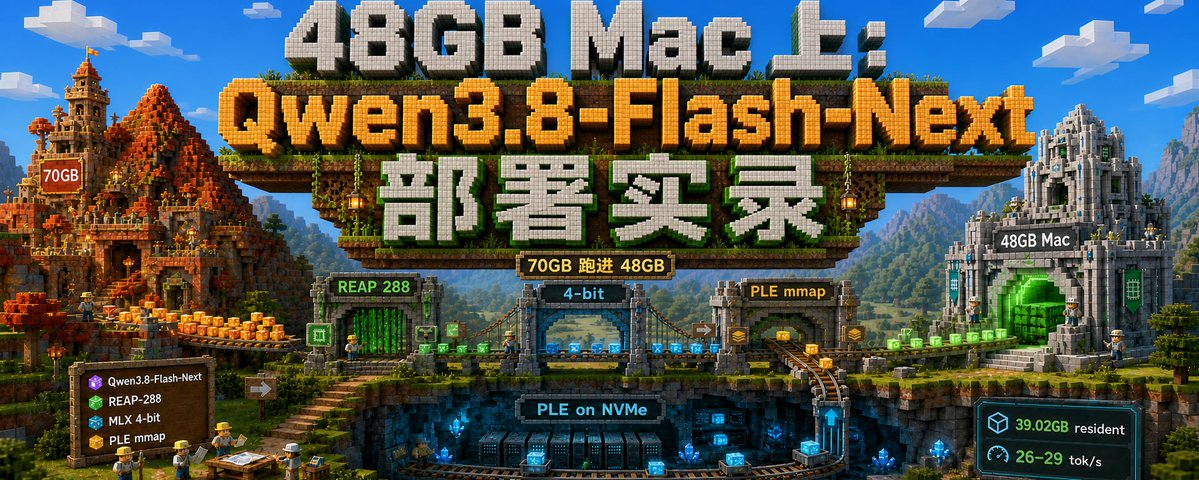
70GB 模型跑在 48GB Mac 上:Qwen3.8-Flash-Next 部署实录

作者在 48GB 内存 MacBook Pro(M4 Pro)上成功部署了磁盘体积约 70GB 的 Qwen3.8-Flash-Next REAP-288 MLX 4-bit 模型。文章解析了能跑起来的三重原因:REAP 将每层 512 个专家裁剪至 288 个、主模型与 PLE n-gram 表均做 4-bit 量化、以及 51B 参数的 PLE 表通过 mmap 留在 NVMe 按需流式读取。实际驻留约 39GB,首次加载约 10.14 秒,decode 稳定在 26~29 token/s,prefill 峰值约 149 token/s。实测最大上下文仅 8,217 tokens(配置声明 262K),建议日常使用 7,680 tokens。文章还记录了 Metal 内存上限调整、oMLX 服务启动及完整基准测试过程。

技术 › LLM 雪瑜 2026-09-0110.7 KB 55.5K 175 90

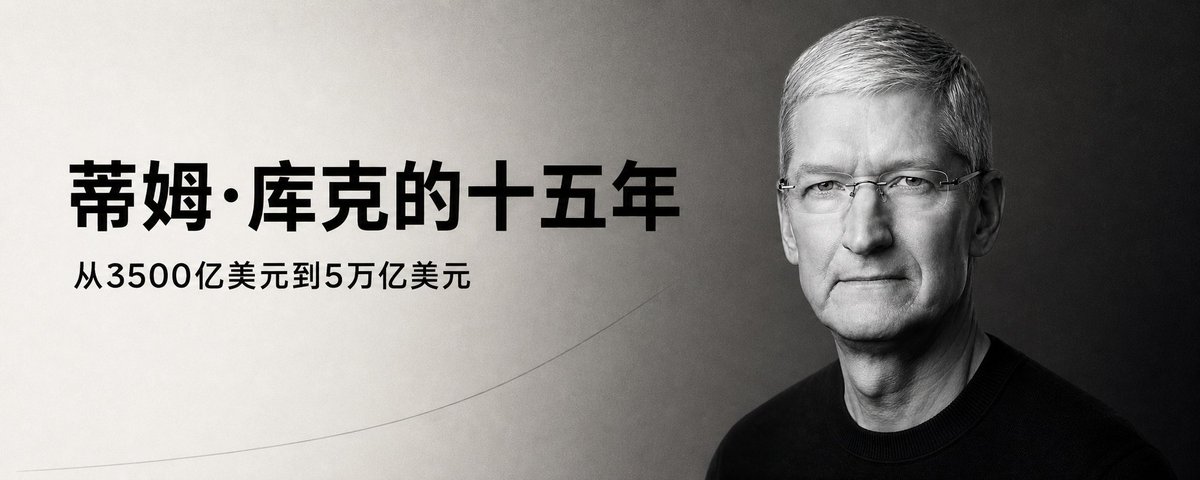
蒂姆·库克的十五年,从3500亿美元到5万亿美元

2026年9月1日,蒂姆·库克卸任苹果CEO,约翰·特努斯接班。文章回顾库克从阿拉巴马小镇工业工程师到IBM、康柏,再到1998年加入苹果的职业生涯,系统评价其十五年CEO任期:市值从3500亿美元增长至突破5万亿美元,收入翻近四倍,服务业务年收入超千亿美元,活跃设备超25亿部。文章分析了库克在组织管理、iPhone生态、Apple Watch与AirPods、Apple Silicon芯片迁移、隐私立场和供应链建设上的成就,也指出造车项目取消、AI落后、Vision Pro小众等遗憾,并展望特努斯面临的产品创新与监管挑战。

投资 › 宏观经济 詹姆斯叉 | JamesX 2026-09-0121.8 KB 80

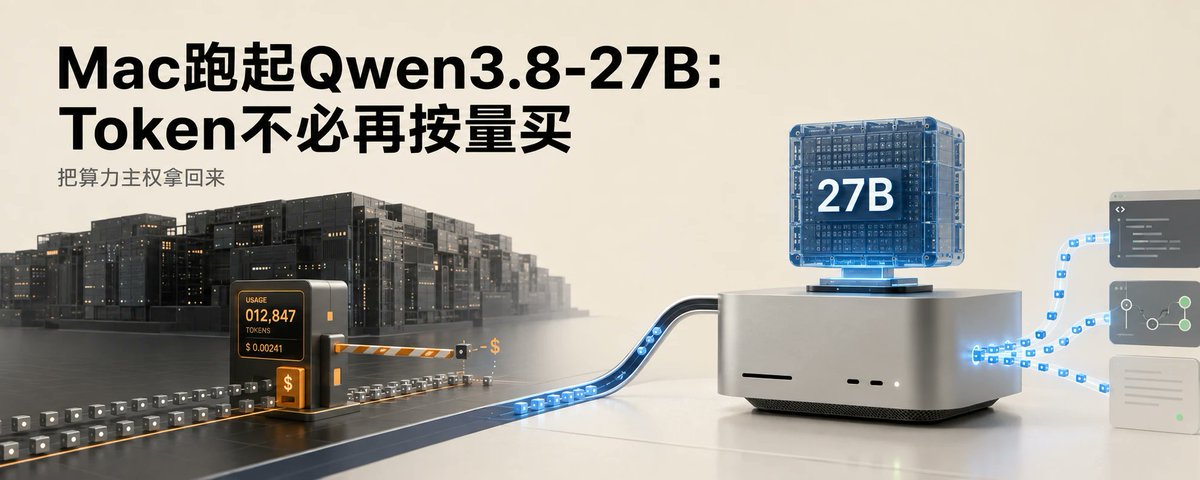
从零安装Qwen3.8-27B:Mac本地部署与性能调优指南

本文详细介绍了如何在 Apple Silicon Mac 上从零部署 Qwen3.8-27B 模型。作者苏乐指出,普通 Mac 无需升级到最新 Mac Studio 即可运行该模型,关键在于算清内存账:模型权重、上下文缓存、运行缓冲、草稿模型和系统开销共享统一内存。文章对比了 4-bit、8-bit 和 BF16 量化版本的选择建议(24GB/32GB 选 4-bit,48GB/64GB 可选 8-bit),并提供了完整的部署流程:使用 uv 管理环境、通过 hf 命令下载模型、先测 baseline 速度再逐步开启优化。文章还解释了 DFlash 2 投机解码加速原理——通过轻量草稿模型并行提出候选 token,再由主模型验证,从而显著提升生成速度。

技术 › LLM 苏乐 2026-09-0137.3 KB 435.7K 623 85

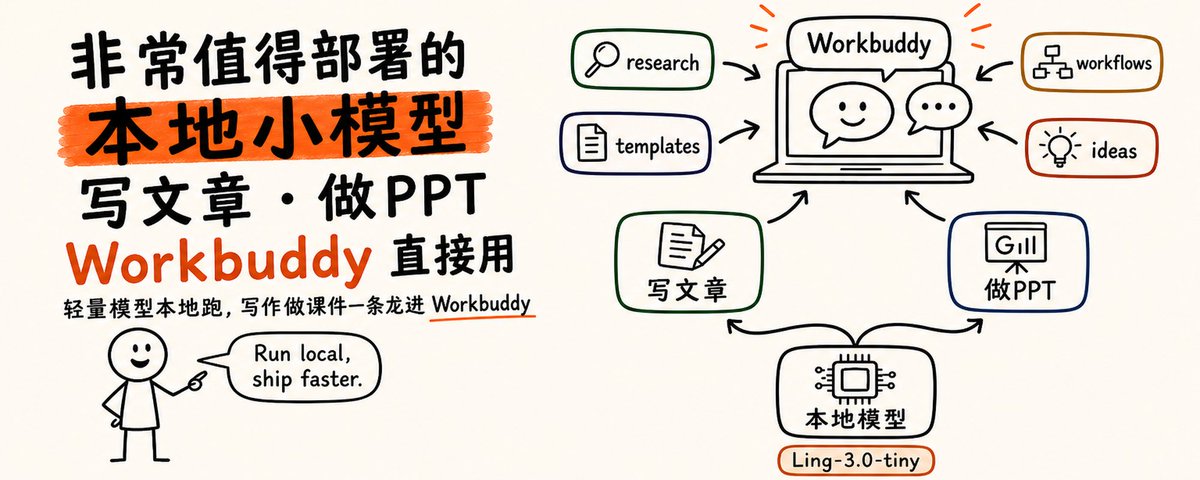
非常值得部署的本地小模型:写文章,做PPT,直接workbuddy里使用

文章介绍了蚂蚁刚开源的本地小模型 Ling-3.0-tiny(7.9B 总参数,每 token 激活 1.3B),在 Apple Silicon Mac 上的部署与实测表现。作者通过让 Cursor/Codex 自动部署 Rapid-MLX 的 4bit 版本,实测 M3 Max 上首字延迟约 55 毫秒,稳态解码约 110-125 tok/s,4bit 权重仅 4.2GB。该模型适合本机快速开发、大纲草稿、纪要压缩、做课件等短任务,也可接入 workbuddy 作为日常模型,但不适合复杂推理和长知识问答。文中给出了完整部署提示词、速度测试和文案处理实测案例。

技术 › LLM 产品经理老王霸 2026-08-307.4 KB 23.3K 74 77

同一台 M4 Pro 实测四组 Qwen3.8-27B:DFlash2、MTP 到底怎么选

作者在 48GB M4 Pro MacBook 上对比了 Qwen3.8-27B 的四组运行配置:官方 4-bit、Uncensored 版、官方 4-bit + DFlash2 草稿模型,以及 oQ4e + MTP。结果显示 DFlash2 平均提速 75%(约 26.96 token/s),数学与 GSM8K 场景超过两倍;oQ4e + MTP 在长文与代码负载下分别达 24.9 和 34.1 token/s,代码吞吐最高但部署复杂、首 token 延迟明显。结论是日常优先官方 4-bit + DFlash2,代码和长输出用 MTP,Uncensored 仅限隔离环境研究使用。

技术 › LLM 雪瑜 2026-08-248.2 KB 9.1K 57 82

Hugging Face 百大热门 AI 硬件配置分析

文章基于 Hugging Face 上近 30 万用户的硬件数据,分析了 AI 开发者的主流设备选择。关键发现包括:VRAM 容量比算力更重要(RTX 3060 12GB 最受欢迎);Apple 在 SoC 领域占主导,NVIDIA 统治独立显卡;AMD Ryzen 在 DIY 组装市场(尤其是 CPU+GPU 组合)超越 Intel;M4 芯片普及速度极快。数据揭示了本地 AI 硬件的高度碎片化特征。

技术 › 硬件 clem 2026-05-065.9 KB 115.6K 340 77

郭明錤:关于 John Ternus 成为苹果新CEO的深度思考

知名分析师郭明錤发文分析 John Ternus 出任苹果新CEO的背后逻辑。Ternus 因成功领导 Mac 从 x86 向 Apple Silicon 的全栈转型而获董事会青睐,这展示了其在系统级迁移上的卓越执行力,正是苹果迈向端侧 AI 时代所需的关键能力。文章指出,Ternus 的晋升打破了“iPhone 业务负责人继任”的传统预期,暗示库克建立的供应链运营模式将保持稳定,但在新阶段将更注重与供应商的深度技术整合。

投资 › 股票 郭明錤|Ming-Chi Kuo 2026-04-215.7 KB 712.3K 1.4K 78

无头 Mac mini 运行 AI Agent 指南

本文是一份关于利用 Mac mini 搭建无头服务器的终极指南,特别针对运行 AI Agent(如 OpenClaw、Hermes、Perplexity)进行了优化。文章详细介绍了 Mac mini 在尺寸、功耗(特别是 M4 芯片)及 macOS 深度集成方面的优势。内容涵盖了初始设置中的 FileVault 与自动登录处理、防睡眠配置、是否需要虚拟显示器的解答,以及如何通过 Astropad Workbench 等工具实现高质量、低延迟的远程访问,旨在打造一个稳定、静音的 7x24 小时 AI 工作站。

技术 › Agent Matt Ronge 2026-04-1828.1 KB 1.2M 1.2K 82