Wiki 知识库

全部文档 / 标签: OpenContext

6 篇
清除

让AI从新人变成长期的同事——硬核拆解Alloomi的三层技术路线

作者通过分析Alloomi的两篇技术报告,拆解了让AI具备长期工作能力的三层技术路线:记得住、学得会、做得成。第一层通过给信息打标签、时间有效期管理和连接强化构建持久化上下文记忆(OpenContext已开源);第二层通过经验池筛选、微调飞轮和Engram X设计将经验写入模型权重实现自我进化,并配有三裁判安全阀机制;第三层在SWE-Bench-CL、JobBench、GDPval等基准上验证端到端交付能力。三层构成可回滚的闭环,让AI每完成一次交付就变强一点。

技术 › Agent AI少年 2026-08-1815.9 KB 19K 73 74

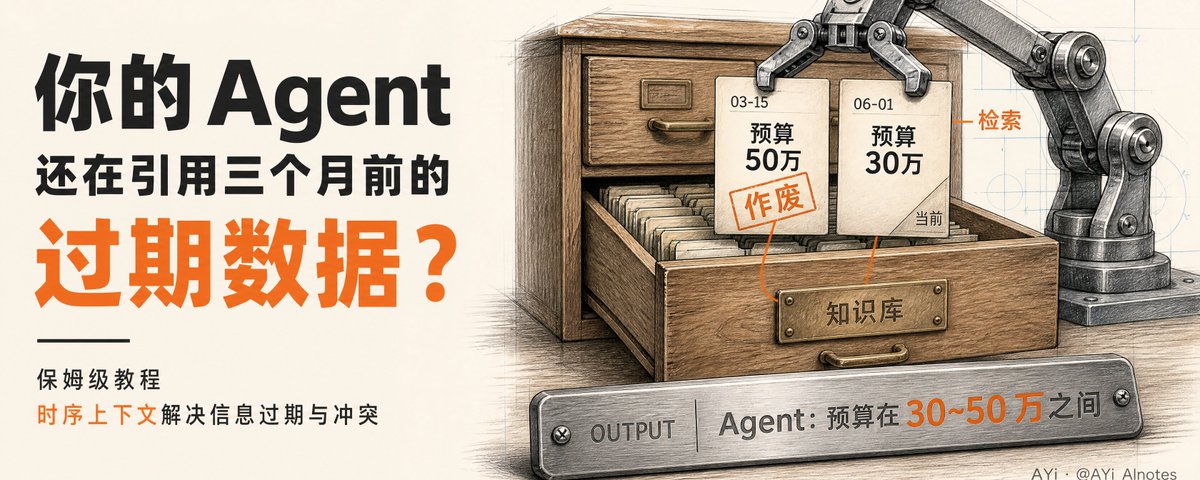
RAG 治不了 Agent 记忆过期:时序上下文的四个机制与开源路线实操

文章剖析了标准 RAG 在处理新旧事实冲突上的结构性缺陷:向量检索没有时间轴、不理解'取代'关系,只能把矛盾甩给模型猜测。作者提出时序上下文的四个核心机制——有效期标记、取代关系、软删除与遗忘、审计日志与证据链,并以 Graphiti 和 OpenContext 两条开源路线为参照讲解落地方式。OpenContext 提供基于时序上下文图的 remember/recall/improve/forget 四动词 API,在数据层解决事实过期问题;Graphiti 则专注作为可插拔的时序知识图谱记忆引擎。文末用律所预算变更案例演示了完整代码流程。

技术 › Agent AYi 2026-08-1822.8 KB 63.8K 159 86

AI 记得越多越好吗?我用 21 版旧稿做了次测试

作者用一篇修改过21次的旧稿测试了开源组件OpenContext,探讨AI长期记忆的核心问题:记住多少才算够?文章将AI长期记忆拆解为三层:记得住(Holistic Context)、学得会(Self-Evolving Agent)、做得成(真实交付),并分别对应OpenContext、后训练循环和benchmark评测。作者通过本地测试验证了消息写入、读取和版本标记功能,但语义搜索未配置。文章强调,AI记忆的关键不在于存储量,而在于理解信息的时效性、冲突和取代关系,并最终将经验转化为下一次交付的提升。

技术 › LLM 小墨同学 2026-08-1419.4 KB 75

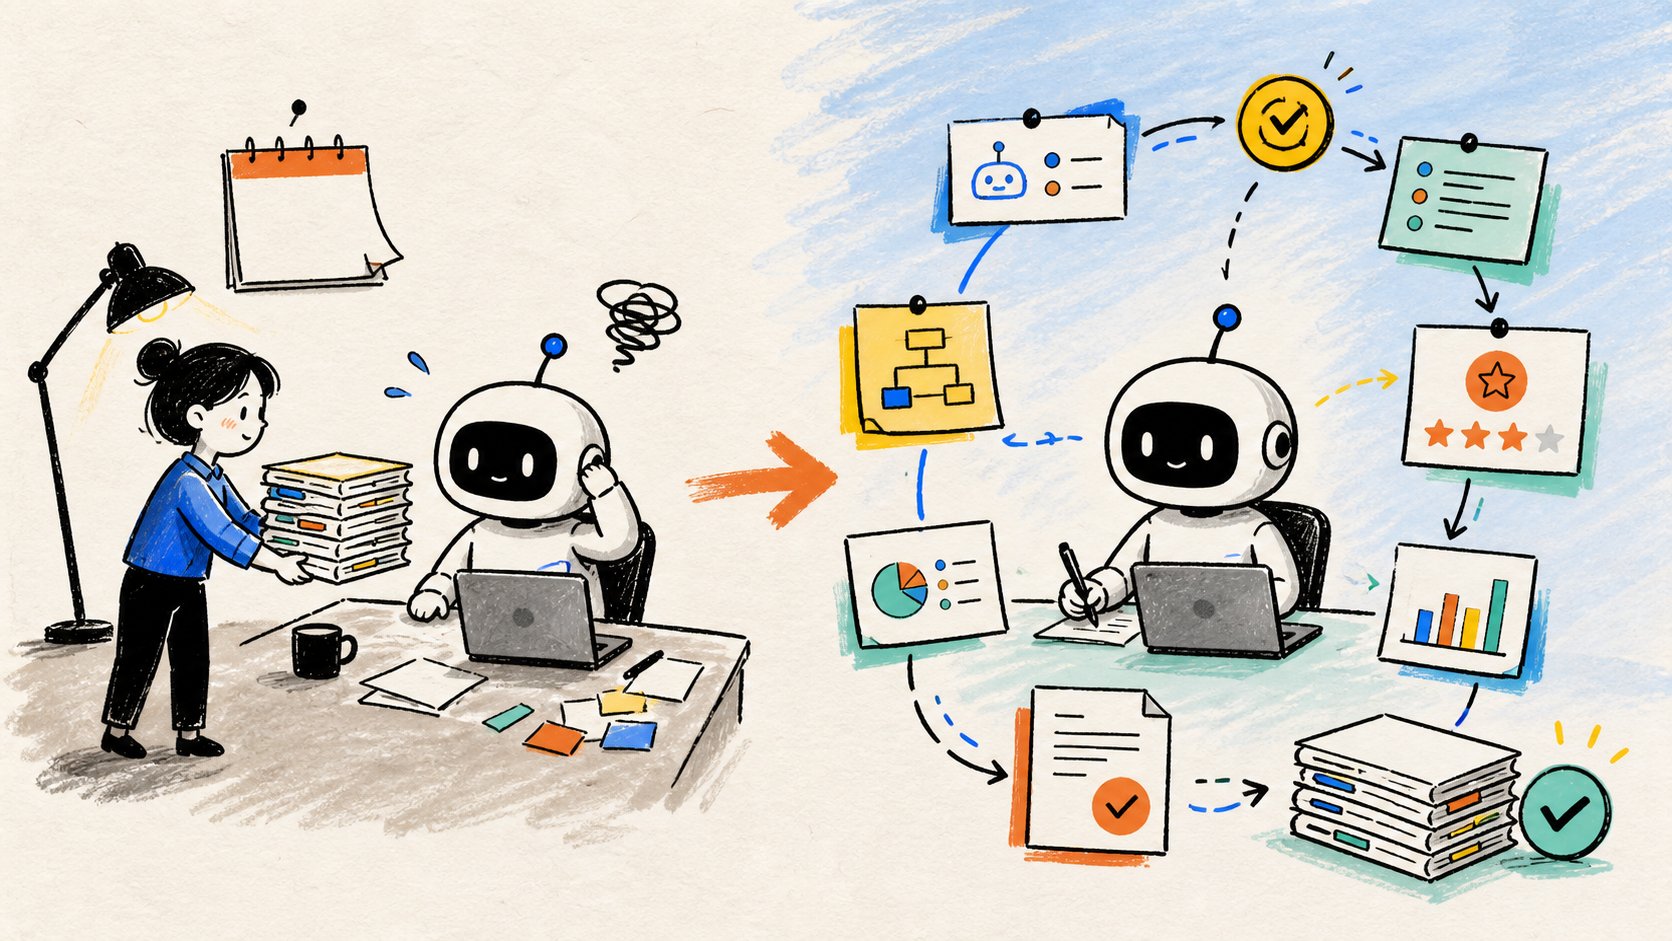
AI Agent 的自进化:从第二次交付看真实能力

本文探讨了AI Agent 的自进化能力,提出判断其是否真正变强的关键在于第二次交付的表现。作者认为,如果Agent每次任务都从零开始,无法记住上次的修改和专家的纠正,那么系统只是在重复劳动。文章介绍了Alloomi 的路线,即通过沉淀真实工作中的判断、修改和结果,让经验成为下一次交付的输入,形成复利闭环。文中还展示了Alloomi 在长期记忆、持续学习和专业交付方面的benchmark数据,并讨论了其技术架构,包括Holistic Context 和Self-Evolving Agent,以及开源项目OpenContext。最后,作者强调下一代AI公司的护城河在于用户第二次任务是否优于第一次,以及模型能否从经验中学习并回滚错误。

技术 › Agent bbshare (@shadouyoua) 2026-08-148.2 KB 64

与其由我自己来维护记忆,不如让Agent记住更多

作者分享了为Agent做知识管理的痛点:Skill无法跨项目迁移,知识库虽大但Agent无法自主利用,导致作者需要人工替Agent维护记忆。作者介绍了Alloomi产品,其通过三层架构(记得住、学得会、实践)实现Agent的自进化,并开源了OpenContext工具。作者希望未来的Agent产品能具备自进化能力,帮助用户组织底层记忆。

技术 › Agent 冷酷小猫 IcyCat 2026-08-137.5 KB 13.2K 51 62

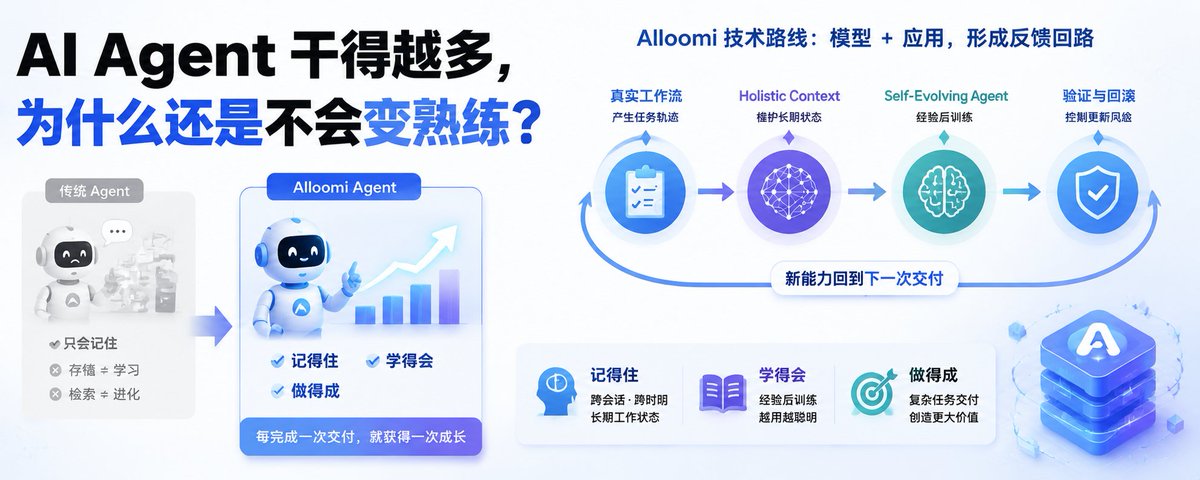
AI Agent 干得越多,为什么还是不会变熟练?

本文探讨了AI Agent在长期部署中面临的核心问题:完成多次任务后,其能力并未随之提升。作者介绍了Alloomi公司的技术路线,通过Holistic Context维护长期工作状态,以及Self-Evolving Agent将任务经验后训练进模型,形成“模型+应用”的反馈回路。文章详细解析了两份技术报告,包括上下文管理机制、后训练流程、基准测试结果及开源项目OpenContext的验证,指出当前证据仍属早期阶段,但为长期运行的Agent提供了可检查的工程入口。

技术 › Agent AI搞钱Hacker 2026-08-1315.0 KB 17.8K 46 82