Wiki 知识库

全部文档 / 标签: AI记忆

11 篇
清除

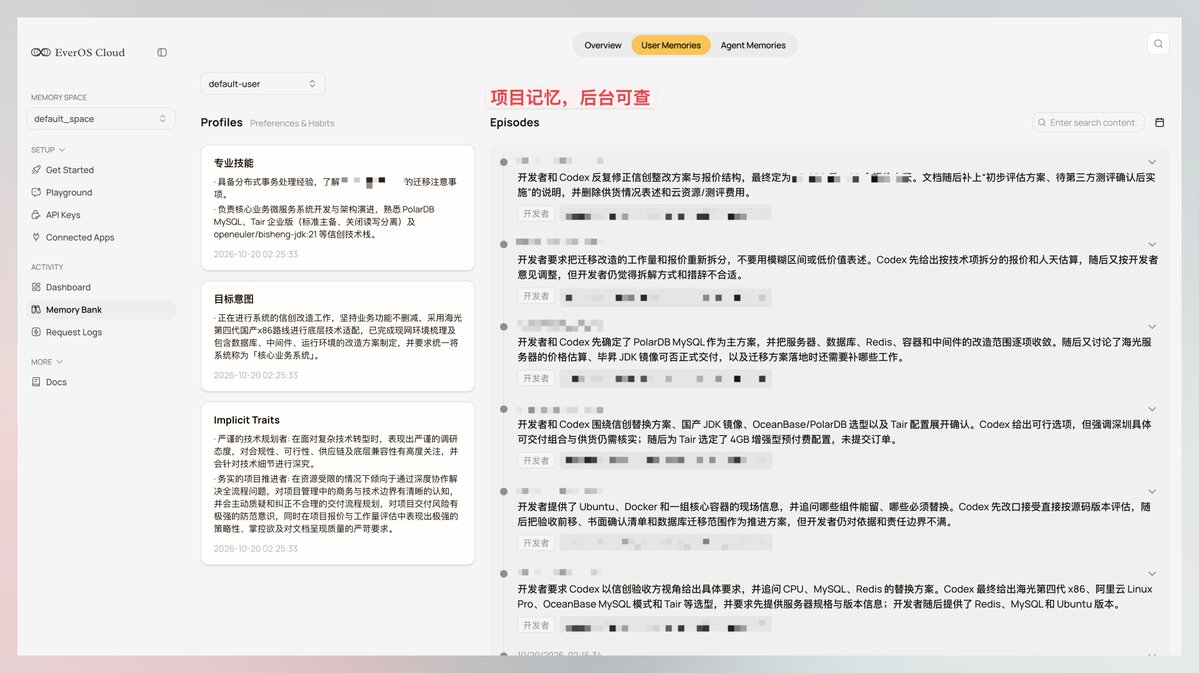
用 EverOS Cloud 解决 AI 项目方案跨电脑跨窗口无缝续接的问题

作者分享了一个长期痛点:与 AI 多轮讨论敲定的项目方案往往锁在某台电脑的聊天窗口里,换设备或同事接手时需重新投喂上下文。作者接入 EverOS Cloud(GitHub 1.3w 星开源 Agent 记忆系统 EverOS 的云端托管版),将公司电脑和家里电脑的 Codex 挂到同一云端记忆空间。AI 讨论过程中的方案与约束自动沉淀为云端记忆,跨设备、跨团队无缝续接工作,无需手动整理 Markdown。网页端 Memory Bank 可查看阶段摘要和事实卡片,支持记忆的增删改。该方案也适合团队协作,共享记忆成为项目知识资产,降低人员交接风险。
技术 › Agent 冰零 (@cryozerolabs) 2026-10-2011.5 KB 65

Build a second brain your AI can read

文章介绍了一种将 AI 记忆自主可控的方法:把 ChatGPT 等应用中关于你的记忆导出为五个 Markdown 文本文件(ABOUT、how-i-work、projects、voice、decisions),存放在一个可随身携带的文件夹中,供 Claude、Gemini、Grok 等任意 AI 在每次对话时读取。文章提供了导出记忆的提示词、生成五文件的模板、如何区分用户真实 stated 和 AI 推断 inferred 的信息,以及如何在各 AI 平台(Projects、Gem、Grok Bot)中配置读取,还有持续维护和五个常见错误(如泄露隐私)的规避方法,全程无需编程。

技术 › LLM AI Guides 2026-10-1511.5 KB 8K 63 84

Claude 封号,记忆归零?我的本地架构:换号也不用重训

作者分享了一套不依赖云端账号的本地 AI 工作流架构,核心思路是把规则、技能、日记等真正有价值的资产沉淀在本地硬盘,而非网页端/App 的记忆功能中。整套体系分为四层:工具层(Claude Code、Codex、Cursor 作为入口)、模型层(可随时更换)、架构层(本地文件结构)、处理层(按本地规则和技能处理任务)。作者通过全局规则文件(CLAUDE.md)、本地 skills 目录、按日短记忆 + 长期偏好文件、AI 日记四层文件体系,实现了账号封禁后快速恢复工作的能力,并提出新人可先从三步最小方案入手搭建。

技术 › Claude Code 杰哥的AI踩坑日记 2026-10-088.9 KB 10.8K 22 84

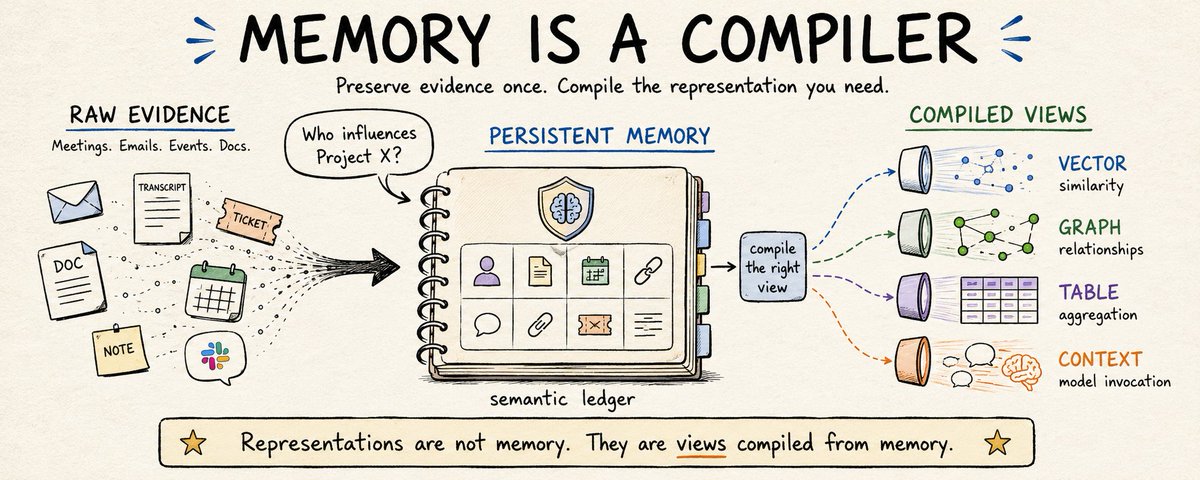
Memory Is a Compiler:记忆是一个编译器

作者通过一次融资会议记忆被重新解读的经历,指出记忆的本质不是固定表示,而是一个持久系统:保留过去的证据,并随新证据不断重新编译其意义。文章批评将向量数据库、知识图谱、上下文窗口等当作记忆的常见误解,认为它们只是从记忆编译出的临时表示。作者提出记忆编译产生三类产物:状态(按序折叠事件得到)、检索(查找相关证据的工具)和上下文(为单次调用组装的有界视图),并类比编译器的中间表示(IR),指出每种表示只适合特定操作,记忆本身应是唯一不可丢弃的持久层。

技术 › LLM Ashwin Gopinath 2026-09-0114.7 KB 9K 109 72

AI 记忆分数超过人类参考,这条新路线创业公司也能走

本文介绍了AI长期记忆领域的最新进展,重点分析了Alloomi公司在LongMemEval-S等评测中取得超过人类参考分的成绩。文章详细解读了其背后的技术路线——基于开源模型的自进化后训练流程,包括数据收集、质量筛选、专家锚定、后训练、评测准入和版本回滚等步骤。作者认为,这条路线降低了创业公司的门槛,将竞争焦点从算力转向数据和流程,为行业模型的发展提供了新思路。

技术 › LLM 产品经理老王霸 2026-08-1911.1 KB 17.4K 28 71

在 Obsidian 中创建你的第二个自我

本文介绍了如何将 Obsidian 从简单的笔记应用转变为 AI 可读写的记忆层,从而构建一个“第二个自我”系统。作者提出了双层记忆架构:一层为人类保留原始、混乱的思考,另一层为 AI 提供结构化、机器可读的上下文。文章详细展示了文件夹结构(如 00_inbox、01_self 等)以及五个核心提示词,用于将杂乱想法转化为笔记、生成每日记忆日志、更新项目记忆、创建决策记录以及向第二个自我提问。核心观点是:AI 的智能取决于其可访问的上下文,通过自动化笔记维护,Obsidian 能成为真正的工作记忆系统。

技术 › 工具与效率 kocer 2026-08-1513.9 KB 615.5K 199 80

AI 记得越多越好吗?我用 21 版旧稿做了次测试

作者用一篇修改过21次的旧稿测试了开源组件OpenContext,探讨AI长期记忆的核心问题:记住多少才算够?文章将AI长期记忆拆解为三层:记得住(Holistic Context)、学得会(Self-Evolving Agent)、做得成(真实交付),并分别对应OpenContext、后训练循环和benchmark评测。作者通过本地测试验证了消息写入、读取和版本标记功能,但语义搜索未配置。文章强调,AI记忆的关键不在于存储量,而在于理解信息的时效性、冲突和取代关系,并最终将经验转化为下一次交付的提升。

技术 › LLM 小墨同学 2026-08-1419.4 KB 75

防止AI失忆:3步搭建AI记忆系统

文章指出AI对话每次从零开始的核心问题在于缺乏有效的记忆系统。作者主张区分聊天记录与有效记忆,提出建立包含身份、项目和判断三层记忆的系统。通过构建简单的目录结构(如AGENTS.md、projects.md等),并利用Codex等工具读取和维护这些文件,可以降低维护成本,让AI获得上下文理解能力,从而提供更精准、个性化的建议。

技术 › 工具与效率 Rachel 2026-07-064.9 KB 28.1K 57

深度解析: Claude Code 51万行源码背后的5个炸裂发现

本文基于Anthropic误暴露的51万行Claude Code源码,深度解析了其背后的产品哲学。核心发现包括:通过四维记忆系统解决AI遗忘问题;Coordinator模式揭示了AI管理逻辑与人类管理的一致性;23道安全检查与YOLO分类器构建的安全体系;极致的Token缓存策略优化;以及KAIROS等未发布的隐藏功能。文章指出,Prompt和自然语言指令体系才是AI产品的真正护城河。

技术 › Claude Code 傅盛 2026-04-019.3 KB 19.2K 91 81

AI的记忆困境:当OpenClaw开始“遗忘”你的秘密

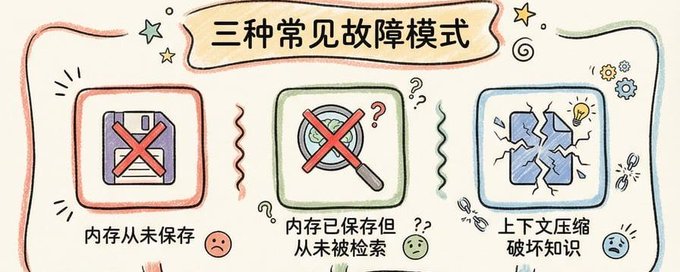
文章深入探讨了 2026 年 AI 在企业应用中面临的关键“记忆困境”。分析了 AI 因上下文窗口限制导致的“遗忘”现象、被遗忘数据的隐私流向风险,以及不同模型在处理长期记忆时的偏差。文章还介绍了信任评分机制、AI 记忆的分层架构(短期、长期、情节记忆),并针对 OpenClaw 等系统提出了具体的内存故障解决方案与风险治理策略,强调了在 AI 时代重建数据透明度与信任的重要性。

技术 › Agent Jason Zhu 2026-02-2217.3 KB 81