# 上下文压缩和记忆(nanobot😼)
**作者**: chengyongru
**日期**: 2026-09-07T09:15:23.000Z
**来源**: [https://x.com/chengyongru/status/2096890060893511873](https://x.com/chengyongru/status/2096890060893511873)
---
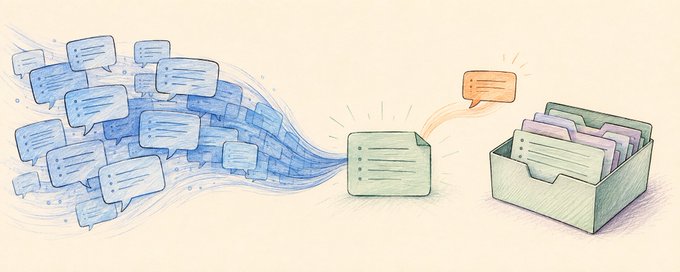
最近对 nanobot 的上下文压缩机制做了不少改动, 在这里稍作记录, 也顺便聊聊 nanobot 现在的长期记忆机制, 希望能对各位有所帮助, 如有错漏, 也欢迎批评指正.
不严谨地讲, 上下文可以看成一个消息列表, 大致长这样: system prompt + history messages + current turn messages
而且这些 messages 又是由 user/assistant/tool call/tool result 构成的. 对于 nanobot, system prompt 又可以粗略写成: system prompt = bootstraps + summary
有了以上定义, 上下文压缩就可以用一个很简单的公式来理解: new summary = compact(system prompt + history messages)
emm, 这里还是再定义清楚一点吧, nanobot 目前将已经作为请求输入发给模型的历史记作 H, 从未发过去的消息记作 Δ. 刚开始处理用户消息时, Δ 就是这条新消息; agent loop 中新产生的模型回复, tool call 和 tool result 也会进入 Δ. 随着下一次请求发出, 这些内容又会成为 H 的一部分(我觉得这还蛮符合直觉的🤔).
当输入达到上下文的 input budget 时, nanobot 压缩 H, 保留 Δ. 这个 input budget 就是上下文窗口扣掉安全余量.
新 summary 会替换 system prompt 里的旧 summary, 再接上保留的 Δ, 继续后面的对话. 为了方便理解, 这里我用 remotion 做了个简单的小动画😁. 读完文章后回头再看效果或许会更好一点(哦可恶的知识的诅咒)
<video controls preload="metadata" poster="/doc/6075/image/img_ce8089d3b6c4.jpg" src="/videos/0520.mp4"></video>
这里有个小 tricky需要稍作解释, 生成 summary 本身也要知道历史消息中的信息, 历史越长, 这次请求也就会越贵. nanobot 的做法是在 H 后面模拟用户发了一条消息, 大意是"请总结前面的对话, 保留接下来做事需要的信息". 两份请求就变成了这样:
普通请求: system prompt + H + Δ
摘要请求: system prompt + H + 总结指令
前面的 system prompt 和 H 保持原样, 工具定义也保持一致, 这样就给 KV cache 留下了复用的机会. 如果这里cache命中了, 就能节省一些时间和输入费用了.(如果各位发现 nanobot 这块有什可以改进, 可以随时提 issue💖.)
这里还有另外还有一种情况就是 有些provider 自己就有原生的上下文压缩, 比如 oai 的 responses API. 不过它返回的 compaction item 是加密的, nanobot 没法直接读取其中的内容. 所以 nanobot 在原生压缩后, 做了一个和普通摘要请求类似的操作, 也就是带着压缩后的 state 和原有系统指令, 再发一条总结指令, 让模型生成文本 summary.
之所以还要多拿一份文本 summary, 是因为 nanobot 的长期记忆生成也需要用到它, 摘要存起来, 后续 Dream 再结合已有记忆做筛选和整理.
这里的记忆其实留了很大的定制空间. 默认规则放在 `nanobot/templates/agent/` 下的两份提示词里: `consolidator_archive.md` 指导压缩时留下什么, `dream.md` 指导这些内容之后怎么整理成长期记忆. 目前 archive 的定制需要修改内置模板, 这算是个比较 geek 的入口. 如果你能找到并修改它, 那我觉得你是理解自己在做什么的. 而 dream 有个显式入口, `/dream-prompt init`, 就会在当前 agent 的 workspace 下生成一份 `prompts/dream.md`. 修改它就能覆盖当前工作区的默认 dream 规则.
比如希望它多记住项目决策和踩过的坑, 就可以调整 archive 的筛选标准, 希望它及时清掉过期的任务状态, 用新结论更新旧记忆, 就可以调整 Dream 的整理规则. 哪些属于用户偏好, 哪些是行为规则或项目知识, 哪些值得整理成 skill, 也可以在这里约定. 如果有人感兴趣后面我可以单独开一篇文章讲一讲(挖坑不埋系列), 这其中可玩性还是挺高的, 不知道各位怎么看?
参考:
[https://developers.openai.com/api/docs/guides/compaction](https://developers.openai.com/api/docs/guides/compaction)
## 相关链接
- [chengyongru](https://x.com/chengyongru)
- [@chengyongru](https://x.com/chengyongru)
- [https://developers.openai.com/api/docs/guides/compaction](https://developers.openai.com/api/docs/guides/compaction)
- [Upgrade to Premium](https://x.com/i/premium_sign_up)
- [5:15 PM · Sep 7, 2026](https://x.com/chengyongru/status/2096890060893511873)
- [4,094 Views](https://x.com/chengyongru/status/2096890060893511873/analytics)
- [View quotes](https://x.com/chengyongru/status/2096890060893511873/quotes)
---
*导出时间: 2026/9/7 20:40:09*