# AI 正在学会自我进化:递归自改进(RSI)的演进图谱与未来判断
**作者**: 木渡川
**日期**: 2026-09-21T06:27:23.000Z
**来源**: [https://x.com/tanglele0318/status/2101921213278777827](https://x.com/tanglele0318/status/2101921213278777827)
---
大模型技术正行至一个关键的范式拐点:决定系统上限的,已不再仅是“出厂时被灌注了多少知识”,而是“运行中能否把试错内化为自进化的能力”。
这一指向自驱动生长的演进主线,被统摄于 Recursive Self-Improvement(RSI,递归式自我改进) 的宏观框架之下。
透过繁复的概念迷雾,厘清 RSI 的演进图谱,正是看清下一代智能系统如何构筑自主生长飞轮的关键钥匙。
## 一、核心定义:什么是真正的 RSI?
1. 什么是 RSI?
> RSI(Recursive Self-Improvement,递归式自我改进):AI 系统在完成任务后,将获得的经验与反馈写回自身的持久化状态,使后续任务中的自身具备更优或更高效的执行表现;而更新后的状态及其沉淀的经验,又持续参与到再下一轮的改进循环中。
- 递归演进(Recursive):更新后的状态或沉淀的经验必须作为后续迭代的输入;其版本拓扑既可是线性链条,亦可是分支演化树、经验档案(Archive)或图结构,并非单纯由前一版本线性派生下一版本。
- 系统自指(Self):改进靶向直指系统自身的构成要素(模型参数、外部记忆、技能库、工具集或控制流调度)。
- 可验证性(Verifiable Improvement):能力的跃升需经由外部客观环境或基准测试严格检验,防范无实质收益的规则堆砌或自我幻觉。
2. 什么是 Dream-RSI?
Recursive Self-Improvement through Evolving Worlds:Google、Google DeepMind、马里兰大学与弗吉尼亚大学研究者于 2026 年提出的前沿研究框架。它固定底层的 discovery agent、模型、Evaluator 与执行接口不变,专门让 AI 的“探索与搜索策略(Exploration Policy)”实现递归式自我进化。
它通过将 AI 历史探索中的试错轨迹与成功分支结构化沉淀为“发现树”,并将其作为离线模拟器(Replay Simulator);新的搜索策略在这个模拟世界中“做梦复盘”,以显著低于在线重跑的成本评价并筛选更优策略,再部署到下一轮真实探索中。
3. Dream-RSI 在 RSI 宏观体系中的生态位
现代 Agent 系统可抽象为:
Agent = Model(基座大脑)+ Harness(工作台与控制流)
RSI 是总览性的技术范式与探索方向,而 Dream-RSI 则是这一范式在“元探索控制层”的具体前沿实证:
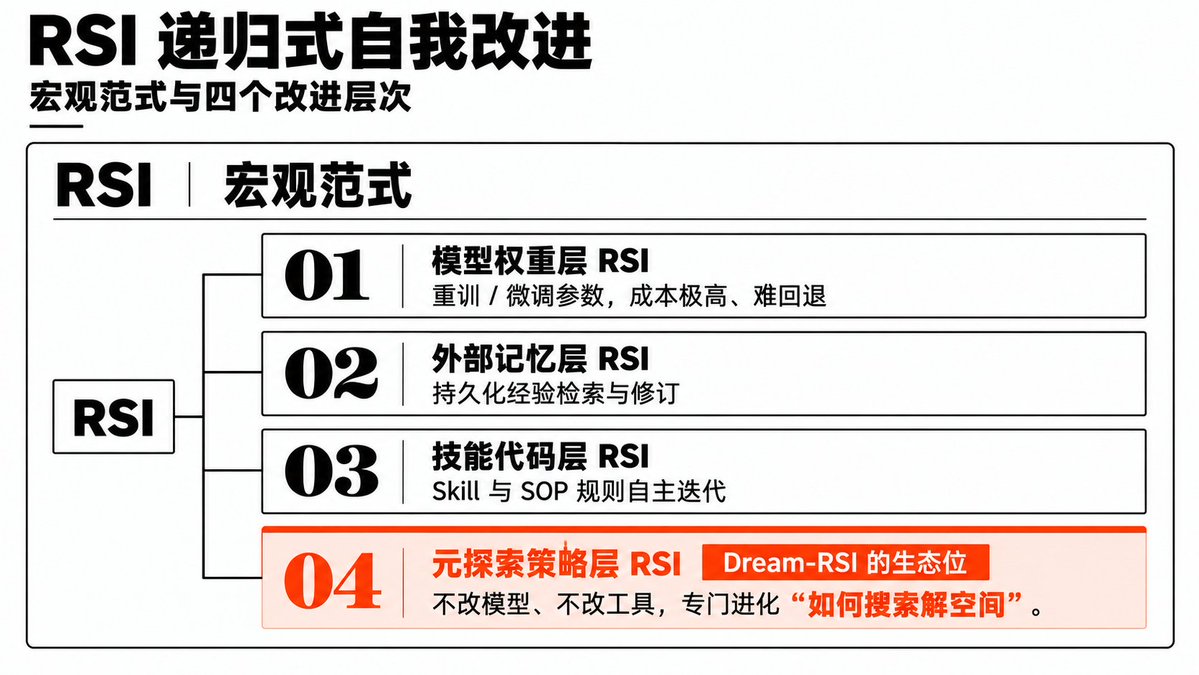
图1:RSI 宏观范式与四个改进层次
> Dream-RSI 提供了一组重要的工程证据,表明在这些可执行、可量化的科学发现与算子优化任务中:未必非要冒着破坏底座的风险去重训模型权重;优化 AI 调度资源与搜索方案的元策略,同样能在特定领域取得显著的效率与性能收益。
## 二、RSI 的演进时间轴:从理论假说到产业落地
1. 历史底色:从概念猜想到封闭自博弈(1965~2024)
在迎来近两年的工程爆发之前,RSI 经历了漫长的理论积淀与窄域闭环探索:
- –1965 年(理论奠基):I.J. Good 率先提出“智能爆炸”假说,经典阐释了“机器设计更聪明机器”可能诱发的递归级联效应。
- –2000s(数理奠基):Schmidhuber 构建“哥德尔机”(Gödel Machine)形式化框架,探讨系统在严密公理与效用函数下,仅当能以数理证明某项自修改具有更高预期效用时,方准许改写自身代码。
- –2017~2018 年(封闭自博弈前史):AlphaGo Zero 与 AlphaZero 证实了在规则完备、奖励明确、具备高保真模拟器的封闭环境中,自博弈可催生出极强的自主强化闭环;然而其优化目标与更新逻辑仍由人类预设,更宜定性为现代 RSI 的窄域技术序曲。
- –2023 年(语言反馈与情节记忆初探):Reflexion 开启了基于自然语言反馈与短期情节记忆的自省尝试;但其更新范围受制于单次试错轨迹与外部记忆缓存,尚未形成跨任务迁移、支持版本化管理的完整自改进系统。
2. 爆发突破:2025~2026 研究与产业合并时间线
自 2025 年始,RSI 的研究重心地面化,从单次试验的局部自省,全面挺进“自主改写系统代码、自适应参数微调与元探索策略演化”的硬核工程攻坚期:
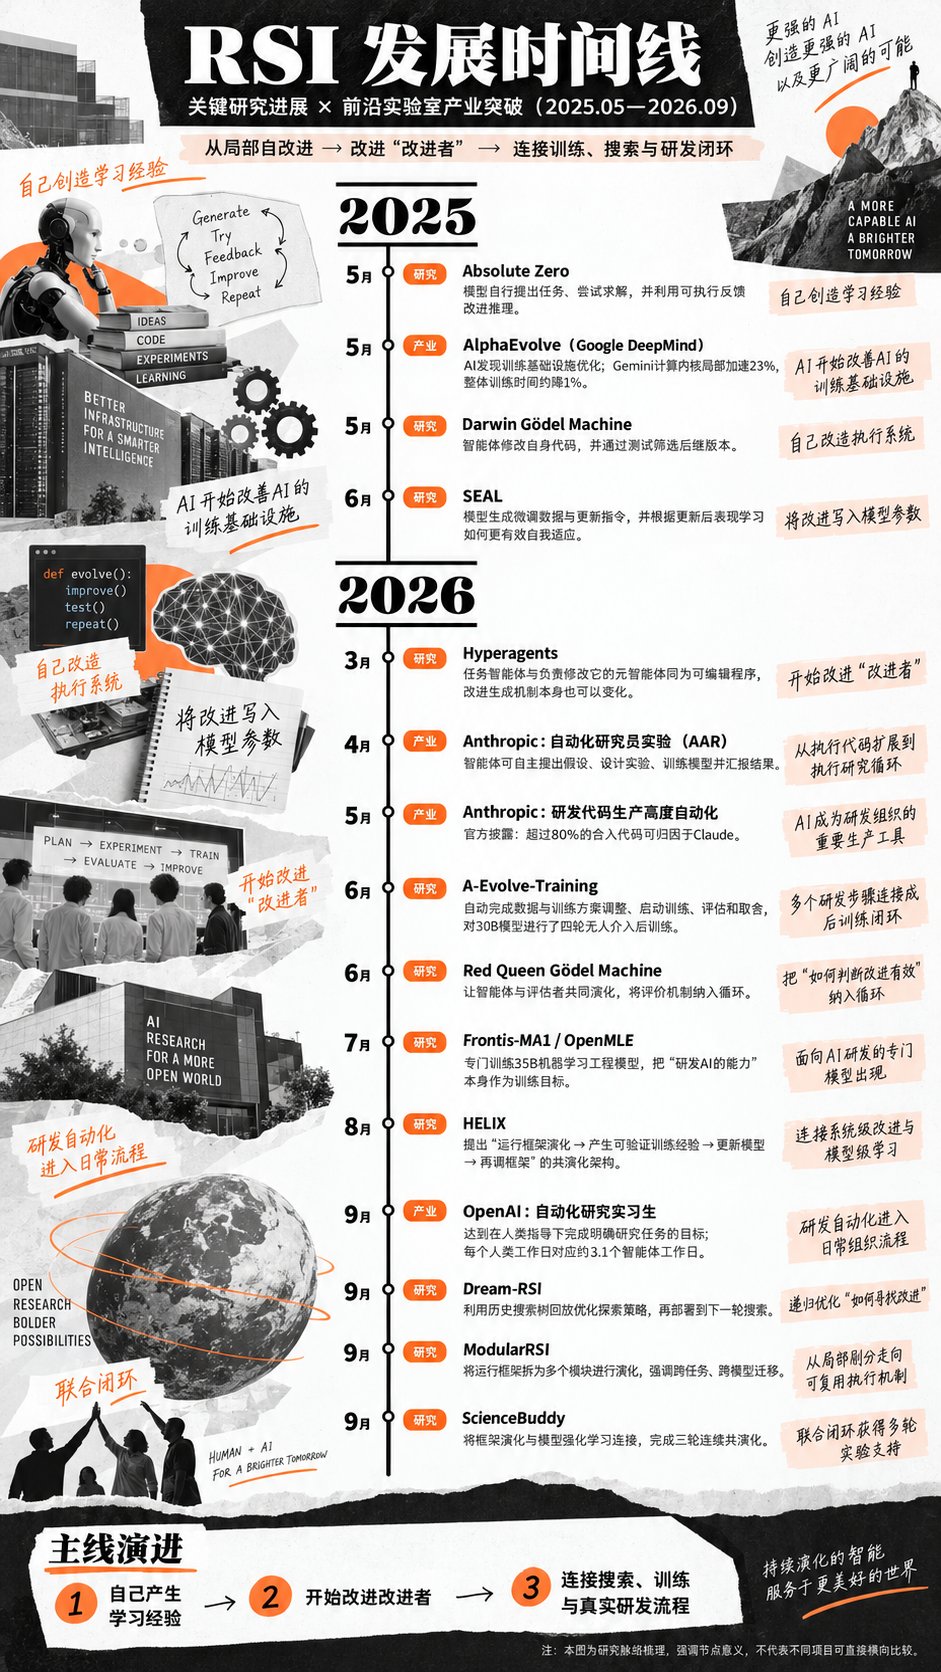
图2:RSI 发展时间线(2025.05–2026.09)
| 日期 | 属性与项目 | 主要进展 | RSI 意义与边界 |
| --- | --- | --- | --- |
| 2025-05-06 | 研究 · Absolute Zero | 模型自行提出任务、尝试解决,并利用代码执行反馈改进推理能力。 | 自己创造学习经验:其 RLVR 阶段不使用外部题库,但仍依赖预训练模型以及人类定义的任务空间、代码执行器与奖励机制。 |
| 2025-05-14 | 产业 · Google DeepMind:AlphaEvolve | AI 发现的优化使 Gemini 某个计算内核加速 23%,对应整体训练时间下降约 1%。 | AI 开始改善支撑 AI 训练的基础设施:形成实际研发反馈,但还不是自主研发下一代模型的完整闭环。 |
| 2025-05-29 | 研究 · Darwin Gödel Machine(DGM) | 智能体修改自身代码,通过测试筛选后继版本并保留演化档案;SWE-bench 解决率由 20% 提升至 50%。 | 自己改造执行系统:自改进从生成答案扩展到工具、上下文管理等智能体代码层,而非更新基础模型权重。 |
| 2025-06-12 | 研究 · SEAL | 模型生成自己的微调数据与更新指令,再根据更新后的表现学习如何更有效地自我适应。 | 把改进写入模型参数:不再仅依赖外部提示词或记忆,但实验仍处于受限的自适应任务中。 |
| 2026-03-19 | 研究 · Hyperagents | 把任务智能体与负责修改它的元智能体放入同一可编辑程序,使后续改进的生成机制也能动态变化并跨领域迁移。 | 从“改进自己”迈向“改进自己的改进方法”:这是理解递归元改进(Meta-RSI)的关键节点。 |
| 2026-04-14 | 实验室 · Anthropic:自动化对齐研究员(AAR,弱到强监督实验) | 智能体自主提出假设、设计实验、训练模型并分享结果,研究如何用较弱模型监督较强模型。 | 从执行代码扩展到执行研究循环:但研究问题与评分框架仍由人类确定,迁移到生产规模时尚未取得明确收益。 |
| 2026-05 | 产业 · Anthropic:研发代码高度自动化 | 官方披露,合入生产代码库的代码行中,超过 80% 可以归因于 Claude。 | AI 已成为自身研发组织的重要生产工具:代码贡献比例不等于研究自主化比例,但证实了研发辅助的深度。 |
| 2026-06-09 | 研究 · A-Evolve-Training | 自动完成数据与训练方案调整、启动训练、评估和结果取舍;对 30B 模型开展跨数周、四轮无人介入后训练。 | 把多个研发步骤连接成后训练闭环:“自动训练目标模型”迈出一大步,但仍不同于“新模型接手研发下一代自己”。 |
| 2026-06-24 | 研究 · Red Queen Gödel Machine(RQGM) | 让智能体与评估者共同演化:阶段内部保持评价标准稳定,阶段之间更新评价机制。 | 把“如何判断改进有效”纳入循环:评估不再被视为永远可靠的固定背景,引入动态对抗防止自欺欺人。 |
| 2026-07-30 | 研究 · Frontis-MA1 / OpenMLE | 专门训练一个 35B 机器学习工程模型,学习起草、改进、调试和交叉组合,并开放训练与搜索系统。 | 把“研发 AI 的能力”作为专门训练目标:从通用模型临时做研究,走向面向 AI 研发的专门模型与环境。 |
| 2026-08-14 | 研究 · HELIX | 提出“运行框架演化 → 产生可验证训练经验 → 更新模型 → 再调整框架”的共演化架构。 | 连接系统级改进与模型级学习:提出并搭建可审计接口,探索连接运行框架演化与模型训练数据生成(公开实验主要验证了一轮框架演化)。 |
| 2026-09-06 | 产业 · OpenAI:自动化研究实习生 | 披露智能体可在人类指导下完成熟练研究者数天的工作;截至 8 月中旬,智能体运行量达每个人类工作日对应 3.1 个智能体工作日。 | 研发自动化从单项工具走向日常组织流程:表明编码智能体已成为研究组织中的规模化计算与执行资源,但这一运行量比例不能直接等同于研发速度或生产率提升。 |
| 2026-09-14 | 研究 · Dream-RSI | 将历史搜索树构造成回放环境,在其中优化探索策略,再部署到下一轮实际搜索;底层编码智能体保持不变。 | 递归优化“如何寻找改进”:着力点从改好单个候选,转向在固定底座上以显著低于在线重跑的评价成本优化元搜索与资源调度策略。 |
| 2026-09-14 | 研究 · ModularRSI | 将运行框架拆成五类模块,利用与评测隔离的任务演化,并验证跨任务、跨基础模型的泛化能力。 | 从局部刷分走向可复用的执行机制:重点解决自进化的泛化性与模块化;实验显示,演化所得的 Harness 机制能够在所测试的不同基础模型之间迁移。 |
| 2026-09-15 | 研究 · ScienceBuddy | 将框架演化与模型强化学习连接,实现三个连续共演化循环;科学任务单次测试准确率由 42.2% 提升至 73.3%。 | 联合闭环获得多轮实验支持:为框架演化与模型参数学习的多轮共演化提供了初步实验支持。 |
3. 历程提炼:走向真正 RSI 的“三个关键转折”
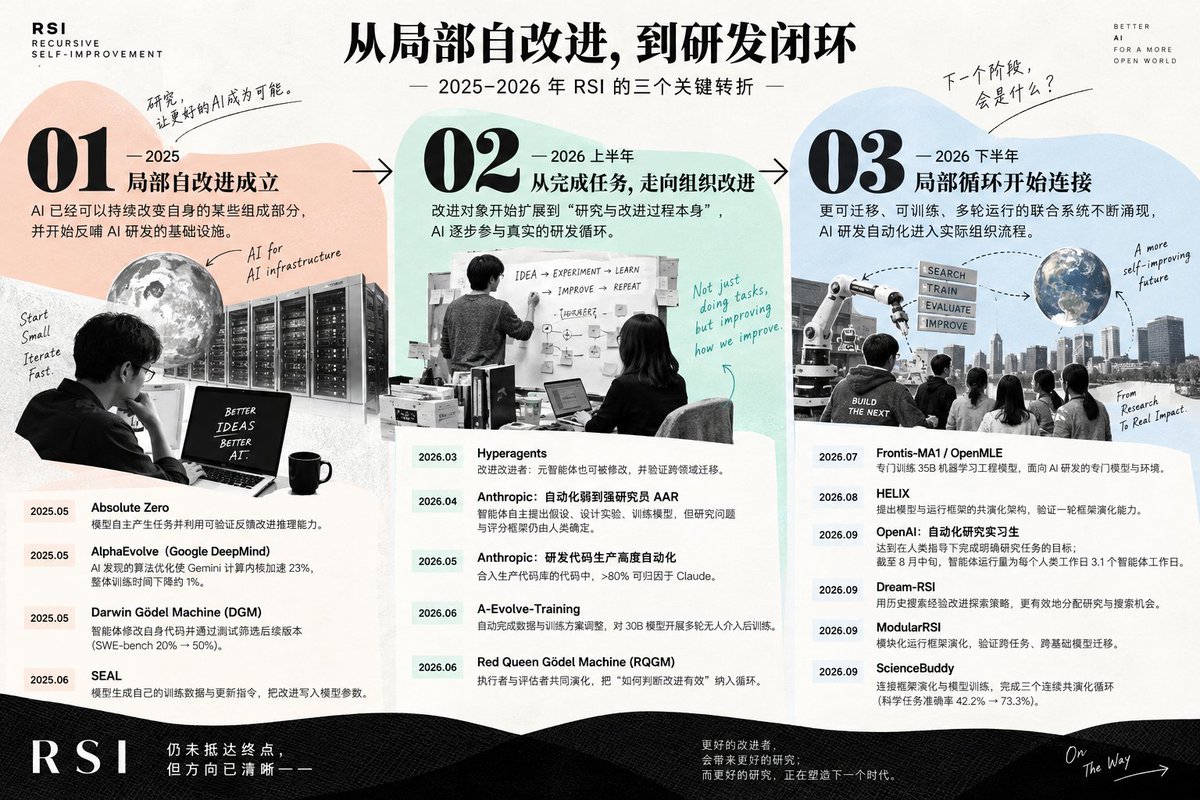
图3:走向真正 RSI 的三个关键转折
> 纵览 2025 至 2026 年的技术脉络,整个演进谱系可凝练为三次标志性转折:
1. 转折 ①|2025 年:验证“局部自改进工程可行”Absolute Zero 造学习样本,DGM 改写自身代码,SEAL 试水参数更新,AlphaEvolve 调优算子。不同层级的自改进相继跑通,证实局部优化可行,但仍呈离散状态。
2. 转折 ②|2026 年上半年:改进靶向跃升至“改进机制本身”Hyperagents 优化元修改器,A-Evolve 贯通后训练,RQGM 引入动态共演化对抗。核心焦点从“完成任务”升华为“产生、评估与筛选改进的方法本身变成代码”。
3. 转折 ③|2026 年下半年:构建“高迁移、多轮迭代”的联合系统Frontis-MA1 专项训练工程能力,Dream-RSI 演化元探索策略,ModularRSI 跨基座迁移,HELIX 与 ScienceBuddy 连接框架与模型共演化。局部循环开始紧密咬合。
自主生成经验与代码 ➔ 递归优化改进方案与评测机制 ➔ 深度咬合搜索、训练与实战研发流程
必须清醒指出:
当前实证已强力支撑多种受控环境下的局部自改进与有限多轮闭环;
然而真正具有划时代意义的分水岭,依然在于演化后的系统能否彻底脱离人类干预,在严密独立的评估体系与真实算力成本核算下,持续、可靠地接盘下一代系统的研发演化。
## 三、进化解构:哪些层面可以被“自我改进”?
RSI 绝非窄化的“重训模型参数”;外围的 Harness、记忆与元探索策略,往往更具工程可控性。
立足于可被持久化沉淀与版本化管理的工程构件,当下的自改进实践可清晰解构为五类进化对象:
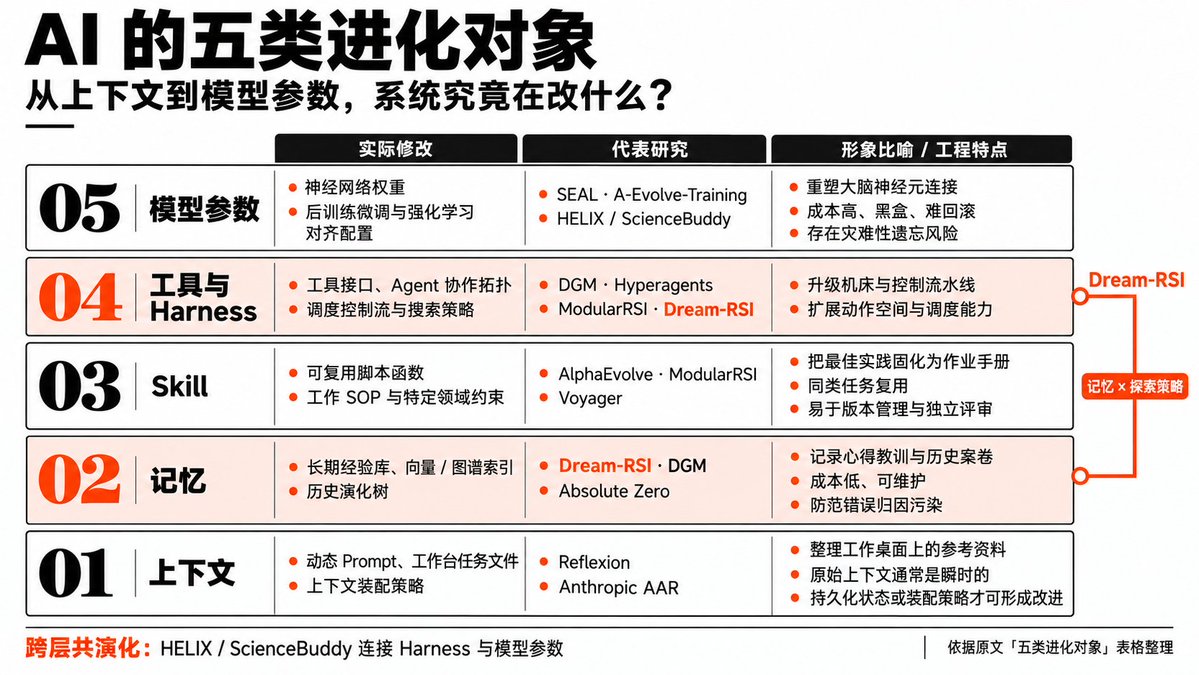
图4:AI 的五类进化对象
| 进化对象 | 实际修改什么 | 代表性研究 | 形象比方 | 工程现实 |
| --- | --- | --- | --- | --- |
| ① 模型参数 | 神经网络权重、后训练微调与强化学习对齐配置 | SEAL(参数自适应更新)、A-Evolve-Training(无人值守后训练)、HELIX / ScienceBuddy(模型-框架共演化) | 重构大脑神经元连接与突触权重 | 训练与对齐开销极高,归因黑盒且难以精细回滚,易诱发灾难性遗忘 |
| ② 工具与 Harness | 工具接口、Agent 协作拓扑、调度控制流与搜索策略 | DGM(自改执行代码)、Hyperagents(元智能体自修改)、ModularRSI(模块化框架)、Dream-RSI(探索与调度策略演化) | 重构流水线上的机床工装与控制中枢 | 能力跃迁——直接重塑动作空间与协同拓扑,突破静态提示词的上限 |
| ③ Skill | 可复用的脚本函数、工作 SOP、特定领域约束 | AlphaEvolve(计算内核与算法库优化)、ModularRSI(模块化任务技能)、Voyager(代码技能库累积) | 将领域最佳实践沉淀为标准操作规程(SOP) | 工程性价比极高——同质任务即插即用,天然支持版本追踪与确定性测试 |
| ④ 记忆 | 外部长期经验库、向量/图谱索引、历史演化树 | Dream-RSI(“发现树/经验世界”回放模拟器)、DGM(演化历史档案库 Archive)、Absolute Zero(自产经验) | 沉淀于结构化档案库中的长效经验卷宗 | 维护成本低、可溯源;但需构筑防御屏障以防错误归因污染记忆库 |
| ⑤ 上下文 | 动态 Prompt、工作台任务文件、上下文装配策略 | Reflexion(语言自我反思与试验上下文)、Anthropic AAR(试验计划书与动态工作台流) | 动态调配工作台面上的即时任务拼装 | 原始上下文通常随会话湮灭;但若其构造策略、任务元数据与装配管线被持久化固化,即可构成上下文维度的自改进 |
💡 跨层共演化现象:前沿探索正呈现出强烈的“跨层结合”趋势:
•Dream-RSI:横跨记忆层(将探索沉淀为“经验世界/发现树”)与Harness/元策略层(专门演化解空间的搜索与探索策略);
•HELIX / ScienceBuddy:横跨Harness 控制层与模型参数层,探索运行框架演化与模型参数学习的联合共演化。
## 四、最小工程闭环:自改进是如何发生的?
摆脱概念虚浮,系统必须构筑持久化、可审计、可验证、可回滚的工程飞轮,彻底告别“会话终了即重置”。
1. 推荐的高严谨度工程闭环
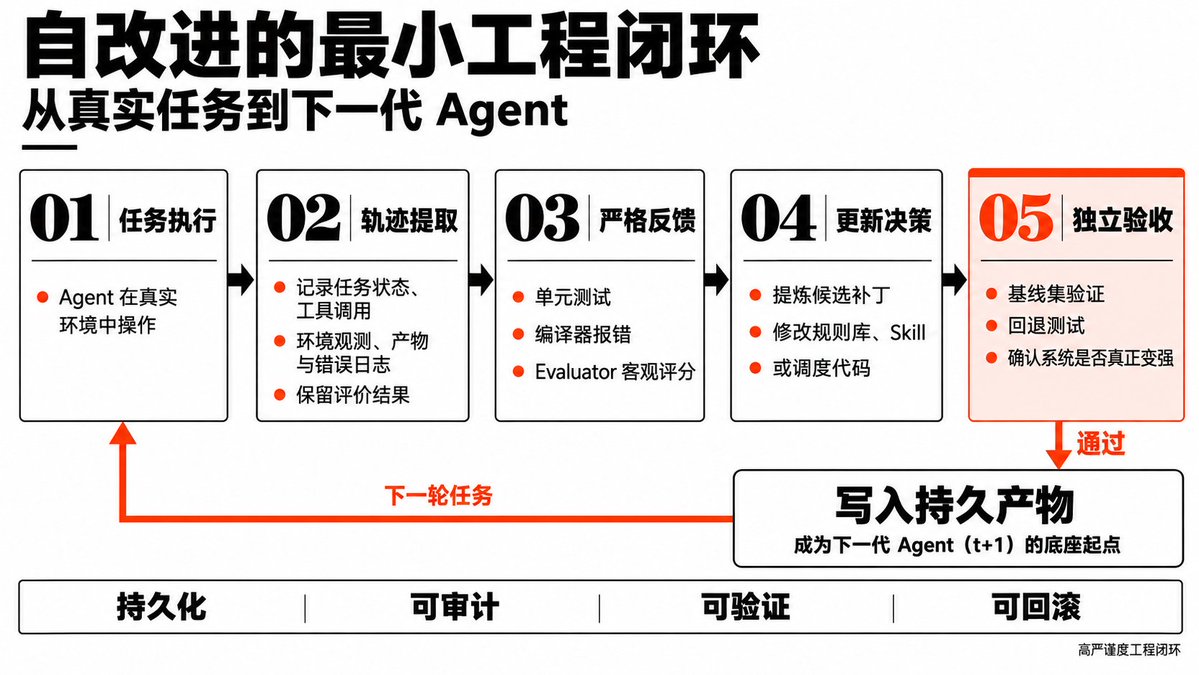
图5:自改进的最小工程闭环
1. 真实环境试错执行:
Agent 在真实或受控环境中调用工具,实际完成研发或优化操作。
2. 全轨迹无损捕获:
忠实提取任务状态、观测日志、生成产物、耗时与计算开销。
3. 严格客观反馈:
由客观编译器、独立单元测试或高置信 Evaluator 给出评分,拒绝含噪主观评判。
4. 提炼补丁决策:
针对归因点修补系统,生成针对规则、Skill 代码或控制流策略的更新补丁。
5. 独立沙盒验收:
新版本在隔离基线集与防回归测试中通过考核后,正式合入持久化状态,成为下一代起点。
2. 具象实证:Dream-RSI 的“在线探索-离线做梦”双相闭环
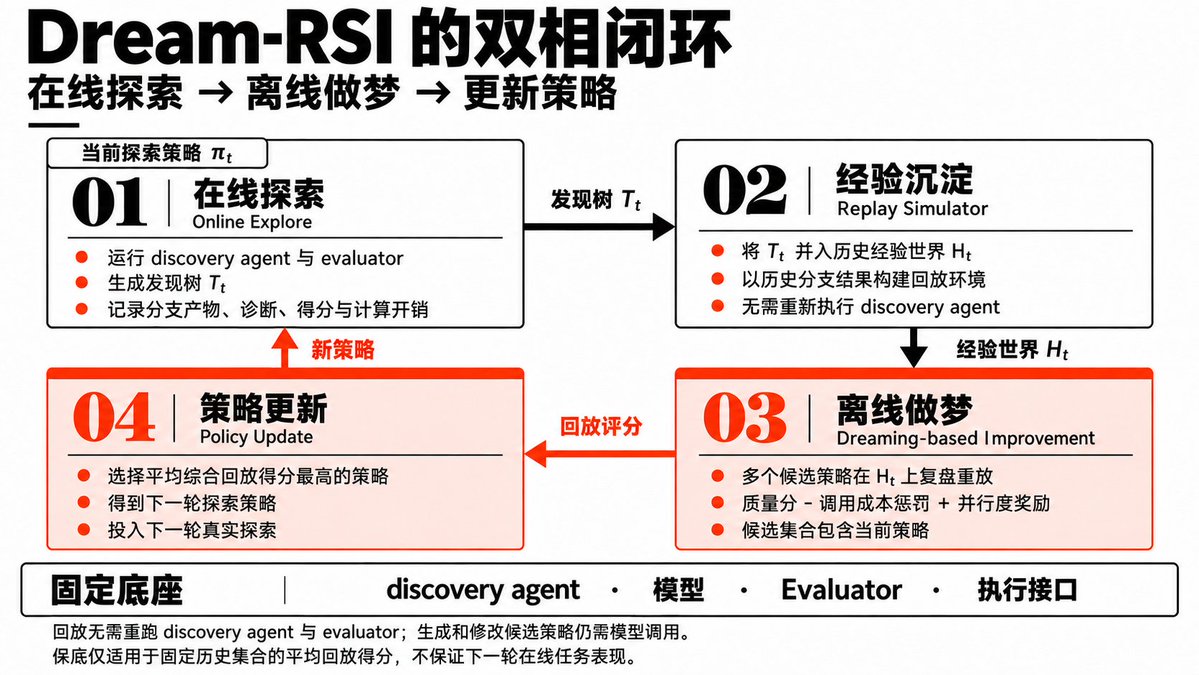
图6:Dream-RSI 的双相闭环
在元探索策略的进化上,Dream-RSI 给出了极具启发性的“双相飞轮”机制:
- –Phase 1 在线探索(Online Explore):在线执行产生发现树,完整记录分支结果、耗时与成本。
- –Phase 2 经验沉淀(Replay Simulator):将发现树并入历史经验世界,作为后续离线重放环境。
- –Phase 3 离线做梦(Dreaming-based Improvement):多个候选策略在历史世界上高速复盘重放,计算综合评分(质量分 − 步数惩罚 + 并行奖励)。
- –策略安全更新:选出平均综合回放得分最高的新策略(包含原策略保底,确保旧历史上“非退化”),投入下一轮真实探索。
工程智慧:候选策略历史回放无需重新调用昂贵的底层大模型与评估器,验证成本接近纯回放;通过把探索足迹升华为“经验世界”,实现了高性价比的闭环策略筛选。
## 五、当前与未来 RSI 发展的初步判断
1. 对当前现状的判断
- –非参数化外围演化是当前最具可操作性的落地主线:相比直接重训底座权重,外围解耦(记忆、Skill、Harness 与元探索策略)更易观测、测试与回滚,避开了灾难性遗忘的刚性阻碍。
- –验证器(Evaluator)质量构成系统刚性瓶颈:AI 生成候选方案日趋成熟,但准确、无偏地判定方案好坏极难。缺乏严格评测套件,伪正向信号会导致系统递归退化。
- –现存完整闭环实证严格限定于“受控与确定性领域”:如代码、算子优化、数学、受控科学任务等强验证场景;生产级端到端自主研发仍需人类专家定义目标与裁决。
2. 对未来发展的判断
- –“外围高频迭代 + 权重低频蒸馏”的双层架构将成主流范式:日常任务动态演化工作流与搜索策略;累积大量高质量高保真轨迹后,再定期触发模型权重的离线蒸馏微调。
- –元探索与算子调优将加速迈向全自主接管:在芯片编译、Kernel 编写等确定指标领域,具备自省能力的 RSI Agent 将成为主流基础设施。
- –“更新护栏与防毒化机制”将沉淀为顶级工程壁垒:防范策略漂移、记忆毒化、作弊刷分,建立严格的读写分离与沙盒缓冲机制,是工业级系统的分水岭。
## 六、RSI 不是魔法:四个清醒工程认知
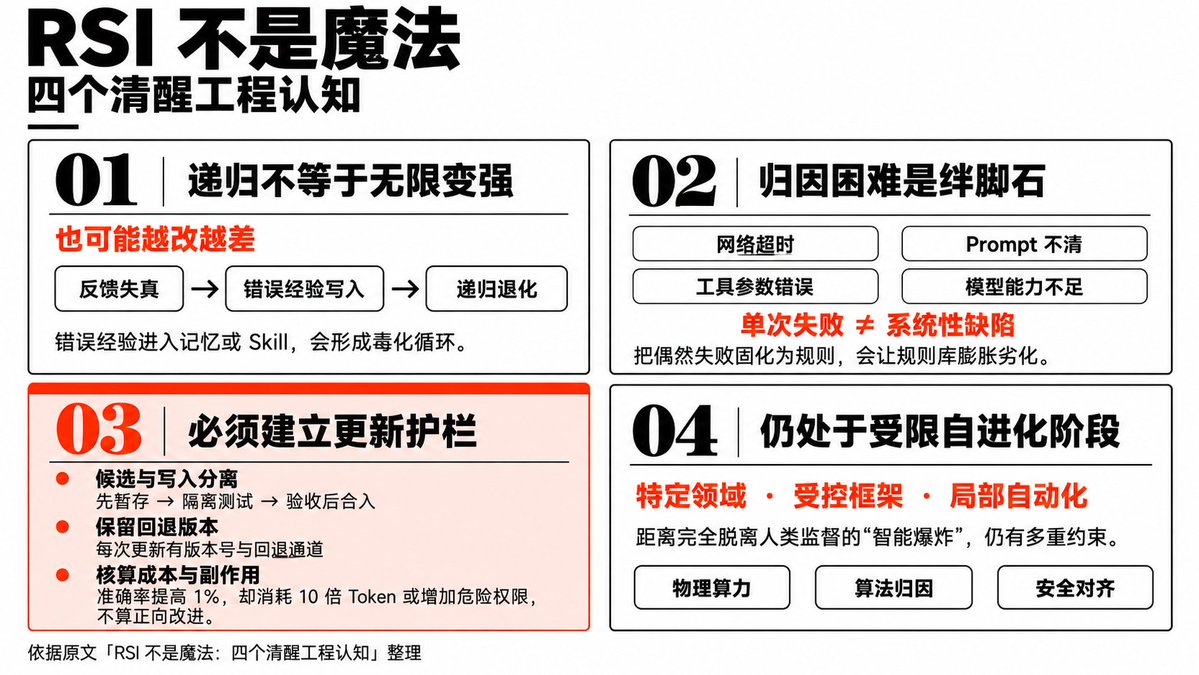
图7:RSI 不是魔法:四个清醒工程认知
1. 警惕递归性能力衰退(递归不等于单调变强):反馈信号若失真,瑕疵经验被写入系统,会沿着错误梯度负向级联,越改越偏。
2. 错误归因构成最大工程阻碍:单次任务失败可能源于网络超时或偶发扰动;若粗暴固化为全局规则,将迅速引发规则库急剧劣化。
3. 构筑严密的工程更新护栏:新经验与补丁必须坚持“读写分离与沙盒缓冲”,全量版本哈希追踪,并将全周期边际算力成本纳入裁决。
4. 恪守客观阶段定位:当下的 RSI 依然是“受控框架内的局部自适应迭代”,距离完全脱离人类监督的奇点,横亘着算力物理上限与价值对齐安全网等多重刚性约束。
## 结语:为什么每个人都该关注 RSI?
过去的软件,以静态逻辑固化人类规则,全赖人工维护; 现在的模型,以概率推理响应用户指令,终归无状态闭环; 而在 RSI 的范式下,系统真正具备了将行动经验内化为运行状态的能力——从被动触发的单次响应者,进化为可沉淀、可自愈、可持续变强的自适应系统。
理解 RSI,就理解了智能体从“一次性任务工具”,走向“能把试错转化为系统资产的资深专家”的质变逻辑。
## 参考文献
1. Good, I. J. (1965). Speculations Concerning the First Ultraintelligent Machine. Advances in Computers, 6, 31-88.
2. Schmidhuber, J. (2007). Gödel Machines: Fully Self-Referential Optimal Universal Self-Improvers. Artificial General Intelligence, 199-226.
3. Silver, D., Hubert, T., Schrittwieser, J., et al. (2018). A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play. Science, 362(6419), 1140-1144.
4. Zhao, A., Wu, Y., Yue, Y., et al. (2025). Absolute Zero: Reinforced Self-play Reasoning with Zero Data. arXiv:2505.03335.
5. Google DeepMind. (2025, May 14). AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms. Google DeepMind Official Blog.
6. Zhang, J., Hu, S., Lu, C., Lange, R., & Clune, J. (2025). Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents. ICLR 2026, arXiv:2505.22954.
7. Zweiger, A., Pari, J., Guo, H., et al. (2025). Self-Adapting Language Models (SEAL). NeurIPS 2025, arXiv:2506.10943.
8. Zhang, J., Zhao, B., Yang, W., et al. (2026). Hyperagents. arXiv:2603.19461.
9. Anthropic. (2026, April 14). Automated Alignment Researchers. Anthropic News;Wen, J., Qiu, L., Benton, J., Kirchner, J. H., & Leike, J. (2026). Automated Weak-to-Strong Researcher. Anthropic Alignment Science Blog.
10. Anthropic Institute. (2026). When AI builds itself: Our progress toward recursive self-improvement, and its implications. Anthropic Institute.
11. Shi, Z., He, B., Sang, Y., Dumoulin, B., & Lu, H. (2026). A-Evolve-Training: Autonomous Post-Training of a 30B Model. arXiv:2606.20657.
12. Iacob, A., Jovanović, A., Shen, W. F., et al. (2026). The Red Queen Gödel Machine: Co-Evolving Agents and Their Evaluators. arXiv:2606.26294.
13. Yang, J., Jiang, C., Fu, Y., et al. (2026). Frontis-MA1: Training an AI4AI Model towards Recursive Self-Improvement in Machine Learning Engineering. arXiv:2607.28568.
14. Fan, T., & Huang, C. (2026). HELIX: Model-Harness Co-evolution for Recursive Self-Improvement. arXiv:2608.13951.
15. OpenAI. (2026, September 6). Research acceleration: The view inside OpenAI. OpenAI Research.
16. Zheng, T., Wu, X., Zhang, Z., et al. (2026). Dream-RSI: Recursive Self-Improvement through Evolving Worlds. arXiv:2609.14858.
17. Wu, S., Ren, J., Li, Y., et al. (2026). ModularRSI: Modular and Generalizable Recursive Harness Self-Improvement. arXiv:2609.14857.
18. Xue, S., et al. (2026). ScienceBuddy: Recursive-in-Recursive Self-Improvement for Interactive Scientific Agents. arXiv:2609.17523.
19. Prism-Shadow. (2026). Awesome RSI: A Curated Collection of Recursive Self-Improvement Benchmarks and Methods. GitHub Repository: [https://github.com/prism-shadow/awesome-rsi](https://github.com/prism-shadow/awesome-rsi)(开源社区文献与资源索引)。
20. Silver, D., Schrittwieser, J., Simonyan, K., et al. (2017). Mastering the game of Go without human knowledge. Nature, 550, 354-359.
21. Shinn, N., Cassano, F., Gopinath, A., Narasimhan, K., & Yao, S. (2023). Reflexion: Language Agents with Verbal Reinforcement Learning. NeurIPS 2023.
## 相关链接
- [木渡川](https://x.com/tanglele0318)
- [@tanglele0318](https://x.com/tanglele0318)
- [592](https://x.com/tanglele0318/status/2101921213278777827/analytics)
- [https://github.com/prism-shadow/awesome-rsi](https://github.com/prism-shadow/awesome-rsi)
- [Upgrade to Premium](https://x.com/i/premium_sign_up)
- [2:27 PM · Sep 21, 2026](https://x.com/tanglele0318/status/2101921213278777827)
- [592 Views](https://x.com/tanglele0318/status/2101921213278777827/analytics)
---
*导出时间: 2026/9/21 17:12:44*