Wiki 知识库

全部文档 / 作者: Avi Chawla / 标签: 性能优化

4 篇
清除

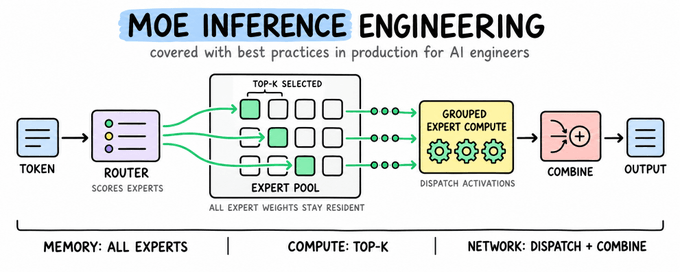
MoE 推理工程详解

本文系统讲解 MoE(混合专家)模型的推理服务工程原理。从稠密 Transformer 的 FFN 与 MoE 层的区别入手,介绍路由器如何为每个 token 选择专家、dispatch 和 combine 过程如何将路由决策聚合成专家专属矩阵,以及 grouped GEMM 如何减少内核启动开销。文章还涵盖专家并行、拓扑感知部署、显存需求(常驻参数 vs 激活参数)、负载不均衡、容量限制和量化等话题,并分析计算、显存带宽与互连流量之间的性能瓶颈权衡,以 Qwen3-30B-A3B 为实例说明。

技术 › LLM Avi Chawla 2026-09-1929.1 KB 148.8K 316 73

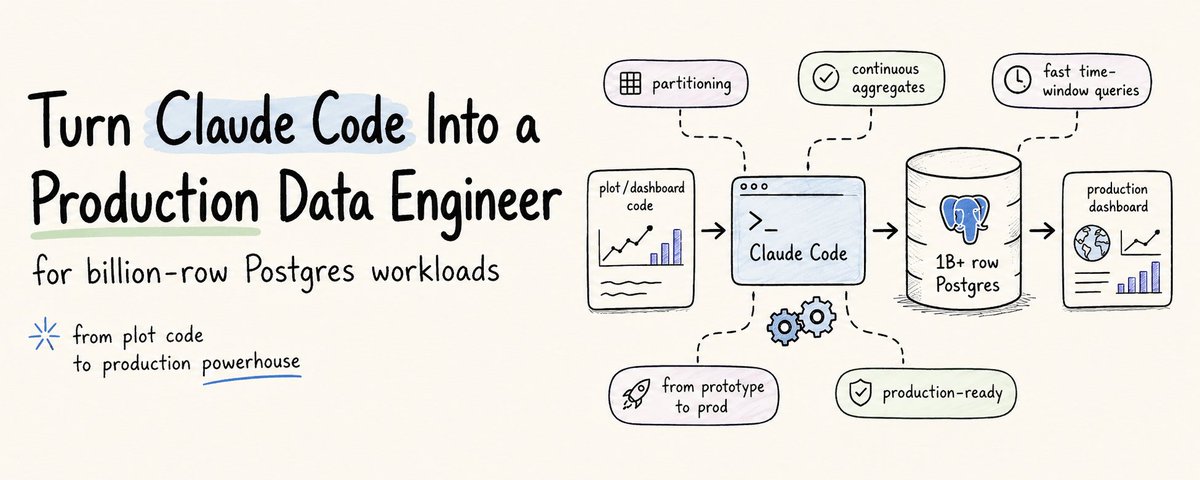
How To Turn Claude Code Into A Production Data Engineer On Billion-row Postgres Workloads

本文探讨了Postgres在处理数十亿行时间序列数据时遇到的性能瓶颈,以及如何通过Tiger Cloud(基于TimescaleDB的托管服务)解决这些问题。文章以Cloudflare团队的经历为例,展示了他们花费两年时间手动构建分区管理和聚合管道,最终迁移到TimescaleDB将查询速度提升35倍。作者演示了如何使用Tiger CLI作为MCP服务器,让Claude Code直接管理数据库基础设施,并构建了一个实时地震仪表盘。通过自动时间分区、连续聚合和压缩功能,Tiger Cloud简化了数据工程工作,使开发者能专注于应用开发。

技术 › 数据库 Avi Chawla 2026-08-129.1 KB 70.5K 49 71

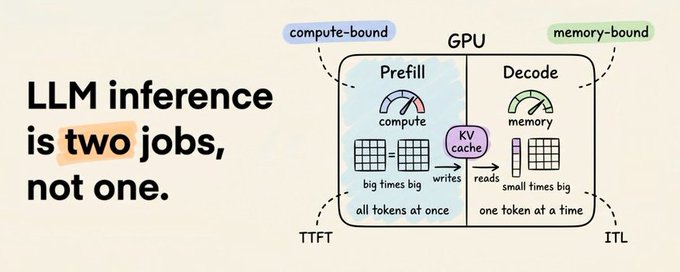
LLM 推理原理详解:从 Prefill 到 Decode

本文深入解析了大语言模型(LLM)推理的计算流程。文章指出,LLM 推理主要包含 Prefill(处理提示词,计算密集型)和 Decode(逐词生成,显存带宽密集型)两个阶段。作者详细阐述了分词、Embedding、Transformer 层及 KV Cache 的工作原理,并分析了 KV Cache 带来的内存挑战及 vLLM 的优化方案。最后,探讨了 DeepSeek-V4 等新架构通过重新设计注意力机制来从根本上压缩 KV Cache 的创新思路。

技术 › LLM Avi Chawla 2026-06-2923.7 KB 320.3K 776

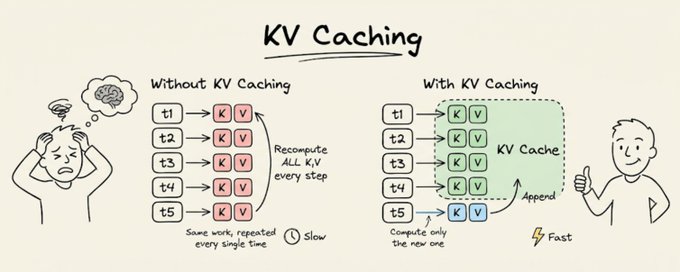
LLM 中的 KV 缓存机制详解

文章深入解释了大型语言模型(LLM)中的 KV 缓存技术。作者指出,LLM 生成文本时首个令牌较慢而后续令牌迅速的现象,归功于 KV 缓存的工程优化。该技术通过存储已计算键值向量,避免在自回归生成过程中的冗余计算,以 GPU 内存为代价换取显著的计算加速。文中详细解析了注意力机制的冗余问题、KV 缓存的工作原理、首令牌延迟(TTFT)的产生原因,以及内存与计算资源之间的权衡取舍。

技术 › LLM Avi Chawla 2026-03-226.3 KB 1.8M 2.9K 69